
1. Microdati, evidenze empiriche e domande causali
L'analisi econometrica trasforma le osservazioni su persone, famiglie, imprese e altre unità individuali in evidenze sulle relazioni economiche. La sua sfida centrale non consiste soltanto nel calcolare una correlazione o adattare una retta ai dati. Consiste nello stabilire che cosa significhi un confronto, quale spiegazione sostenga e quali spiegazioni alternative rimangano possibili. Un dataset di grandi dimensioni può descrivere il mondo in modo molto dettagliato e, al tempo stesso, fornire una risposta fuorviante a una domanda causale.
Che cosa rivelano i microdati
I microdati registrano informazioni a livello di singole unità di osservazione. Un'indagine sulle famiglie può descrivere reddito, istruzione, occupazione e copertura assicurativa; un dataset di imprese può riportare produzione, investimenti e occupazione; un dataset scolastico può collegare i risultati degli studenti alle risorse e alle caratteristiche locali. Il prefisso «micro» identifica il livello di osservazione, non la dimensione del dataset. Milioni di registrazioni individuali sono comunque microdati, mentre una breve serie di valori della produzione nazionale descrive un aggregato.
L'unità di osservazione deve essere coerente con la domanda. Una relazione tra reddito medio e salute osservata tra regioni non descrive necessariamente la relazione tra reddito individuale e salute individuale all'interno di ciascuna regione. L'aggregazione modifica sia il confronto sia le informazioni disponibili. Analogamente, una media riferita a un distretto scolastico non può rivelare tutte le differenze tra gli studenti al suo interno. Prima di stimare un modello, occorre individuare che cosa rappresenti ciascuna riga, come le osservazioni entrino nel dataset e quale popolazione intendano rappresentare.
I governi utilizzano questi dati per valutare le politiche, le imprese per comprendere la domanda e le organizzazioni senza scopo di lucro per valutare gli interventi. Ogni applicazione richiede di stabilire quale sia il risultato rilevante. Un programma può aumentare la partecipazione senza migliorare i risultati finali, oppure migliorare una media lasciando gruppi importanti in condizioni peggiori. Definire accuratamente le variabili e i confronti è quindi parte sostanziale dell'analisi.
Disponibilità e qualità dei dati
L'accesso ai dati non garantisce evidenze affidabili. Possono sorgere errori perché una variabile è registrata in modo scorretto, il campione esclude persone rilevanti, le definizioni cambiano nel tempo oppure le registrazioni vengono collegate mediante identificativi imperfetti. Un reddito mancante, per esempio, non equivale a un reddito pari a zero. Se le persone con redditi insolitamente elevati hanno maggiori probabilità di non rispondere alla relativa domanda, eliminare le osservazioni incomplete può modificare la popolazione rappresentata dall'analisi.
La misurazione merita particolare attenzione perché molti concetti sono rappresentati da indicatori indiretti imperfetti. Il punteggio di un test misura la prestazione in una specifica prova, non ogni dimensione dell'apprendimento. Un indicatore assicurativo registra la copertura, non la qualità o l'accessibilità delle cure. Un'analisi utile spiega la relazione tra il concetto di interesse e la misura disponibile, verifica la codifica e le unità di misura e considera come i limiti della misurazione possano influenzare le conclusioni.
La qualità dei dati comprende anche la storia della loro raccolta. Archivi amministrativi, indagini e dati sperimentali sono prodotti per scopi diversi e presentano punti di forza differenti. I dati amministrativi possono offrire un'ampia copertura, ma omettere variabili necessarie per un confronto causale. Un'indagine dettagliata può misurare tali variabili, ma risentire della mancata risposta. Un maggior numero di osservazioni migliora la precisione in condizioni appropriate; non corregge automaticamente un campione non rappresentativo o una definizione fuorviante.
Correlazione e causalità
Due variabili sono correlate quando variano insieme in senso statistico. La causalità pone una domanda diversa: modificare una variabile modificherebbe anche l'altra? La distinzione è essenziale perché una correlazione può derivare da diversi meccanismi: una variabile può influenzare l'altra, la direzione dell'influenza può essere inversa, un terzo fattore può influenzarle entrambe oppure la relazione può verificarsi per caso.
Un esempio volutamente sorprendente accosta la spesa statunitense per scienza, spazio e tecnologia ai decessi per impiccagione, strangolamento e soffocamento nel periodo 1999–2009. Le due serie si muovono insieme nel periodo rappresentato, ma ciò non dimostra che una variazione della spesa scientifica modifichi quei decessi. Serie caratterizzate da una tendenza possono apparire strettamente collegate anche quando nessun meccanismo causale credibile le connette. Scegliere una coppia interessante dopo aver esaminato molte serie rende particolarmente facile trovare coincidenze di questo tipo.
Anche le relazioni più plausibili richiedono lo stesso esame critico. Le persone assicurate possono essere più sane di quelle non assicurate perché l'assicurazione migliora l'accesso alle cure. Possono però differire anche per reddito, istruzione, occupazione e salute iniziale. Un confronto della salute osservata combina queste possibilità. Per isolare un effetto dell'assicurazione, l'analisi deve giustificare perché il confronto rappresenti ciò che accadrebbe a persone altrimenti comparabili in condizioni assicurative diverse.
Un'affermazione causale contiene quindi un controfattuale: che cosa sarebbe accaduto in assenza del cambiamento studiato? Il controfattuale è generalmente inosservato. Il disegno di ricerca specifica come altre osservazioni possano fornirne un sostituto credibile.
Descrizione, previsione e intervento
L'analisi descrittiva caratterizza i dati osservati: medie, distribuzioni, differenze tra gruppi e variazioni nel tempo. L'analisi predittiva si chiede quanto bene le informazioni disponibili prevedano un risultato in osservazioni non utilizzate per stimare il modello. L'analisi causale si chiede come un intervento modifichi un risultato. Si tratta di obiettivi diversi, anche quando si utilizzano strumenti statistici simili.
Un esempio storico illustra la distinzione. Un articolo del 2012 descriveva la piattaforma di viaggi Orbitz come un servizio che presentava opzioni alberghiere più costose agli utenti Mac, dopo aver rilevato che tendevano a spendere più degli utenti Windows per il pernottamento. Il tipo di dispositivo poteva essere utile per prevedere la spesa perché associato alle caratteristiche dei clienti. Tale associazione non dimostra che acquistare un Mac aumenterebbe di per sé la disponibilità di una persona a pagare per un albergo. Né la pratica descritta di ordinamento delle proposte dimostra, da sola, che camere identiche fossero vendute a prezzi diversi.
La previsione può essere utile anche senza un'interpretazione causale. Viceversa, un modello con un'eccellente accuratezza predittiva può essere inadatto a valutare una politica che modifica le relazioni su cui si fondano le previsioni. Un'analisi econometrica dovrebbe dichiarare esplicitamente il proprio obiettivo e valutare il modello rispetto a esso. I metodi di apprendimento automatico possono supportare la misurazione, la previsione e alcune componenti della stima causale, ma un algoritmo flessibile non fornisce l'argomentazione di identificazione mancante.
Disegno di ricerca e credibilità delle evidenze
L'attenzione ai disegni di ricerca credibili è nata in parte dalla preoccupazione che le conclusioni empiriche potessero cambiare con piccole modifiche delle specificazioni, delle ipotesi o delle forme funzionali. Una maggiore capacità di calcolo e dati più ricchi hanno reso possibili analisi più elaborate, ma hanno anche facilitato l'esplorazione di molti modelli. La risposta importante è stata concentrarsi sul motivo per cui la variabilità utilizzata in un'analisi possa rispondere alla domanda causale.
L'assegnazione casuale offre un termine di riferimento particolarmente chiaro perché è indipendente dai risultati potenziali. Quando gli esperimenti non sono realizzabili, i metodi osservazionali cercano confronti le cui ipotesi di identificazione possano essere formulate ed esaminate. La regressione confronta osservazioni dopo aver tenuto conto delle caratteristiche misurate. I metodi panel utilizzano osservazioni ripetute delle stesse unità. Il difference-in-differences confronta variazioni tra gruppi assumendo una determinata relazione tra le loro tendenze controfattuali. Ogni metodo funziona soltanto quando le sue ipotesi sono appropriate al contesto.
Le valutazioni randomizzate dei programmi contro la povertà illustrano il legame tra evidenze e politiche. La rete di ricerca J-PAL utilizza queste valutazioni per studiare gli interventi e aiutare i decisori a interpretare le evidenze risultanti. Il punto sostanziale è che l'attrattiva o la popolarità di un programma sono diverse dalle evidenze sui suoi effetti. La valutazione si chiede che cosa cambi a causa del programma e come tale conclusione dipenda dalla popolazione, dall'attuazione e dal confronto studiati.
Questo cambiamento viene spesso chiamato rivoluzione della credibilità nell'economia empirica. Non implica che ogni risultato empirico recente sia robusto o causale. Un'analisi convincente richiede comunque definizioni trasparenti, un confronto difendibile, un trattamento appropriato dell'incertezza e verifiche mirate a spiegazioni alternative plausibili. Uno stimatore sofisticato non può compensare un confronto che non risponde alla domanda.
Dalla domanda a un'analisi riproducibile
Un solido percorso di analisi empirica inizia con una domanda formulata con precisione e con la definizione della popolazione, del trattamento, del risultato e del periodo. Il passo successivo consiste nell'esaminare i dati prima di stimare un modello. Occorre verificare se gli identificativi siano univoci, se i valori numerici presentino unità di misura e intervalli plausibili e se i valori mancanti o le restrizioni del campione modifichino la composizione dei dati. Bisogna descrivere la distribuzione del risultato ed esaminare graficamente le relazioni principali.
La scelta del modello segue quindi la domanda e il disegno di ricerca. Una stima dovrebbe essere riportata insieme alle sue unità di misura, al confronto pertinente e a una valutazione dell'incertezza. Per esempio, un coefficiente misurato in punti di un test per ogni studente aggiuntivo per insegnante risponde a una domanda diversa da una variazione percentuale dei punteggi. L'interpretazione richiede inoltre di distinguere la precisione statistica dall'importanza pratica: una variazione stimata con precisione può essere piccola sul piano sostanziale.
Riproducibilità significa rendere esplicite le trasformazioni che conducono dalle osservazioni grezze ai risultati finali. Stata, R e Python permettono tutti di attuare questo percorso. Gli elementi essenziali sono decisioni di pulizia documentate, codice che possa essere rieseguito, definizioni chiare del campione e tabelle o figure coerenti con i calcoli sottostanti. Le verifiche di sensibilità dovrebbero affrontare problemi specifici, come caratteristiche omesse, osservazioni insolite o scelte alternative di misurazione.
Applicazioni economiche e politiche
I metodi microeconometrici possono affrontare domande che vanno ben oltre una definizione ristretta del comportamento di mercato. Tra gli esempi rientrano gli effetti dell'assicurazione sulla salute, delle classi meno numerose sull'apprendimento, della regolarizzazione dei migranti privi di documenti sulla mobilità o sulla rappresentanza politica e degli attacchi terroristici sul consenso elettorale. Queste domande combinano dati individuali o locali con meccanismi rilevanti sul piano economico e sociale.
Lo stesso rigore si applica a tutte le applicazioni: definire il cambiamento di interesse, individuare un confronto che possa approssimarne il controfattuale, esaminare le minacce alla validità di tale confronto e comunicare i limiti delle evidenze. Un effetto medio stimato descrive una specifica popolazione e un determinato contesto. Applicarlo altrove richiede di considerare le differenze nelle istituzioni, nei comportamenti e nell'attuazione. I capitoli seguenti sviluppano gli strumenti statistici necessari per rendere esplicite queste argomentazioni, a partire dalla randomizzazione e dalla regressione lineare.
2. Randomizzazione e regressione lineare
Un confronto causale dovrebbe isolare il cambiamento di interesse mantenendo costanti le alternative rilevanti. L'assegnazione casuale offre un termine di riferimento per questo compito. La regressione lineare permette di descrivere le relazioni e, sotto ipotesi aggiuntive, di effettuare confronti tra osservazioni comparabili utilizzando dati osservazionali. Comprendere la distinzione tra ciò che uno stimatore calcola e ciò che le sue ipotesi di identificazione giustificano è essenziale per entrambi gli approcci.
L'assicurazione sanitaria e il problema della comparabilità
Consideriamo la domanda se l'assicurazione sanitaria migliori la salute. Confrontare persone assicurate e non assicurate sembra semplice: si calcola la salute media in ciascun gruppo e si sottraggono i due valori. La difficoltà è che la copertura assicurativa non viene generalmente assegnata in modo casuale. Persone con coperture diverse possono differire anche per reddito, istruzione, occupazione, età e salute iniziale. Questi fattori possono influenzare sia la copertura sia i risultati successivi.
La National Health Interview Survey del 2009 illustra il problema. Tra i rispondenti coniugati del campione riportato, i mariti assicurati presentavano un indice medio di salute pari a 4.01, contro 3.70 per i mariti non assicurati. La differenza riportata era 0.31. Anche le mogli assicurate presentavano un indice medio più elevato. Tuttavia, i rispondenti assicurati erano sostanzialmente più istruiti e avevano redditi familiari molto più alti. Il confronto combina quindi l'assicurazione con altre differenze potenzialmente rilevanti per la salute.
| Caratteristica | Mariti assicurati | Mariti non assicurati | Differenza, mariti | Mogli assicurate | Mogli non assicurate | Differenza, mogli |
|---|---|---|---|---|---|---|
| Indice di salute | 4.01 [0.93] | 3.70 [1.01] | 0.31 (0.03) | 4.02 [0.92] | 3.62 [1.01] | 0.39 (0.04) |
| Quota di persone non bianche | 0.16 | 0.17 | −0.01 (0.01) | 0.15 | 0.17 | −0.02 (0.01) |
| Età, anni | 43.98 | 41.26 | 2.71 (0.29) | 42.24 | 39.62 | 2.62 (0.30) |
| Istruzione, anni | 14.31 | 11.56 | 2.74 (0.10) | 14.44 | 11.80 | 2.64 (0.11) |
| Numero di componenti della famiglia | 3.50 | 3.98 | −0.47 (0.05) | 3.49 | 3.93 | −0.43 (0.05) |
| Quota di occupati | 0.92 | 0.85 | 0.07 (0.01) | 0.77 | 0.56 | 0.21 (0.02) |
| Reddito familiare, dollari statunitensi | 106,467 | 45,656 | 60,810 (1,355) | 106,212 | 46,385 | 59,828 (1,406) |
I campioni di assicurati e non assicurati comprendono rispettivamente 8,114 e 1,281 mariti e 8,264 e 1,131 mogli. Le parentesi quadre riportano le deviazioni standard dell'indice di salute; le parentesi tonde riportano gli errori standard delle differenze. Le differenze sono le stime originariamente riportate e possono discostarsi leggermente dalla sottrazione delle medie arrotondate visualizzate. Una deviazione standard descrive la dispersione tra individui; un errore standard descrive l'incertezza di una media o di una differenza stimata. Nessuno dei due risolve il problema della comparabilità.
Risultati potenziali e distorsione da selezione
Indichiamo con la presenza di assicurazione e con la sua assenza. L'individuo ha due risultati potenziali: è la salute con assicurazione e è la salute senza assicurazione. L'effetto causale individuale è . Per ciascun individuo, nel momento rilevante, si osserva un solo risultato potenziale:
Il risultato non osservato è il controfattuale. Il seguente esempio ipotetico rende concreto il problema che ne deriva. Khuzdar sceglie di assicurarsi e Maria no. Il confronto osservato è , sebbene l'assicurazione migliori di un punto la salute di Khuzdar e non abbia alcun effetto sulla salute di Maria.
| Grandezza | Khuzdar | Maria |
|---|---|---|
| Salute senza assicurazione, | 3 | 5 |
| Salute con assicurazione, | 4 | 5 |
| Condizione assicurativa scelta, | 1 | 0 |
| Salute osservata, | 4 | 5 |
| Effetto causale individuale | 1 | 0 |
Aggiungere e sottrarre il risultato potenziale di Khuzdar senza assicurazione scompone la differenza osservata nell'effetto dell'assicurazione e in una differenza preesistente:
La scomposizione generale rende esplicita la grandezza a cui si riferisce il termine causale:
Il primo termine è l'effetto medio del trattamento sui trattati, o ATT. Il secondo è la distorsione da selezione: la differenza tra i gruppi nei risultati potenziali in assenza di trattamento. Non deve necessariamente coincidere con una differenza direttamente osservabile. Istruzione e reddito possono rivelare alcune fonti di selezione; preferenze, condizioni iniziali o altri fattori non misurati possono non rivelarne alcuna. Inoltre, quando gli effetti differiscono tra individui, l'ATT non coincide necessariamente con l'effetto medio del trattamento sull'intera popolazione.
Assegnazione casuale e legge dei grandi numeri
L'assegnazione casuale rende lo stato di trattamento indipendente dai risultati potenziali. Con un trattamento ben definito e in assenza di interferenze tra individui, implica che i risultati potenziali medi in assenza di trattamento siano uguali tra i gruppi di assegnazione nella popolazione. Rende inoltre comparabili i gruppi trattati e non trattati rispetto ai loro effetti medi del trattamento. La differenza tra le medie dei gruppi può quindi identificare l'effetto causale medio.
La randomizzazione bilancia le caratteristiche in valore atteso; non rende identico ogni campione effettivamente realizzato. Il lancio di una moneta che assegna al trattamento una persona su due non può evidentemente garantire la corrispondenza di età, redditi o generi. Campioni più grandi tendono a ridurre gli squilibri accidentali, ma un campione ampio non sostituisce un'assegnazione effettivamente casuale. Anche il campionamento casuale e l'assegnazione casuale sono distinti: il primo riguarda la rappresentazione di una popolazione, mentre la seconda riguarda la comparabilità dei gruppi di trattamento.
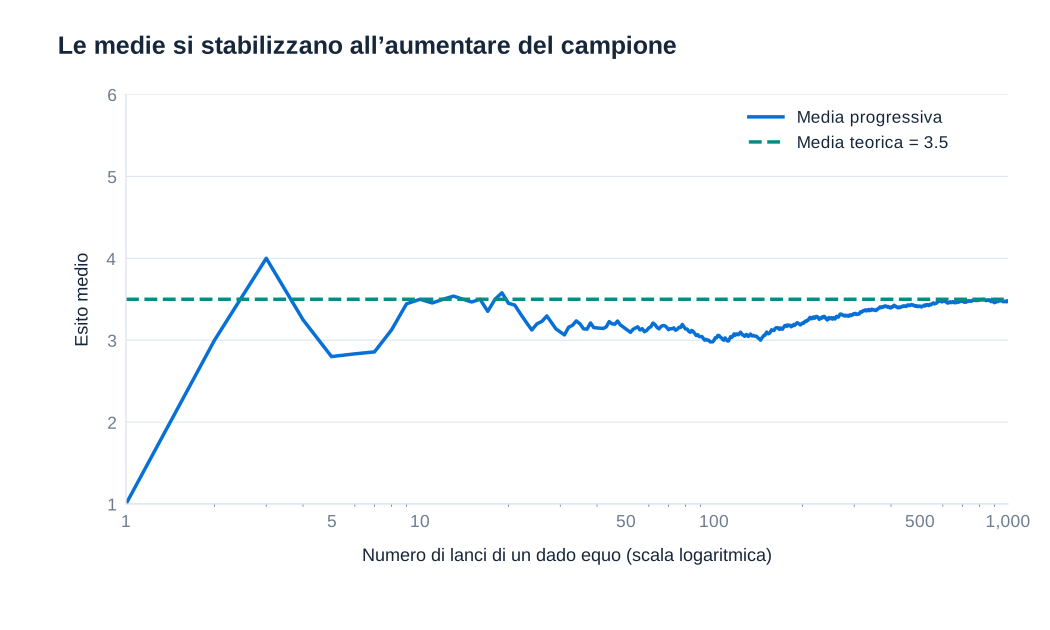
La legge dei grandi numeri spiega perché le medie si stabilizzino. Per osservazioni indipendenti e identicamente distribuite con valore atteso finito, una versione standard afferma:
La convergenza in probabilità significa che, al crescere del campione, la probabilità di uno scostamento superiore a una qualsiasi tolleranza positiva fissata tende a zero. Per un dado equo a sei facce, il risultato atteso è . Una media progressiva può oscillare ampiamente all'inizio e poi stabilizzarsi vicino a 3.5. Non deve necessariamente avvicinarsi a 3.5 in modo monotono e nessuna soglia universale, come 100 osservazioni, garantisce una precisione adeguata.
La dimensione campionaria necessaria dipende dalla variabilità del risultato, dall'effetto del trattamento di interesse, dallo schema di assegnazione e dalla precisione desiderata. La presenza di cluster può ridurre l'informazione fornita da un campione nominalmente ampio, perché le osservazioni all'interno di un gruppo possono essere correlate. Anche la mancata adesione all'assegnazione, l'abbandono del campione e gli effetti di propagazione possono modificare l'interpretazione di un esperimento. L'effetto dell'assegnazione all'assicurazione, per esempio, non coincide necessariamente con l'effetto di ricevere effettivamente una copertura, se alcune persone non rispettano l'assegnazione ricevuta.
Come leggere una tabella di bilanciamento
Una tabella di bilanciamento confronta caratteristiche misurate prima del trattamento. Aiuta a valutare se i gruppi di assegnazione appaiano comparabili e se l'attuazione o l'abbandono del campione abbiano creato differenze problematiche. Il RAND Health Insurance Experiment offre un esempio che confronta piani più generosi con un piano di copertura per eventi catastrofici. La prima colonna numerica seguente riporta la media iniziale del gruppo con copertura catastrofica. Le altre colonne riportano le differenze rispetto a quella media, non le medie dei gruppi alternativi.
| Caratteristica | Media: copertura catastrofica | Differenza: franchigia | Differenza: compartecipazione | Differenza: cure gratuite | Differenza: piani alternativi aggregati |
|---|---|---|---|---|---|
| Quota femminile | 0.560 | −0.023 (0.016) | −0.025 (0.015) | −0.038 (0.015) | −0.030 (0.013) |
| Quota di persone non bianche | 0.172 | −0.019 (0.027) | −0.027 (0.025) | −0.028 (0.025) | −0.025 (0.022) |
| Età, anni | 32.4 [12.9] | 0.56 (0.68) | 0.97 (0.65) | 0.43 (0.61) | 0.64 (0.54) |
| Istruzione, anni | 12.1 [2.9] | −0.16 (0.19) | −0.06 (0.19) | −0.26 (0.18) | −0.17 (0.16) |
| Reddito familiare, dollari statunitensi | 31,603 [18,148] | −2,104 (1,384) | 970 (1,389) | −976 (1,345) | −654 (1,181) |
| Quota di ricoverati nell'anno precedente | 0.115 | 0.004 (0.016) | −0.002 (0.015) | 0.001 (0.015) | 0.001 (0.013) |
| Indice di salute generale | 70.9 [14.9] | −1.44 (0.95) | 0.21 (0.92) | −1.31 (0.87) | −0.93 (0.77) |
| Colesterolo, mg/dl | 207 [40] | −1.42 (2.99) | −1.93 (2.76) | −5.25 (2.70) | −3.19 (2.29) |
| Pressione arteriosa sistolica, mm Hg | 122 [17] | 2.32 (1.15) | 0.91 (1.08) | 1.12 (1.01) | 1.39 (0.90) |
| Indice di salute mentale | 73.8 [14.3] | −0.12 (0.82) | 1.19 (0.81) | 0.89 (0.77) | 0.71 (0.68) |
Le deviazioni standard, dove riportate per il gruppo con copertura catastrofica, compaiono tra parentesi quadre; gli errori standard delle differenze compaiono tra parentesi tonde. I partecipanti erano 759 nella copertura catastrofica, 881 nel piano con franchigia, 1,022 nel piano con compartecipazione e 1,295 nel piano con cure gratuite. L'ultima colonna aggrega i 3,198 partecipanti ai tre piani alternativi. La copertura catastrofica è essa stessa un'assicurazione: si tratta quindi di un confronto della generosità assicurativa, non di un confronto con la completa assenza di copertura.
Per esempio, la quota femminile del gruppo con cure gratuite è approssimativamente . Il suo indice iniziale di salute generale è approssimativamente . La tabella non mostra l'effetto delle cure gratuite sulla salute: si tratta di caratteristiche iniziali, misurate prima che il trattamento potesse produrre i successivi risultati di interesse.
Alcune differenze iniziali possono risultare statisticamente significative per caso, soprattutto quando si esaminano molte caratteristiche. La differenza nella quota femminile per il gruppo con cure gratuite dista da zero circa 2.53 errori standard. Questa osservazione dovrebbe essere interpretata insieme alla procedura di assegnazione e al quadro complessivo del bilanciamento, anziché essere considerata una prova automatica del fallimento della randomizzazione. Viceversa, differenze non significative non dimostrano che le caratteristiche inosservate siano bilanciate o che in un campione piccolo non esistano squilibri importanti.
Il modello di popolazione e la soluzione dei minimi quadrati
Quando l'assegnazione casuale non è disponibile, una regressione può descrivere come un risultato vari al variare di una variabile esplicativa. Il modello lineare semplice è:
Qui è il risultato, la variabile esplicativa, l'intercetta e la pendenza. Il termine di errore raccoglie le restanti determinanti del risultato e gli scostamenti dalla relazione specificata. I coefficienti sono grandezze della popolazione; le loro stime variano da un campione all'altro. Il termine di errore è una variabile casuale non osservata, non un parametro fisso della popolazione.
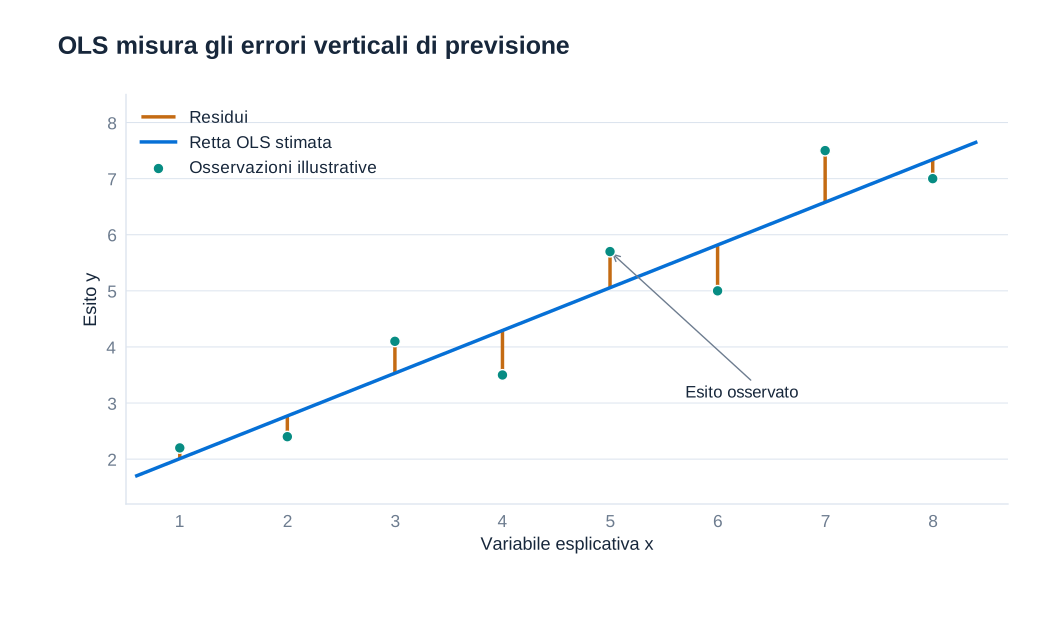
Il metodo dei minimi quadrati ordinari, o OLS, sceglie l'intercetta e la pendenza che minimizzano la somma dei quadrati degli scostamenti verticali tra i risultati osservati e la retta stimata:
L'elevamento al quadrato impedisce che gli scostamenti positivi e negativi si annullino e attribuisce un peso maggiore alle discrepanze ampie. Derivando rispetto ai due coefficienti si ottengono le equazioni normali e . Risolvendole, quando varia nel campione, si ottiene:
Il denominatore è una somma di scostamenti al quadrato. Senza il quadrato, gli scostamenti dalla media campionaria hanno somma pari a zero. La pendenza può essere scritta in modo equivalente come rapporto tra covarianza campionaria e varianza campionaria, purché entrambe utilizzino la stessa normalizzazione. Sotto l'appropriata condizione di ortogonalità nella popolazione, la corrispondente pendenza di popolazione è .
Valori stimati, residui e geometria della regressione
Il valore stimato è . Il residuo è il risultato osservato meno questa previsione, . È una distanza verticale perché il criterio prevede condizionatamente a ; OLS non minimizza le distanze perpendicolari alla retta.
In un esempio numerico, la retta stimata è e la somma dei quadrati dei residui è 384. Per , la retta prevede 23.07. Un'osservazione superiore a tale valore ha un residuo positivo, mentre una inferiore ha un residuo negativo. Il valore 384 descrive la somma complessiva degli scostamenti al quadrato nel campione e dipende dalla scala del risultato e dal numero di osservazioni; non è di per sé una misura della credibilità causale.
In presenza di un'intercetta, le equazioni normali implicano identità campionarie esatte:
La retta passa quindi per e i residui sono ortogonali al regressore incluso e ai valori stimati nel campione. Si tratta di proprietà algebriche del calcolo OLS. Non dimostrano che il termine di errore della popolazione non sia associato a . Una determinante omessa correlata con può distorcere il coefficiente anche se i residui stimati soddisfano tutte queste identità.
Mantenere distinti e evita un errore comune. Il primo appartiene al modello di popolazione e non è osservato direttamente; il secondo è calcolato dopo aver stimato il modello. Esaminare i residui può rivelare andamenti sistematici, osservazioni insolite o forme funzionali inappropriate, ma la covarianza campionaria nulla tra un regressore incluso e i suoi residui OLS è garantita per costruzione.
I punteggi dei test e il significato di una pendenza
Un dataset di 420 distretti scolastici della California mette in relazione i punteggi medi dei test con il rapporto studenti-insegnanti. La relazione stimata, utilizzando le stime dei coefficienti riportate e arrotondate a due cifre decimali, è:
La pendenza associa uno studente aggiuntivo per insegnante a un punteggio previsto inferiore di 2.28 punti. Una riduzione del rapporto di due studenti per insegnante corrisponde a un aumento di 4.56 punti del risultato stimato. Per un rapporto pari a 20, la previsione è ; per un rapporto pari a 18 è 657.86. Si tratta di previsioni ricavate dalla retta stimata, non del risultato osservato in ogni distretto con quei rapporti.
Rispetto a un punteggio medio del test di circa 654, una variazione di 2.28 punti equivale a circa . Questo calcolo permette di valutare l'ordine di grandezza del coefficiente. Non rende 0.35% il coefficiente di regressione e non indica una variazione di 0.35 punti percentuali. In un modello lineare-lineare, il coefficiente diretto misura sempre unità del risultato per unità della variabile esplicativa.
L'intercetta è il risultato previsto quando il rapporto studenti-insegnanti è zero, valore esterno all'intervallo rilevante dei dati. Contribuisce a posizionare la retta stimata, ma ha scarso valore sostanziale come previsione letterale. Estrapolare molto oltre l'intervallo osservato è rischioso, perché un andamento lineare all'interno di quell'intervallo non deve necessariamente proseguire altrove.
Soprattutto, la sola pendenza negativa non dimostra che assumere insegnanti causi il miglioramento previsto. Il reddito del distretto, la composizione linguistica e altre risorse possono essere associati sia alla numerosità delle classi sia ai punteggi dei test. L'aggiustamento mediante regressione può confrontare distretti con caratteristiche misurate simili, ma controllare per le caratteristiche osservabili non elimina automaticamente le differenze inosservate. Un'interpretazione causale richiede un'argomentazione sulle determinanti che rimangono nel termine di errore.
Assenza di distorsione, consistenza e compromesso tra distorsione e varianza
Uno stimatore è una regola applicata a un campione; una stima è il suo risultato numerico effettivamente ottenuto. Ripetere il processo di campionamento produce una distribuzione campionaria. L'assenza di distorsione significa che la media di questa distribuzione coincide con il parametro della popolazione: . Non significa che ogni stima coincida con il parametro. Uno stimatore non distorto può essere impreciso e produrre singole stime lontane dal valore vero.
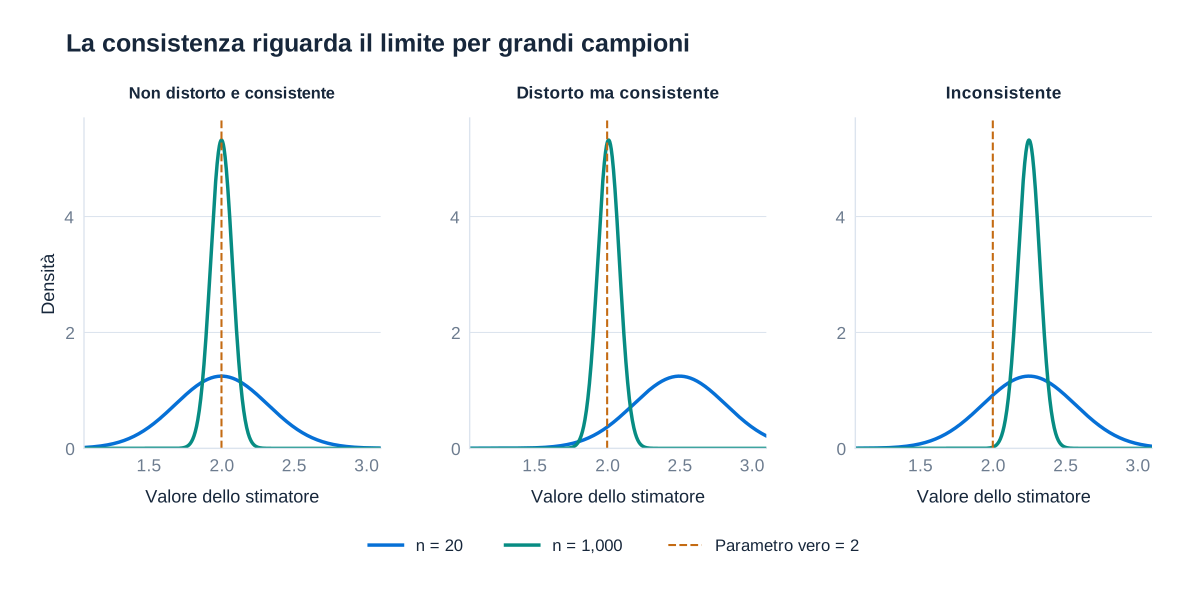
La consistenza riguarda una successione di stimatori al crescere della dimensione campionaria. Formalmente, . La probabilità di un errore di stima di entità fissata tende quindi a zero. A differenza dell'assenza di distorsione, la consistenza è una proprietà asintotica. Un maggior numero di osservazioni non rende consistente una procedura intrinsecamente inconsistente; può invece concentrare le sue stime intorno al valore sbagliato.
Tre esempi distinguono questi concetti. Primo, supponiamo che soddisfi le condizioni per cui OLS è non distorto e consistente. La distribuzione della pendenza è centrata su 2 e diventa più concentrata al crescere del campione. Secondo, definiamo uno stimatore modificato . Ha una distorsione in campioni finiti pari a , ma è consistente quando OLS è consistente: il termine aggiunto è 0.5 per , 0.01 per e tende a zero.
Terzo, supponiamo che il termine di errore nella stessa equazione strutturale sia , con . Sostituendo si ottiene . Una regressione di su converge a 2.25, non al coefficiente strutturale 2. Aumentare la dimensione campionaria rende più precisa la pendenza descrittiva, lasciando però invariato lo scostamento di 0.25 nell'interpretazione strutturale.
Precisione e distorsione sono dimensioni distinte delle prestazioni. Per uno stimatore scalare, l'errore quadratico medio si scompone come segue:
Uno stimatore con una piccola distorsione può avere un errore quadratico medio inferiore a quello di uno stimatore non distorto molto disperso. Questo compromesso è rilevante nella valutazione degli stimatori, ma non giustifica ignorare una distorsione causale sistematica soltanto perché gli errori standard sono piccoli.
Le ipotesi alla base delle proprietà OLS
Per il consueto risultato di assenza di distorsione in campioni finiti, una condizione centrale è la media condizionata nulla, , insieme a una media condizionata lineare correttamente specificata, condizioni di campionamento appropriate e variabilità di . La media non condizionata nulla, , è una condizione più debole: errori positivi e negativi possono avere media zero pur variando sistematicamente con il regressore. Una covarianza nulla tra e può sostenere la consistenza di una proiezione lineare sotto opportune condizioni di regolarità, ma non dovrebbe essere presentata come equivalente alla media condizionata nulla.
Nella regressione multipla, i regressori non devono essere perfettamente collineari. Nel modello semplice ciò significa che non può essere costante. Senza variabilità di , i dati non possono distinguere l'intercetta dalla pendenza. Il campionamento casuale e le condizioni di esistenza di momenti finiti sostengono le leggi dei grandi numeri e le approssimazioni campionarie. Le osservazioni molto influenti richiedono un esame; il requisito formale non è che non possa esistere alcuna osservazione insolita.
Il risultato di Gauss–Markov aggiunge l'omoschedasticità e l'assenza di correlazione tra i termini di errore di osservazioni diverse, condizionatamente ai regressori. Sotto le ipotesi pertinenti, OLS è il miglior stimatore lineare non distorto, o BLUE. «Migliore» significa con la varianza minima nella classe degli stimatori lineari non distorti. «Lineare» si riferisce al fatto che lo stimatore è una funzione lineare dei risultati osservati, condizionatamente ai regressori. Non significa che si possano modellare soltanto relazioni rappresentate da rette, né che OLS domini ogni possibile stimatore non lineare o distorto.
Per Gauss–Markov non è richiesta la normalità dei termini di errore. In presenza di esogeneità, l'eteroschedasticità può lasciare OLS non distorto e consistente, invalidando però la consueta formula della varianza omoschedastica e la proprietà BLUE. Infine, anche una stima corretta di un'associazione condizionata non dimostra automaticamente un meccanismo causale: l'interpretazione economica dipende dal disegno di ricerca e dal significato del termine di errore.
Che cosa determina la precisione?
In presenza di omoschedasticità e di termini di errore non correlati, la varianza condizionata della pendenza nella regressione semplice è:
L'espressione esatta è condizionata ai valori effettivamente osservati del regressore; l'approssimazione sostituisce la loro somma degli scostamenti al quadrato con la corrispondente grandezza per campioni grandi. Una maggiore varianza del termine di errore rende più difficile stimare la retta. Una maggiore variabilità di fornisce più informazioni sulla sua pendenza. Un maggior numero di osservazioni migliora generalmente la precisione quando aggiunge informazione indipendente. L'errore standard, essendo la radice quadrata della varianza, diminuisce tipicamente a un tasso proporzionale a : quadruplicare la dimensione campionaria lo dimezza quindi approssimativamente, a parità delle altre condizioni.
Nella pratica, la varianza ignota del termine di errore deve essere stimata. Con un'intercetta e una pendenza, uno stimatore omoschedastico convenzionale è , da cui si ottiene . La sottrazione di due riflette i due coefficienti stimati. L'eteroschedasticità o la dipendenza richiedono uno stimatore della varianza adeguato a quel contesto.
Leggere un risultato di regressione comporta quindi tre domande distinte. Quale confronto e quali unità di misura rappresenta il coefficiente? Quali ipotesi giustificano la sua interpretazione come relazione di interesse? Quanta incertezza campionaria rimane? Rispondere soltanto alla prima o alla terza può produrre una conclusione apparentemente precisa che il disegno di ricerca non sostiene.
3. Distorsione da variabile omessa ed errore di misurazione
Un coefficiente di regressione è utile soltanto quando la sua interpretazione corrisponde al processo che ha generato i dati. Un campione ampio può rendere una stima molto precisa, lasciandola però sistematicamente errata rispetto alla relazione di interesse. Due minacce particolarmente importanti sono le variabili omesse, che fanno confluire determinanti rilevanti del risultato nell'errore di regressione, e l'errore di misurazione, che separa le variabili registrate in un dataset dalle grandezze economiche che dovrebbero rappresentare. Per comprendere questi problemi occorre distinguere l'incertezza intorno a una stima dalla distorsione rispetto al suo obiettivo.
Consistenza, esogeneità e obiettivo della stima
Consideriamo la relazione nella popolazione . Il parametro descrive la relazione che intendiamo stimare; l'errore raccoglie i determinanti del risultato che restano al di fuori del modello. In una regressione semplice con intercetta, il coefficiente angolare OLS può essere espresso come una covarianza campionaria divisa per una varianza campionaria. In presenza di una legge dei grandi numeri e di una varianza di positiva e finita, il suo limite in probabilità è
L'equazione individua il requisito centrale della consistenza: il regressore deve essere incorrelato con l'errore affinché OLS converga a questo coefficiente strutturale. La condizione più forte giustifica anche la consueta interpretazione condizionata e, con opportune ipotesi sul campionamento, la non distorsione in campioni finiti. La consistenza significa che lo stimatore si avvicina all'obiettivo al crescere del campione; la non distorsione riguarda il valore atteso dello stimatore per una determinata numerosità campionaria. Nessuna delle due proprietà è dimostrata semplicemente ottenendo un errore standard piccolo.
L'affermazione secondo cui OLS è il miglior stimatore lineare non distorto richiede inoltre le ipotesi del teorema di Gauss–Markov, compresa un'appropriata struttura degli errori omoschedastici e incorrelati. Queste ipotesi di efficienza non devono essere confuse con le condizioni di esogeneità necessarie per recuperare il coefficiente di interesse. Una regressione può avere errori eteroschedastici e stimare comunque il coefficiente angolare in modo consistente, mentre un fattore di confondimento omesso può rendere il coefficiente inconsistente anche con errori perfettamente omoschedastici. Se l'obiettivo è soltanto la migliore previsione lineare, OLS può stimare tale proiezione predittiva senza identificare un effetto causale.
Derivazione della distorsione da variabile omessa
Supponiamo che il modello rilevante nella popolazione contenga un'ulteriore variabile :
dove è incorrelato con e . Se viene omessa, l'errore nella regressione ridotta diventa . L'omissione influisce sul coefficiente di quando valgono congiuntamente due condizioni: contribuisce a determinare , per cui , e è correlata con . La sola correlazione con non è sufficiente se la variabile omessa non ha alcun effetto sul risultato nella relazione rilevante nella popolazione.
Scriviamo la proiezione lineare nella popolazione della variabile omessa sul regressore incluso come
Questa proiezione è una descrizione algebrica dell'associazione; non richiede che causi . Sostituendo si ottiene
Il coefficiente angolare della regressione ridotta converge quindi a una combinazione del coefficiente diretto e dell'associazione che opera attraverso la variabile omessa:
Questa affermazione riguarda il limite in probabilità, non una scomposizione esatta di ogni stima effettivamente ottenuta: un singolo campione contiene anche variabilità campionaria. Nella regressione multipla, la corrispondente relazione con la variabile omessa è condizionata alle variabili di controllo già incluse. Ciò che conta è se la variabile omessa rimane associata al regressore dopo aver tenuto conto di tali controlli.
Determinare la direzione della distorsione
Il segno della distorsione è il prodotto di due segni. Per prima cosa occorre chiedersi se un aumento della variabile omessa accresca o riduca il risultato, mantenendo fisso il regressore incluso. Poi bisogna chiedersi se le osservazioni con valori maggiori del regressore incluso tendano ad avere valori maggiori o minori della variabile omessa. Tenere separate queste due domande evita di sostituire un ragionamento intuitivo al calcolo effettivo del segno.
| Effetto della variabile omessa sul risultato | Associazione con il regressore incluso | Distorsione del coefficiente angolare nella regressione ridotta |
|---|---|---|
| Positivo: | Positiva: | Positiva: il coefficiente si sposta verso l'alto |
| Positivo: | Negativa: | Negativa: il coefficiente si sposta verso il basso |
| Negativo: | Positiva: | Negativa: il coefficiente si sposta verso il basso |
| Negativo: | Negativa: | Positiva: il coefficiente si sposta verso l'alto |
“Verso l'alto” significa numericamente maggiore, mentre “verso il basso” significa numericamente minore. Nessuna delle due espressioni è sinonimo di “più vicino a zero”. Una distorsione negativa riduce un coefficiente positivo, ma rende più negativo un coefficiente negativo; un confondimento sufficientemente forte può persino invertirne il segno. Quando si omettono più variabili rilevanti, i loro contributi possono rafforzarsi oppure compensarsi, per cui individuare un possibile fattore di confondimento non permette necessariamente di stabilire il segno della distorsione complessiva.
Risultati nei test, dimensione delle classi e reddito familiare
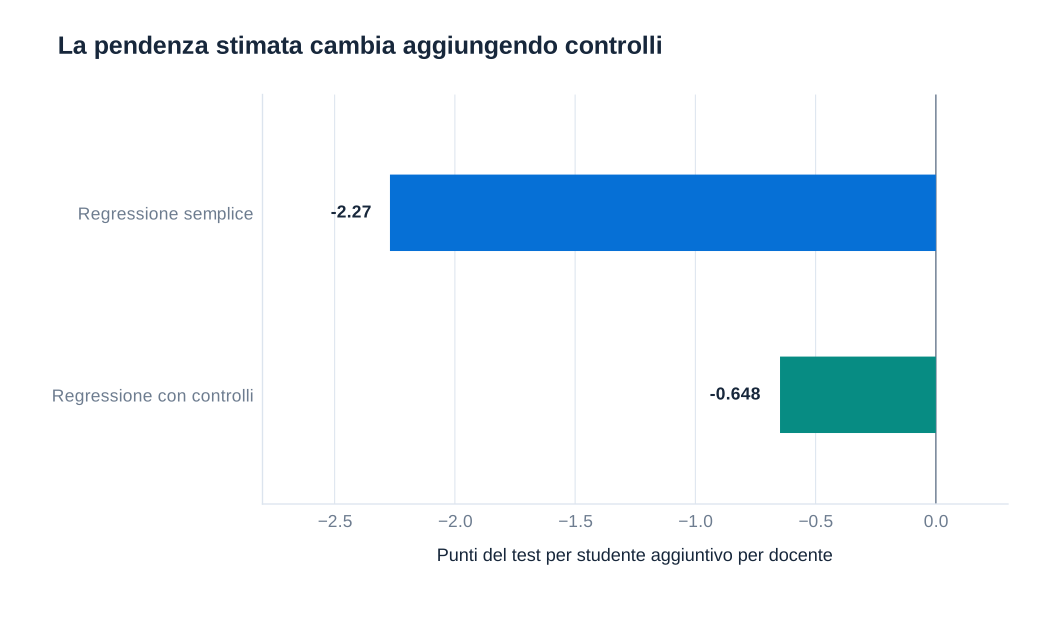
Un esempio relativo ai distretti scolastici mette in relazione i punteggi medi nei test con il rapporto studenti/insegnanti. Un rapporto maggiore significa più studenti per insegnante, quindi il coefficiente è misurato in punti del test per ogni studente aggiuntivo per insegnante. La regressione non corretta per altre variabili fornisce un'intercetta di circa e un coefficiente angolare di circa . Essa prevede che distretti che differiscono di uno studente per insegnante presentino, in media, una differenza di circa 2.28 punti nei test. Si tratta inizialmente di un'associazione tra distretti, non di un effetto identificato dell'assunzione di insegnanti.
Il reddito familiare offre una spiegazione plausibile per una parte di questa associazione. Supponiamo che un reddito familiare più elevato migliori i risultati attraverso risorse e opportunità, per cui , e che i distretti più ricchi tendano ad avere rapporti studenti/insegnanti inferiori, per cui . Il loro prodotto è negativo. La regressione ridotta attribuisce allora al rapporto più basso una parte del vantaggio nei risultati associato al reddito, rendendo il coefficiente stimato del rapporto più negativo di quello ottenuto con un opportuno controllo per il reddito.
Nel confronto illustrato, il coefficiente del rapporto riportato passa da circa senza il reddito a con il reddito. Un aumento del rapporto di cinque unità è quindi associato a circa punti usando il primo coefficiente riportato e a punti usando quello corretto per il reddito. Si tratta di calcoli basati sui coefficienti di regressione riportati, non di effetti di politiche identificati sperimentalmente. Lo spostamento verso l'alto del coefficiente è coerente con la direzione prevista della distorsione dovuta all'omissione del reddito, ma non dimostra che ogni forma di confondimento sia scomparsa.
La correzione va intesa come un confronto tra distretti dopo aver tenuto conto della relazione con il reddito specificata nel modello. Altri determinanti, tra cui il contesto familiare, la composizione scolastica e le modalità di allocazione delle risorse, possono rimanere rilevanti. Anche un'intercetta stimata vicina a 699 rappresenta un'estrapolazione a un rapporto pari a zero, al di fuori dell'intervallo utile per il confronto; non va interpretata come il punteggio che un distretto reale otterrebbe in assenza di studenti per insegnante.
Affrontare le variabili omesse senza aggiungere controlli inappropriati
La risposta più diretta consiste nel raccogliere e includere un fattore di confondimento misurato bene. Questo funziona soltanto se il modello ampliato rappresenta adeguatamente la relazione condizionata rilevante e rimane una variazione sufficiente per stimare l'effetto. Controllare per una variabile non elimina automaticamente ogni dimensione della selezione a essa associata. Per esempio, una misura del reddito può lasciare inspiegate differenze rilevanti nelle risorse familiari, e una correzione puramente lineare può essere inadeguata per una relazione fortemente non lineare.
Una variabile proxy può essere utile quando il fattore di confondimento non è direttamente disponibile, ma una proxy imperfetta lascia generalmente un confondimento residuo. Le variabili strumentali possono affrontare alcuni problemi di endogeneità quando uno strumento è rilevante per il regressore endogeno e soddisfa una restrizione di esclusione e una condizione di esogeneità credibili. I metodi per dati panel possono eliminare caratteristiche non osservate che rimangono costanti nel tempo all'interno di un'unità. Ogni approccio sostituisce una difficoltà di identificazione con ipotesi esplicite che devono essere giustificate; nessuno garantisce automaticamente un coefficiente causale.
La scelta delle variabili di controllo dovrebbe seguire la domanda causale. Una variabile causata dal trattamento può essere un mediatore anziché un fattore di confondimento preesistente. Controllare per essa può eliminare una parte dell'effetto totale che il ricercatore intende stimare. Anche condizionare su una conseguenza comune del trattamento e di determinanti non osservati del risultato può generare distorsione. Una specificazione ragionata parte quindi dalla descrizione del processo economico e della sequenza temporale delle variabili, anziché dalla ricerca del maggior numero possibile di controlli.
Errore di misurazione in una variabile esplicativa
Le variabili economiche sono spesso misurate in modo imperfetto. La produzione nazionale si basa su registrazioni incomplete e stime; le indagini sull'uso del tempo dipendono dalla memoria degli intervistati; l'immigrazione irregolare è difficile da quantificare; reddito e felicità autodichiarati possono essere registrati in modo inesatto. L'errore di misurazione può riflettere rumore casuale, comportamenti sistematici nelle dichiarazioni oppure una mancata corrispondenza tra un indicatore registrato e il concetto sottostante.
Indichiamo con il vero regressore e poniamo il valore osservato pari a . Supponiamo che il modello nella popolazione sia . Nel caso additivo classico, assumiamo , , e . Sostituendo nel modello si ottiene
Il segno meno è essenziale. Il regressore osservato contiene l'errore di misurazione con segno positivo, mentre il nuovo disturbo di regressione lo contiene moltiplicato per . Di conseguenza,
Quindi anche un errore non associato al vero regressore crea correlazione tra il regressore osservato e il disturbo composito di regressione. Definire “casuale” l'errore di misurazione non rende esogena la regressione risultante.
Attenuazione, affidabilità ed errore non classico
Le ipotesi classiche implicano e . Il limite in probabilità del coefficiente del regressore osservato è quindi
Il rapporto di affidabilità è compreso tra zero e uno quando la variazione vera è positiva e la varianza dell'errore di misurazione è finita. È uguale a uno quando non vi è errore di misurazione. Man mano che il rumore diventa più importante rispetto alla variazione vera, il coefficiente viene spinto ulteriormente verso zero. Un coefficiente vero positivo viene attenuato verso il basso; un coefficiente vero negativo viene attenuato verso l'alto. L'attenuazione è quindi una riduzione del valore assoluto, non una distorsione numerica invariabilmente verso il basso.
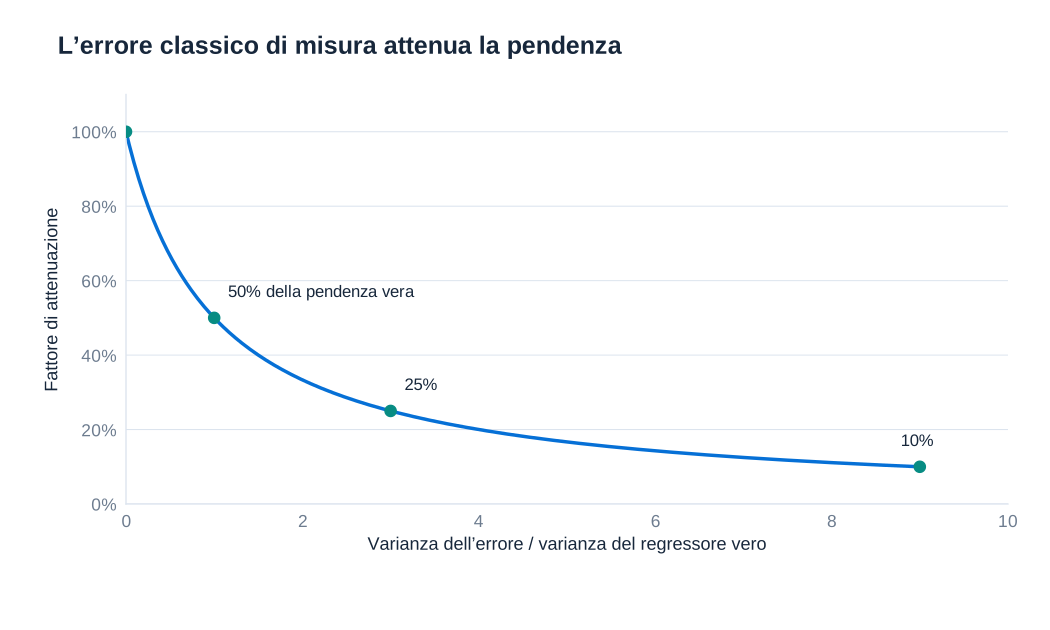
Come esempio ipotetico, se la variazione vera e quella dell'errore di misurazione sono uguali, allora : un coefficiente vero di 4 viene stimato vicino a 2 in un campione sufficientemente ampio, mentre un coefficiente vero di viene stimato vicino a . Un maggior numero di osservazioni concentra lo stimatore intorno a questo obiettivo attenuato; non elimina la distorsione. Una misurazione migliore, informazioni di validazione oppure uno strumento opportunamente valido possono aiutare a identificare il coefficiente desiderato.
L'errore non classico viola una o più delle restrizioni classiche. Gli intervistati con redditi elevati potrebbero sottodichiarare maggiormente il reddito, oppure la qualità delle dichiarazioni potrebbe dipendere dal risultato. La distorsione può allora avere qualunque segno. Persino l'errore classico in una variabile di una regressione multipla non deve necessariamente spostare ogni coefficiente stimato verso zero: le correlazioni tra regressori possono trasmettere il problema ad altri coefficienti. La semplice formula dell'affidabilità dovrebbe quindi essere usata soltanto per il modello e le ipotesi sotto cui è stata derivata.
Errore di misurazione nel risultato e interpretazione pratica
Supponiamo ora che il vero risultato soddisfi , ma che il risultato osservato sia . La relazione stimata diventa
Se l'errore originario è esogeno e l'errore di misurazione del risultato ha media condizionata nulla dato , l'errore composito rimane esogeno. Il coefficiente angolare può quindi rimanere consistente. Se è anche incorrelato con , la sua varianza si aggiunge a quella del disturbo originario, riducendo generalmente la precisione. Sotto queste restrizioni, il rumore classico nel risultato aumenta l'incertezza senza produrre l'attenuazione del regressore descritta sopra.
Questa conclusione è condizionata alle ipotesi, non universale. Se le persone con valori più elevati di sovradichiarano sistematicamente il risultato, allora varia con e il coefficiente può essere distorto. Anche la correlazione tra errore di misurazione e disturbo originario modifica il semplice risultato di additività delle varianze. Un'analisi empirica accurata individua ciò che viene misurato, come viene registrato e perché le ipotesi proposte sull'errore sono plausibili. La distinzione centrale è se il problema modifichi l'obiettivo del coefficiente, la sua precisione oppure entrambi.
4. Verifica delle ipotesi e inferenza statistica
Una stima puntuale è una realizzazione di una procedura applicata ai dati. Un altro campione potrebbe produrre un'altra stima, anche se la relazione nella popolazione rimanesse invariata. L'inferenza statistica misura questa incertezza campionaria e la utilizza per valutare ipotesi e costruire intervalli di confidenza. Le sue conclusioni dipendono sia da un modello credibile per il coefficiente sia da una stima credibile della sua variabilità. Né un p-value piccolo né un intervallo stretto correggono la distorsione da variabile omessa o un disegno causale non valido.
Campionamento casuale e assegnazione casuale rispondono a domande diverse
Il campionamento casuale riguarda il modo in cui le osservazioni entrano in un dataset. Un campione casuale semplice permette di fare inferenza dalle unità osservate alla popolazione dalla quale sono state estratte. L'assegnazione casuale riguarda il modo in cui il trattamento viene distribuito tra le unità e può rendere lo stato di trattamento indipendente dai loro risultati potenziali. Uno studio può prevedere un'assegnazione casuale senza estrarre un campione rappresentativo della popolazione, oppure un campione rappresentativo senza assegnazione casuale del trattamento.
La distinzione separa l'identificazione dalla generalizzazione. L'assegnazione casuale può fornire un confronto credibile del trattamento all'interno del gruppo studiato; estendere tale effetto ad altri gruppi può richiedere ipotesi aggiuntive. Viceversa, campionare casualmente le persone non rende esogene la loro istruzione, il loro reddito o le loro scelte di trattamento. Nella regressione su dati osservazionali, l'incertezza su quali unità siano state campionate e la distorsione dovuta al legame del regressore con determinanti non osservati sono problemi diversi.
La distribuzione campionaria descrive le stime che si otterrebbero ripetendo la procedura di campionamento con la stessa popolazione e lo stesso modello. Si tratta di una ripetizione concettuale, non dell'affermazione che il ricercatore osservi effettivamente molte popolazioni. Gli errori standard approssimano la dispersione di questa distribuzione usando i dati disponibili e ipotesi sulla dipendenza. Se il processo di campionamento coinvolge famiglie, scuole, regioni oppure osservazioni ripetute, le unità indipendenti rilevanti possono essere gruppi anziché singole righe.
Gli errori standard misurano l'incertezza di uno stimatore
La deviazione standard di un risultato descrive la variazione tra osservazioni. L'errore standard di uno stimatore descrive la variazione tra ipotetiche stime ripetute. Queste grandezze rispondono a domande diverse e hanno unità di misura diverse. L'errore standard di un coefficiente angolare di regressione si misura nelle stesse unità del coefficiente: per una regressione dei punteggi nei test sul numero di studenti per insegnante, si tratta di punti del test per unità del rapporto.
Per una regressione semplice con intercetta, errori condizionatamente omoschedastici e incorrelati e una specificazione valida della media condizionata, la varianza del coefficiente angolare condizionata ai regressori osservati è
Poiché la varianza del disturbo è sconosciuta, viene stimata a partire dai residui. Con due coefficienti stimati, lo stimatore abituale è . L'errore standard convenzionale del coefficiente angolare è la radice quadrata della varianza stimata del coefficiente. La corrispondente intuizione per grandi campioni è .
Una maggiore variazione non spiegata del risultato aumenta l'incertezza; un maggior numero di osservazioni indipendenti e una maggiore variazione utile del regressore la riducono. Nella regressione multipla, la variazione utile di un regressore è quella che rimane dopo aver tenuto conto degli altri regressori. Una forte collinearità può quindi produrre errori standard elevati anche in un dataset con molte osservazioni. Queste relazioni riguardano la precisione sotto le ipotesi del modello, non la capacità del modello di identificare un effetto causale.
Ipotesi nulle, statistiche t e distribuzioni di riferimento
Un'ipotesi nulla specifica un valore per un parametro della popolazione, come . Per un'alternativa bilaterale, , la statistica t misura la distanza stimata dall'ipotesi nulla in unità di errore standard:
Quando , questa espressione si riduce al consueto rapporto tra coefficiente ed errore standard. Un valore di significa che la stima si trova quattro errori standard stimati al di sotto del valore ipotizzato. L'ipotesi riguarda il coefficiente della popolazione; la stima osservata è già nota e, dopo aver osservato i dati, non è essa stessa un'incognita casuale.
Con errori indipendenti, distribuiti normalmente e condizionatamente omoschedastici, e con le consuete ipotesi del modello lineare, la statistica t convenzionale ha una distribuzione t di Student esatta con gradi di libertà, dove comprende l'intercetta. Con errori standard robusti all'eteroschedasticità, questo risultato esatto per campioni finiti generalmente non vale. Sotto opportune condizioni di regolarità, la statistica studentizzata si avvicina invece a una distribuzione normale standard al crescere della numerosità campionaria effettiva. I software possono usare come approssimazione una distribuzione t di riferimento con un aggiustamento dei gradi di libertà; la sua validità va valutata alla luce del disegno dello studio.
Il teorema del limite centrale si applica alle medie standardizzate
Il teorema del limite centrale spiega perché le approssimazioni normali possano essere utili anche quando le singole osservazioni non sono distribuite normalmente. Per variabili casuali indipendenti e identicamente distribuite, con media e varianza positiva e finita , la versione di base del teorema afferma
Le osservazioni originarie non diventano normali al crescere del campione. È la media campionaria centrata e riscalata ad avvicinarsi a una distribuzione normale, mentre la media campionaria non riscalata si concentra vicino alla propria media nella popolazione. L'inferenza nella regressione utilizza un ragionamento analogo perché, sotto ipotesi appropriate, l'errore di uno stimatore può essere rappresentato approssimativamente come una media di contributi casuali. Una studentizzazione valida richiede inoltre una stima consistente dell'errore standard.
Consideriamo una variabile di Bernoulli che assume valore uno con probabilità 0.8 e zero altrimenti. Ogni osservazione rimane binaria per qualsiasi numerosità campionaria. La sua media è 0.8 e la sua varianza è . La deviazione standard della sua media campionaria è quindi . Per numerosità campionarie pari a 10, 100, 1,000 e 10,000, essa diventa rispettivamente circa 0.1265, 0.0400, 0.01265 e 0.0040.
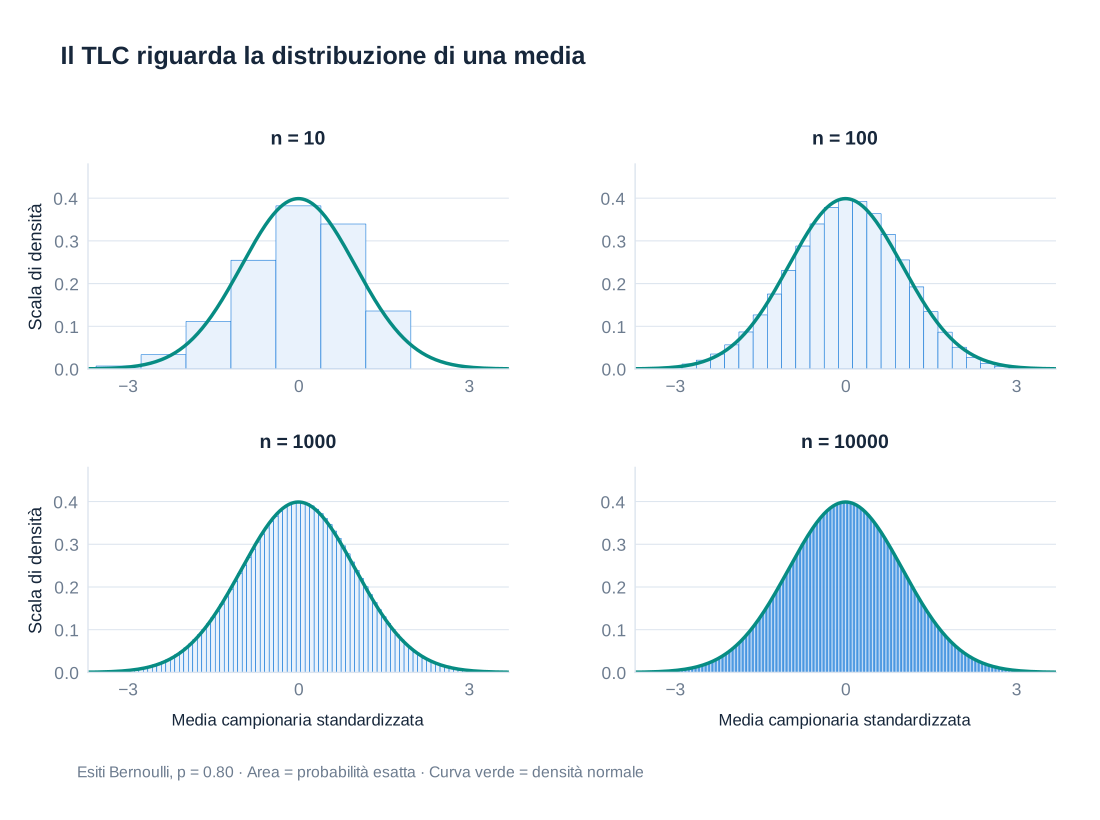
La distribuzione della media campionaria è discreta, con valori possibili separati da . Nei piccoli campioni può essere visibilmente asimmetrica perché la probabilità di successo è elevata; nei campioni più ampi la sua forma standardizzata è ben approssimata dalla distribuzione normale. L'approssimazione non è una conseguenza automatica di un elevato numero di righe. Code pesanti, dipendenza, identificazione debole oppure un numero limitato di cluster indipendenti possono compromettere le condizioni necessarie per i consueti ragionamenti sui grandi campioni.
Regioni di rifiuto e significatività statistica
Un livello di significatività specifica la probabilità di rifiutare un'ipotesi nulla vera che la procedura di verifica è progettata per controllare sotto le proprie ipotesi. Per un test bilaterale con distribuzione normale standard di riferimento, un livello di significatività del 5% colloca il 2.5% in ciascuna coda e utilizza valori critici approssimativamente pari a e . Rifiutare quando individua quindi stime insolitamente lontane dall'ipotesi nulla rispetto alla loro variabilità campionaria stimata.
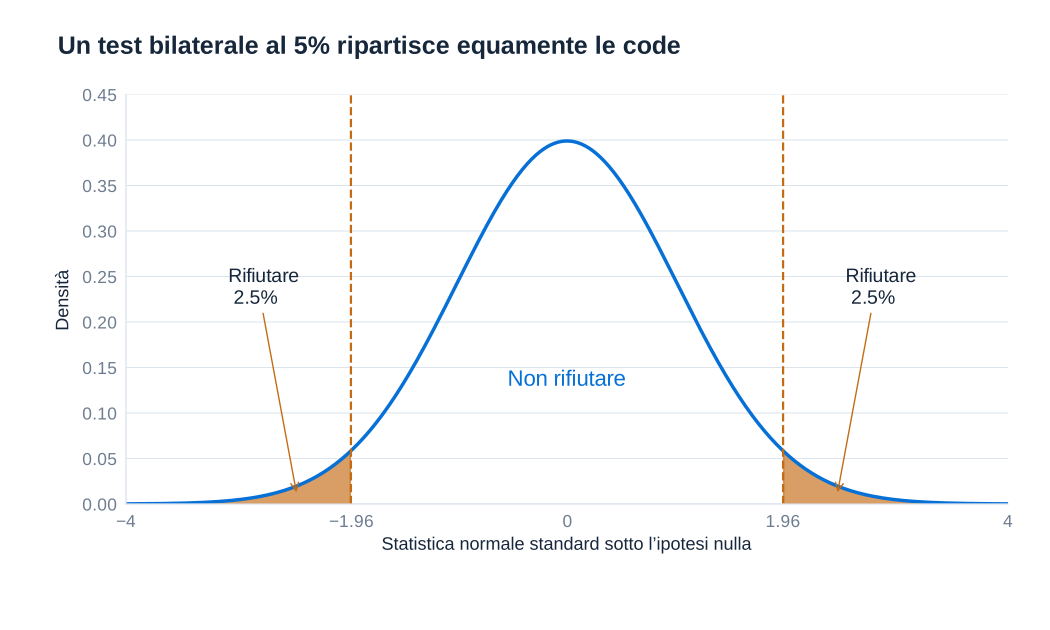
La consueta affermazione secondo cui circa il 95% di una distribuzione normale si trova entro due deviazioni standard è un'approssimazione utile; la probabilità normale centrale esatta tra e è circa il 95%, mentre l'intervallo da a contiene circa il 95.45%. Un test t esatto utilizza un valore critico basato sui propri gradi di libertà, che nei campioni finiti è maggiore di 1.96.
Un rifiuto non dimostra che vi sia una probabilità del 95% che l'alternativa sia vera. Il mancato rifiuto non dimostra che l'ipotesi nulla sia vera. I test possono commettere un errore di tipo I rifiutando un'ipotesi nulla vera oppure un errore di tipo II non rifiutando un'ipotesi nulla falsa. La potenza è la probabilità di rifiuto sotto una specifica alternativa; campioni piccoli e misurazioni rumorose possono rendere difficile individuare effetti economicamente importanti. I test unilaterali collocano la regione di rifiuto in una sola direzione e dovrebbero essere giustificati prima di esaminare il segno stimato.
I p-value esprimono l'incompatibilità con il modello sotto l'ipotesi nulla
Un p-value è la probabilità, calcolata sotto l'ipotesi nulla e le ipotesi statistiche mantenute, di ottenere una statistica test almeno tanto estrema quanto quella osservata. Per un test bilaterale basato sulla normale standard,
dove è la funzione di distribuzione cumulata della normale standard. Con un'appropriata distribuzione t di riferimento, la sua funzione di distribuzione cumulata sostituisce . Il calcolo comprende risultati più estremi della statistica osservata; non è la probabilità di ottenere esattamente quella stima.
Un p-value di 0.04 significa che, se valessero l'ipotesi nulla e il modello statistico, una statistica almeno altrettanto estrema si verificherebbe con probabilità del 4%. Costituisce evidenza contro quell'ipotesi nulla al livello del 5%, non una probabilità del 4% che l'ipotesi nulla sia vera né la prova che l'effetto stimato sia causale. Un p-value di 0.50 indica evidenza più debole contro l'ipotesi nulla, ma non dimostra che il vero effetto sia zero. Può riflettere un effetto piccolo, una stima imprecisa oppure entrambe le cose.
La significatività statistica è inoltre diversa dall'importanza economica. Un effetto minuscolo può produrre un p-value piccolo in un campione molto ampio, mentre una stima elevata ma imprecisa può non superare una soglia convenzionale. Le unità di misura dell'effetto, l'intervallo di confidenza, la rilevanza sostanziale e le ipotesi di identificazione dovrebbero accompagnare il p-value. Verificare molti risultati o molte specificazioni e riportare soltanto i p-value più piccoli modifica l'interpretazione dei livelli nominali di significatività.
Gli intervalli di confidenza conservano informazioni sull'entità dell'effetto
Un intervallo di confidenza bilaterale combina la stima con un margine di incertezza:
dove è il valore critico corrispondente al livello di confidenza e alla distribuzione di riferimento. Una procedura di confidenza al 95% è costruita in modo che, su campioni ripetuti e sotto le proprie ipotesi, circa il 95% degli intervalli risultanti contenga il parametro fisso della popolazione. Una volta calcolato uno specifico intervallo, i suoi estremi sono fissi e il parametro si trova al suo interno oppure no; l'interpretazione frequentista non è una probabilità a posteriori assegnata a quel parametro.
Quando l'intervallo e il test utilizzano le stesse ipotesi e la stessa distribuzione di riferimento, l'intervallo contiene i valori del parametro sotto l'ipotesi nulla che il corrispondente test bilaterale al 5% non rifiuterebbe. Se zero è esterno a un intervallo al 95%, il coefficiente è statisticamente distinguibile da zero a quel livello. Se zero è interno, l'intervallo può comunque includere valori positivi o negativi economicamente rilevanti. Leggere l'intero intervallo fornisce quindi più informazioni che aggiungere un asterisco di significatività alla stima puntuale.
Un esempio completo di regressione dei punteggi nei test
La regressione dei punteggi medi dei distretti nei test sul rapporto studenti/insegnanti utilizza 420 osservazioni ed errori standard robusti all'eteroschedasticità. L'equazione stimata è . La regressione spiega circa il 5.12% della variazione campionaria del risultato, quindi . La radice dell'errore quadratico medio è pari a 18.581 punti del test. Queste statistiche di adattamento descrivono l'adattamento della regressione al campione e la scala dei residui, non la validità di un'interpretazione causale.
| Regressore | Coefficiente | Errore standard robusto | Statistica t | p-value bilaterale | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Rapporto studenti/insegnanti | −2.279808 | 0.5194892 | −4.39 | < 0.001 | [−3.300945, −1.258671] |
| Intercetta | 698.933 | 10.36436 | 67.44 | < 0.001 | [678.5602, 719.3057] |
Verificare che il coefficiente del rapporto sia zero dà . L'output utilizza 418 gradi di libertà residui e riporta per la restrizione su un solo coefficiente; in questo caso la statistica F è il quadrato della statistica t, a meno degli arrotondamenti. Il p-value bilaterale del coefficiente del rapporto, usando questa distribuzione t di riferimento, è circa 0.0000145. Un p-value visualizzato come 0.000 dopo l'arrotondamento significa quindi molto piccolo, non letteralmente nullo.
Il valore critico t al 95% con 418 gradi di libertà è circa 1.96566. Applicandolo si ottiene l'intervallo riportato . L'approssimazione normale con 1.96 fornisce l'intervallo molto simile . Combinare un coefficiente fortemente arrotondato, un valore critico diverso ed estremi riportati con maggiore precisione creerebbe discrepanze aritmetiche apparenti, quindi nei calcoli occorre mantenere la precisione originaria fino alla presentazione finale.
L'intervallo descrive l'incertezza sull'associazione di regressione sotto le ipotesi del modello mantenuto. Un rapporto maggiore di un'unità è associato a una diminuzione compresa tra circa 1.26 e 3.30 punti del test a questo livello di confidenza. Rimane valido il ragionamento del capitolo precedente sul reddito omesso: gli errori standard robusti affrontano un problema di varianza, non il confondimento che può separare questo coefficiente dall'effetto causale di una variazione nella dimensione delle classi.
Eteroschedasticità ed errori standard robusti
Omoschedasticità significa che la varianza condizionata del disturbo è costante: . Eteroschedasticità significa che questa varianza cambia al variare dei regressori o di altre caratteristiche osservate. Un grafico può mostrare osservazioni più disperse intorno alla media condizionata per valori maggiori di . La pendenza di quella media e l'ampiezza della distribuzione del disturbo sono caratteristiche distinte del modello.
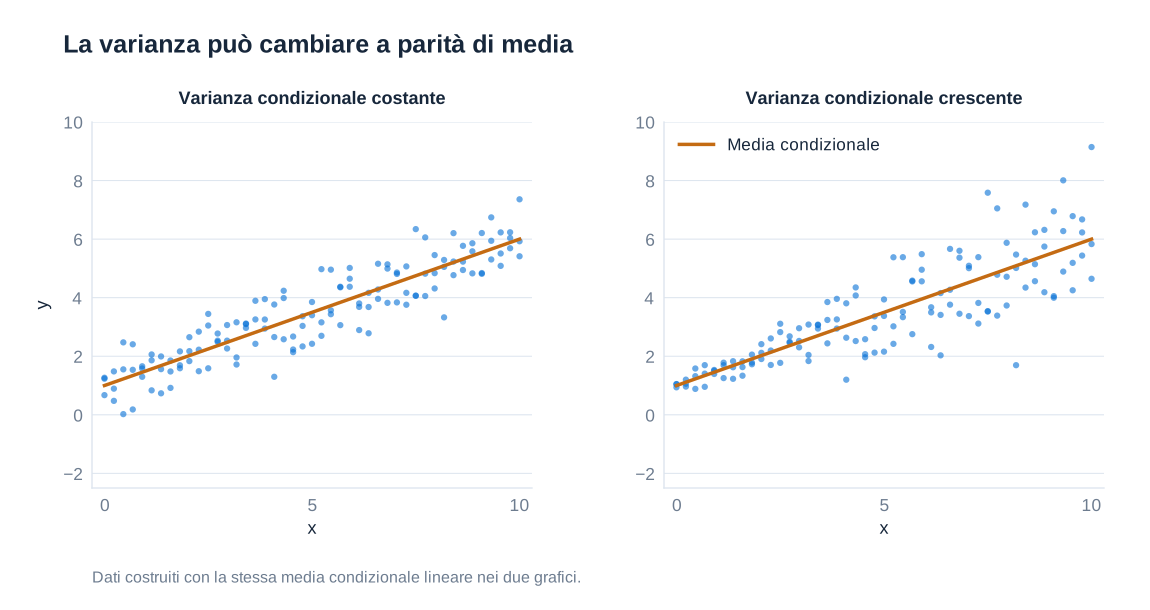
Se continuano a valere l'esogeneità e le condizioni di campionamento rilevanti, l'eteroschedasticità non rende di per sé inconsistenti i coefficienti OLS. Invalida però la formula convenzionale della varianza sotto omoschedasticità. Gli errori standard calcolati con tale formula possono essere troppo piccoli oppure troppo grandi; la distorsione verso il basso e la significatività sovrastimata sono preoccupazioni frequenti, ma la direzione non è garantita.
Per una regressione semplice con intercetta e osservazioni indipendenti, lo stimatore di base della varianza robusto all'eteroschedasticità può essere scritto come
Ogni residuo al quadrato contribuisce separatamente, consentendo alla varianza del disturbo di differire tra osservazioni. Altri stimatori robusti correggono per i gradi di libertà o per i valori di leva; la versione HC1 moltiplica la stima della varianza per . Passare dagli errori standard convenzionali a quelli robusti lascia invariate le stime puntuali OLS quando il campione e la specificazione della regressione non cambiano, ma può modificare intervalli di confidenza, statistiche t e p-value.
Gli errori standard robusti all'eteroschedasticità non sono una correzione generale per la dipendenza tra osservazioni, le variabili omesse o l'errore di misurazione. Possono inoltre essere poco affidabili in campioni piccoli o in presenza di osservazioni influenti. Il termine “robusto” descrive la specifica restrizione sulla varianza che viene allentata, non un'immunità da ogni problema di modellizzazione.
Osservazioni dipendenti e inferenza per cluster
Le osservazioni all'interno di un gruppo condividono spesso shock non osservati. Per osservazioni ripetute sugli Stati, un esempio semplice è , dove è una componente persistente dello Stato. Due osservazioni sullo stesso Stato possono quindi avere errori correlati nel tempo. In alternativa, rappresenta uno shock comune dell'anno che colpisce Stati diversi. Gli indici sono importanti perché questi processi implicano strutture di dipendenza diverse e, potenzialmente, scelte diverse di raggruppamento in cluster.
Gli aiuti federali ricevuti da uno Stato in anni successivi, per esempio, possono essere influenzati da caratteristiche persistenti dello Stato e da programmi in corso. Trattare ogni osservazione Stato-anno come una fonte di informazione indipendente può sovrastimare la precisione. Gli ordinari errori standard robusti all'eteroschedasticità ammettono varianze individuali diverse, ma omettono i termini di covarianza tra osservazioni differenti. Gli errori standard robusti per cluster conservano questi termini di covarianza interni al gruppo, facendo affidamento su un'appropriata indipendenza o dipendenza debole tra cluster.
Indicando la matrice dei regressori per il cluster con e il suo vettore dei residui con , lo stimatore di base della matrice di covarianza robusto per cluster è
Nella pratica si applicano spesso correzioni per campioni finiti. Il raggruppamento in cluster non richiede di calcolare medie dei dati ottenendo una sola osservazione per gruppo: la regressione può mantenere tutte le osservazioni individuali, mentre il calcolo della varianza riconosce la loro dipendenza. Il livello appropriato dipende dal disegno dello studio, dall'assegnazione del trattamento e dagli shock condivisi plausibili. In presenza di dipendenza persistente a livello di Stato, il raggruppamento per Stato ammette una correlazione arbitraria nel tempo all'interno dello stesso Stato. Una dipendenza che si manifesta sia all'interno degli Stati sia tra Stati nello stesso anno può richiedere un metodo che tenga conto di entrambe le dimensioni.
L'inferenza convenzionale per cluster dipende principalmente dal numero e dal comportamento dei cluster indipendenti, non semplicemente dal numero complessivo di righe. Non esiste una soglia universale oltre la quale diventi affidabile: pochi cluster molto grandi, un'assegnazione disomogenea del trattamento o valori di leva elevati possono rimanere problematici anche quando si rispetta una regola pratica numerica. Con pochi cluster, possono essere necessari metodi appropriati per piccoli campioni oppure un'inferenza basata sul disegno dello studio. Infine, la dipendenza seriale non deve essere confusa con l'esogeneità: cambiare lo stimatore dell'errore standard non corregge un coefficiente reso inconsistente dalla correlazione tra regressori e disturbi.
5. Relazioni non lineari e forme funzionali
Perché una retta può essere troppo restrittiva
Una regressione lineare assegna una pendenza costante a un regressore: in , un aumento di di un’unità modifica il valore stimato dell’esito di , qualunque sia il punto di partenza. Può essere un’utile approssimazione locale, ma non è una descrizione universale del comportamento economico. Un’ora aggiuntiva di studio può migliorare il rendimento più quando uno studente ha studiato poco che dopo una preparazione prolungata. Un aumento degli agenti di polizia può avere associazioni diverse con la criminalità nelle città con organici insufficienti e in quelle con organici consistenti. Anche la relazione tra reddito familiare e rendimento scolastico può appiattirsi all’aumentare del reddito. Ciascun esempio suggerisce di esaminare la forma della relazione anziché imporre automaticamente una pendenza costante.
Un diagramma di dispersione del reddito medio dei distretti e dei punteggi medi nei test può aiutare a evidenziare questo problema. Se la retta stimata non coglie sistematicamente la curvatura della nuvola di punti, i suoi residui possono essere positivi in alcune fasce di reddito e negativi in altre. Una specificazione non lineare può rappresentare questo andamento con maggiore precisione. Si tratta di un’affermazione sulle medie condizionate, non di una garanzia di causalità: il reddito può essere correlato con le risorse familiari, l’istruzione dei genitori, le condizioni del quartiere e altre determinanti dei risultati. Modificare la curva non elimina la distorsione da variabili omesse.
Il termine “non lineare” può riferirsi ad aspetti diversi. Una regressione quadratica è non lineare nel regressore, ma lineare nei suoi coefficienti incogniti. I minimi quadrati ordinari possono quindi stimarla dopo aver costruito il quadrato del regressore. Un modello come rimane un modello di regressione lineare in questo senso statistico. Al contrario, un modello di probabilità con una funzione di ripartizione normale è non lineare nei coefficienti e richiede generalmente un metodo di stima diverso.
Specificazioni quadratiche ed effetti marginali variabili
Una specificazione quadratica estende la retta aggiungendo un termine al quadrato. Indicando con il reddito del distretto e con il punteggio medio nei test, si scrive:
Il coefficiente di non rappresenta più la pendenza in ogni punto. Derivando la media condizionata si ottiene l’effetto marginale, misurato in punti del test per unità di reddito:
Se , la pendenza diminuisce all’aumentare del reddito, producendo una curva concava; se , la pendenza aumenta. La curva cambia direzione in , purché . Un punto di inversione esterno all’intervallo osservato non dovrebbe essere presentato come una scoperta empirica. Una curva concava stimata su un intervallo moderato può finire per implicare punteggi decrescenti per redditi implausibilmente elevati semplicemente perché si sta estrapolando un polinomio oltre i dati.
La derivata descrive una variazione infinitesima. Per una variazione finita , la differenza stimata esatta è . Con un aumento di un’unità, essa è pari a , non alla sola derivata nel punto iniziale. Distinguere le derivate dalle differenze finite è importante quando l’intervallo è ampio o la curvatura è marcata. Lo è anche quando si cambiano le unità: misurare il reddito in migliaia anziché in singole unità monetarie modifica entrambi i coefficienti, anche se le previsioni calcolate correttamente rimangono invariate.
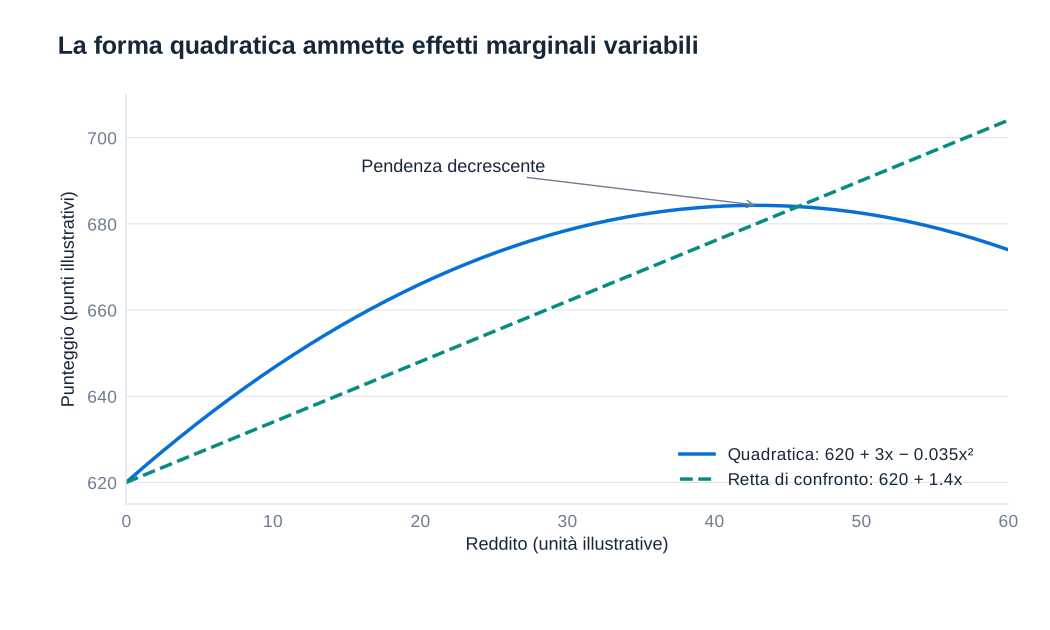
Una specificazione quadratica dovrebbe normalmente includere sia il termine lineare sia quello al quadrato. Eliminare il termine lineare impone una pendenza nulla in , un’ipotesi che richiede una giustificazione economica. Centrare il reddito attorno a un valore significativo può rendere più semplice interpretare l’intercetta e il coefficiente lineare senza modificare i valori stimati, purché il corrispondente modello trasformato includa tutti i termini necessari.
Logaritmi, variazioni proporzionali e asimmetria
Il logaritmo naturale trasforma le differenze moltiplicative in differenze additive. Il confronto che lo caratterizza è . Raddoppiare una variabile positiva aumenta sempre il suo logaritmo di , sia che la variazione originaria vada da 1 a 2 sia che vada da 100 a 200. Questo rende i logaritmi utili quando le differenze proporzionali sono più informative di quelle assolute. Salvo esplicita indicazione di un’altra base, e indicano qui il logaritmo naturale, di base .
Per una piccola variazione proporzionale , . Aumentare il reddito da 100 a 101 significa un incremento dell’1% e modifica il logaritmo del reddito di circa 0.01. Aumentarlo da 1 a 2 significa un incremento del 100% e modifica il logaritmo del reddito di circa 0.693; trattare questa differenza logaritmica come pari a 1 sarebbe un’approssimazione imprecisa. Una scala logaritmica non sostituisce letteralmente ogni differenza con la relativa variazione percentuale. Esprime rapporti in unità logaritmiche, che approssimano bene le variazioni proporzionali soltanto quando queste sono piccole.
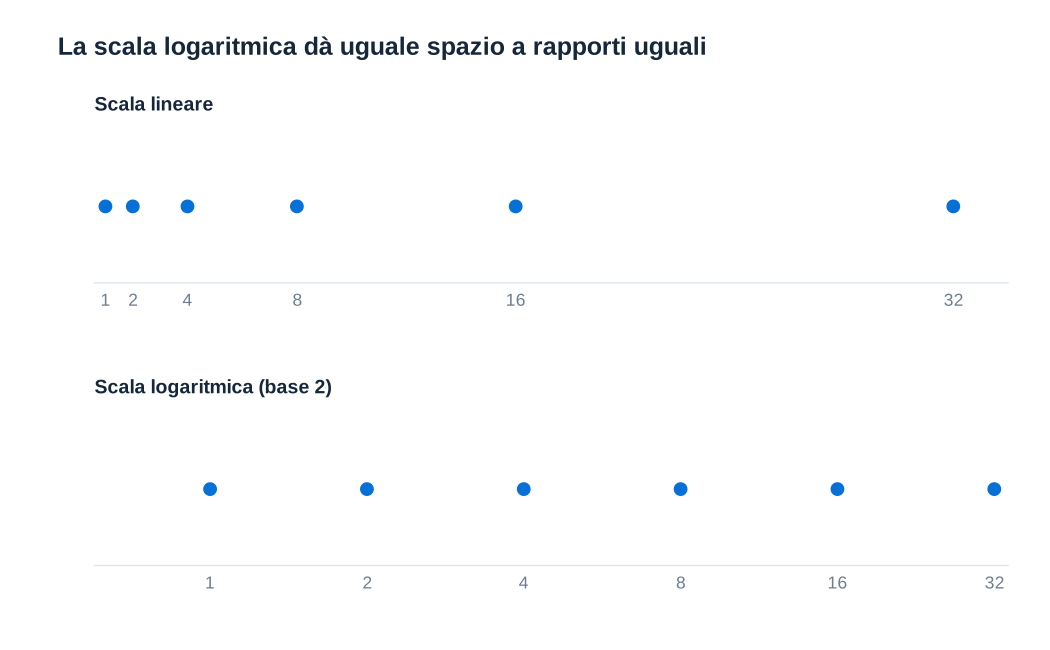
Applicare il logaritmo a una variabile positiva comprime anche i valori elevati. Il reddito presenta spesso una lunga coda destra e un istogramma del logaritmo del reddito può risultare più equilibrato di un istogramma del reddito. Tuttavia, la trasformazione logaritmica non garantisce la normalità e la distribuzione normale dei regressori non è un requisito dell’OLS. La trasformazione dovrebbe riflettere la relazione modellata e l’interpretazione desiderata. Cambia anche il trattamento dei dati: il logaritmo a valori reali non è definito per zero e per osservazioni negative. Aggiungere una costante arbitraria prima di applicare il logaritmo modifica il modello e non deve essere considerato un rimedio innocuo.
Il modello lineare–log: unità dell’esito per variazioni proporzionali dell’input
Quando l’esito rimane espresso in livelli ma al regressore viene applicato il logaritmo, il modello è:
L’effetto marginale nelle unità originarie è , quindi uno stesso aumento assoluto di ha un effetto stimato minore per valori iniziali più elevati. Un aumento dell’1% di modifica il valore stimato dell’esito esattamente di , ossia di circa unità di . Se è il punteggio di un test e , un aumento del reddito dell’1% corrisponde a circa 0.2 punti del test, non a un aumento del 20% dei punteggi. Il coefficiente resta legato alle unità dell’esito.
Per qualsiasi confronto finito da a , la differenza stimata è . Raddoppiare il regressore modifica il valore stimato dell’esito di , non di . Quest’ultima variazione corrisponderebbe a moltiplicare il regressore per . Cambiare l’unità monetaria di un regressore di reddito positivo sposta il suo logaritmo di una costante e modifica l’intercetta, lasciando invece invariate la pendenza e le differenze stimate.
Questa forma è particolarmente utile quando la relazione nei dati originari presenta una curvatura, ma la relazione tra l’esito e il logaritmo dell’input appare più vicina a una retta. Implica una forma specifica: con un coefficiente positivo, l’esito aumenta a un tasso decrescente al crescere dell’input. Senza termini aggiuntivi non può rappresentare ogni possibile andamento, come una relazione effettivamente a forma di U.
Esiti in logaritmi: semielasticità ed elasticità
In un modello log–lineare, , un aumento di un’unità di modifica il logaritmo stimato dell’esito di . L’interpretazione abituale, una variazione di circa il % di , è precisa soltanto per coefficienti piccoli. Il confronto proporzionale esatto implicato dai valori logaritmici stimati è:
per una variazione di unità di . Pertanto, un coefficiente di 0.04 corrisponde a circa il 4.08% per un aumento di un’unità, mentre un coefficiente di 0.42 corrisponde a circa il 52.20%, rendendo l’approssimazione lineare molto meno soddisfacente. Un coefficiente negativo di −0.50 implica un valore inferiore di circa il 39.35%, non del 50%.
In senso rigoroso, applicare l’esponenziale a una media condizionata dei logaritmi degli esiti descrive una media geometrica condizionata, non automaticamente la media aritmetica condizionata dell’esito originario. Da , quest’ultima è . Se il secondo fattore differisce tra le osservazioni confrontate, applicare l’esponenziale alla sola differenza logaritmica stimata non restituisce il rapporto tra le medie aritmetiche. Questa distinzione è importante quando si prevedono spese totali o retribuzioni medie in unità monetarie.
Quando entrambe le variabili sono in logaritmi, , la pendenza è un’elasticità: . Un piccolo aumento dell’1% di corrisponde a una variazione di circa il % di . Per un aumento proporzionale finito , la variazione proporzionale stimata esatta è %. La specificazione log–log assume un’elasticità costante, mentre quella log–lineare assume una semielasticità costante. Sono restrizioni sostanziali, non modi intercambiabili di presentare la stessa regressione.
Scegliere una forma funzionale
La scelta del modello parte dalla domanda economica, dalle unità di misura e dall’intervallo delle osservazioni. I diagrammi di dispersione aiutano a individuare la curvatura e le osservazioni influenti; i grafici dei residui aiutano a rilevare andamenti sistematici lasciati senza spiegazione da un modello stimato. Un regressore asimmetrico può suggerire di considerare una trasformazione logaritmica, ma l’asimmetria, da sola, non dimostra che la media condizionata sia lineare nel suo logaritmo. La stessa distinzione vale per un esito asimmetrico: applicargli il logaritmo cambia il parametro oggetto di stima e il peso attribuito agli errori proporzionali rispetto a quelli assoluti.
Quando possibile, confrontare i modelli candidati utilizzando le stesse osservazioni, verificare se le loro implicazioni siano plausibili nell’intervallo dei dati e considerare la capacità predittiva su osservazioni non utilizzate per la stima. I valori ordinari di di una regressione con esito in livelli e di una con esito in logaritmi non sono misure direttamente confrontabili dell’adattamento alla stessa variabile dipendente. Un valore più elevato dopo aver cambiato la scala dell’esito non dimostra, da solo, che il modello sia migliore.
Anche l’interpretabilità ha valore. Una specificazione parsimoniosa che risponde a una domanda chiara può essere più utile di una curva elaborata dal comportamento instabile. Riportare gli effetti marginali o i confronti stimati effettivamente rilevanti per l’applicazione. In un modello quadratico, indicare il livello di reddito al quale viene valutata la pendenza; in un modello logaritmico, distinguere una variazione di un’unità da una variazione dell’1%. Una forma funzionale convincente richiede comunque una strategia di identificazione credibile prima che ai suoi coefficienti possa essere attribuita un’interpretazione causale.
Interazioni e relazioni eterogenee
Un modello additivo, , rende la pendenza rispetto a un regressore indipendente dall’altro. Questo può essere troppo restrittivo. Le precipitazioni possono avere un’associazione diversa con gli incidenti stradali quando la guida in condizioni di alterazione è più diffusa. Le condizioni economiche locali possono modificare la relazione tra le preferenze di politica economica del partito al governo e la spesa pubblica. Un’interazione consente alla pendenza di variare sistematicamente:
Il coefficiente principale è ora la pendenza di quando , mentre è la pendenza di quando . Il coefficiente dell’interazione misura come cambia una pendenza all’aumentare dell’altro regressore. Non dovrebbe essere interpretato isolatamente come l’intero effetto di una delle due variabili. Mantenere entrambi gli effetti principali evita generalmente di imporre restrizioni arbitrarie di annullamento.
Se è un indicatore binario, confrontare le previsioni per e anziché immaginare una variazione infinitesima dell’appartenenza a un gruppo. In , la differenza tra i gruppi è . La sua incertezza dipende sia dalle varianze dei coefficienti sia dalla loro covarianza:
Di conseguenza, una banda di confidenza per l’effetto combinato non può essere ricostruita a partire dai soli due errori standard riportati. Le interazioni rivelano eterogeneità in una relazione stimata; non stabiliscono, da sole, perché tale eterogeneità si manifesti.
Esempio svolto: istruzione, esperienza e divario retributivo di genere
Si consideri un campione di 1,084 individui della Current Population Survey statunitense. L’esito è il logaritmo naturale della retribuzione oraria; istruzione ed esperienza sono misurate in anni; è pari a 1 per le donne e a 0 per gli uomini. Quattro regressioni annidate mostrano come cambia l’interpretazione quando si aggiungono variabili di controllo e un’interazione. I numeri tra parentesi sono errori standard. “Non incluso” significa che il regressore è assente da quella specificazione, non che il suo coefficiente sia stato stimato pari a zero.
| Regressore | Modello 1 | Modello 2 | Modello 3 | Modello 4 |
|---|---|---|---|---|
| Istruzione, anni | 0.0692 (0.00556) | 0.0712 (0.00538) | 0.0874 (0.00562) | 0.0793 (0.00630) |
| Indicatore donna | Non incluso | −0.272 (0.0302) | −0.269 (0.0284) | −0.594 (0.147) |
| Esperienza, anni | Non incluso | Non incluso | 0.0339 (0.00392) | 0.0347 (0.00391) |
| Esperienza al quadrato | Non incluso | Non incluso | −0.000473 (0.0000847) | −0.000492 (0.0000843) |
| Donna × istruzione | Non incluso | Non incluso | Non incluso | 0.0253 (0.0116) |
| Osservazioni | 1,084 | 1,084 | 1,084 | 1,084 |
Il Modello 1 associa un anno aggiuntivo di istruzione a retribuzioni orarie superiori di circa il 6.92%. L’aggiunta dell’indicatore donna nel Modello 2 modifica tale pendenza e introduce un confronto condizionato tra gruppi. Il Modello 3 aggiunge l’esperienza e il suo quadrato. Il coefficiente positivo dell’esperienza e quello negativo del termine al quadrato descrivono un profilo concavo: l’esperienza aggiuntiva iniziale ha un’associazione stimata maggiore di quella aggiuntiva successiva. Questi cambiamenti illustrano perché un coefficiente sia condizionato al resto della specificazione; non identificano quale regressione abbia risolto tutti i problemi di selezione.
Il Modello 4 consente alla pendenza dell’istruzione di differire per genere. Per gli uomini, la pendenza del logaritmo della retribuzione è 0.0793; per le donne è . Le variazioni proporzionali stimate esatte per un anno aggiuntivo sono rispettivamente di circa l’8.25% e l’11.03%, secondo l’interpretazione degli esiti in logaritmi descritta sopra. La pendenza dell’esperienza è . Il suo punto di inversione stimato è circa 35.26 anni, la cui rilevanza sostanziale dipende dall’intervallo dei valori osservati e dall’adeguatezza della specificazione quadratica.
Interpretare e rappresentare il confronto completo tra generi
Nel Modello 4, il coefficiente dell’indicatore donna non rappresenta il divario retributivo a ogni livello di istruzione. Mantenendo costante l’esperienza, la differenza stimata donne meno uomini nei logaritmi delle retribuzioni al livello di istruzione è:
A zero anni di istruzione, ciò implica un rapporto stimato tra le medie geometriche delle retribuzioni pari a , ossia un valore inferiore di circa il 44.79%, anziché del 59.4%. Anche un’istruzione pari a zero può essere lontana dalla maggior parte delle osservazioni, rendendo il confronto tra intercette poco adatto come sintesi principale. A 12 anni il divario stimato è circa −25.20%; a 16 anni è −17.24%; e a 18 anni è −12.94%. Queste percentuali utilizzano , non l’approssimazione applicata a coefficienti elevati.
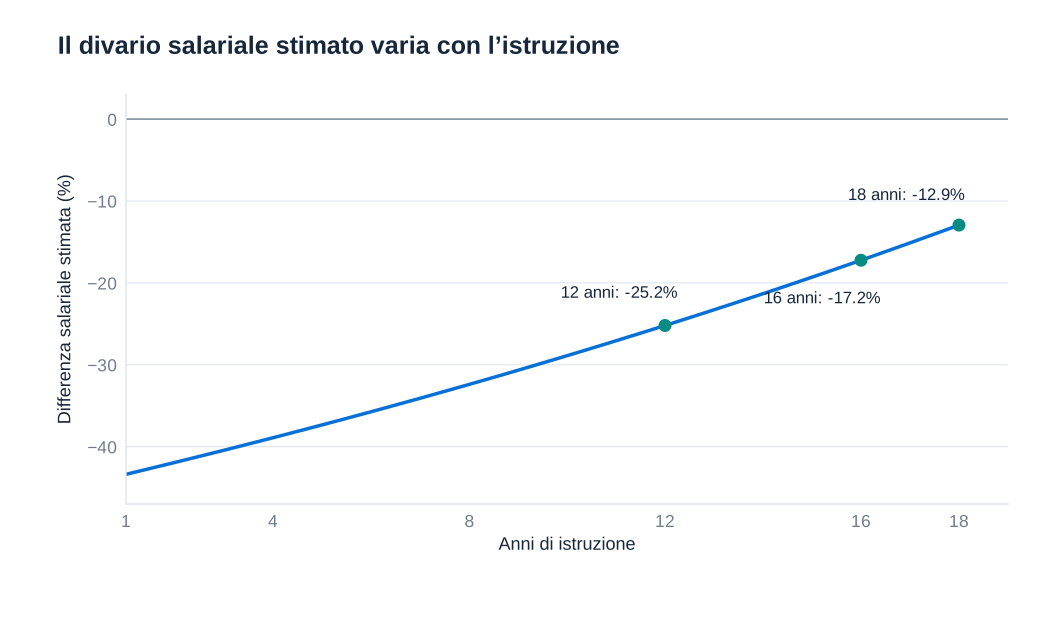
Ogni anno aggiuntivo di istruzione aumenta di 0.0253 la differenza donne meno uomini nei logaritmi delle retribuzioni. Non riduce il divario retributivo percentuale esatto di un valore costante di 2.53 punti percentuali, perché l’esponenziale è non lineare. Ponendo uguale a zero la differenza logaritmica stimata si ottengono circa 23.48 anni di istruzione. Questo punto di intersezione algebrico si trova oltre l’intervallo di 1–18 anni illustrato qui e non dovrebbe essere interpretato come prova che un determinato numero di anni di istruzione elimini la disuguaglianza retributiva.
La regressione documenta associazioni condizionate. Differenze nell’occupazione, nelle ore lavorate, nell’anzianità presso il datore di lavoro, nella selezione nell’occupazione e in altre caratteristiche non osservate possono ancora influenzare le stime. Inoltre, controllare per queste variabili non risolve automaticamente una questione di discriminazione, poiché alcuni controlli possono riflettere a loro volta disparità di opportunità. Una conclusione empirica utile precisa quale misura della retribuzione, quale campione, quali controlli e quale livello di istruzione vengono confrontati, separando tale confronto da qualsiasi affermazione causale più ampia.
6. Variabili dummy ed esiti binari
Indicatori, categorie e confronti che rappresentano
Una variabile binaria o dummy assume il valore 1 quando si verifica una condizione definita e 0 altrimenti. Lo stato occupazionale, la vista sull’oceano di un appartamento e la presenza di ipertensione sono alcuni esempi. Le variabili binarie sono un caso particolare di variabili categoriali, che classificano le osservazioni in un insieme limitato di gruppi. La codifica deve essere dichiarata esplicitamente: invertire 0 e 1 inverte l’interpretazione del confronto associato.
Un codice numerico di categoria non è necessariamente una misurazione quantitativa. Codificare i gruppi sanguigni A, B, AB e O come 1, 2, 3 e 4 non rende il gruppo O “quattro volte” il gruppo A, né stabilisce differenze biologiche equidistanti. Trattare questi codici come un unico regressore continuo imporrebbe un ordinamento arbitrario e variazioni costanti. Indicatori separati consentono a ciascun gruppo di avere una propria media condizionata rispetto a una categoria di riferimento scelta.
Le variabili binarie possono essere utilizzate in regressione in due modi distinti. Un indicatore nel membro di destra rappresenta un confronto tra gruppi, lasciando invariata la natura dell’esito. Un indicatore nel membro di sinistra rende la media condizionata una probabilità, introducendo restrizioni che una comune retta può non rispettare. I principi di stima restano collegati, ma l’interpretazione e gli opportuni controlli diagnostici differiscono.
Una variabile dummy come variabile esplicativa
Si supponga di modellare il canone mensile di un appartamento, in unità monetarie, utilizzando il numero di stanze e un indicatore della vista sull’oceano:
Per un numero di stanze fissato, il canone stimato è senza vista sull’oceano e con la vista. Quindi è la differenza condizionata nel canone mensile, misurata nelle stesse unità monetarie del canone. Il modello assume che questa differenza non vari con il numero di stanze. Aggiungere allenterebbe tale restrizione, consentendo al sovrapprezzo per la vista di variare con le dimensioni dell’appartamento.
“Mantenere costante il numero di stanze” non significa che tutte le altre caratteristiche degli appartamenti siano identiche. Se gli immobili con vista sull’oceano hanno anche una posizione migliore o una qualità costruttiva superiore e queste variabili vengono omesse, il coefficiente può riflettere tali differenze. L’indicatore di gruppo non produce un’assegnazione casuale. Il suo coefficiente è un’associazione condizionata, a meno che le ipotesi di identificazione non giustifichino un’interpretazione ulteriore.
Se la variabile dipendente è il logaritmo del canone, il coefficiente cambia significato: la differenza proporzionale stimata esatta tra appartamenti con e senza vista è %, ferme restando le precisazioni sugli esiti in logaritmi del Capitolo 5. Se un indicatore interagisce con un altro regressore, il suo coefficiente considerato isolatamente si applica quando quell’altro regressore è zero e il confronto completo tra gruppi deve includere l’interazione.
Categorie multiple e trappola delle variabili dummy
Si consideri un esempio relativo ai distretti scolastici che suddivide la disponibilità di computer nelle categorie bassa, media e alta utilizzando il 25° e il 75° percentile. Per definire una classificazione completa, si assegnano alla categoria bassa i valori inferiori al 25° percentile, alla categoria media quelli dal 25° al 75° percentile inclusi e alla categoria alta quelli superiori al 75° percentile. I valori coincidenti richiedono una regola coerente per i confini; i gruppi non devono necessariamente contenere esattamente il 25%, il 50% e il 25% delle osservazioni.
Siano e gli indicatori di disponibilità media e alta. Utilizzando la disponibilità bassa come riferimento, si stima:
L’intercetta è la media del gruppo con disponibilità bassa e i due coefficienti di pendenza sono differenze rispetto a essa. Includere tutti e tre gli indicatori di gruppo insieme a un’intercetta produce multicollinearità perfetta, perché la loro somma è esattamente 1. È la trappola delle variabili dummy. Omettere una categoria mantenendo l’intercetta risolve il problema; in alternativa, omettere l’intercetta e mantenere tutte le categorie consente di stimare separatamente le medie dei gruppi. Nessuna delle due opzioni elimina le osservazioni del gruppo di riferimento.
| Termine | Coefficiente | Errore standard | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Media rispetto a bassa | 0.8566319 | 2.275697 | 0.38 | 0.707 | [−3.616636, 5.3299] |
| Alta rispetto a bassa | −0.9260766 | 2.627719 | −0.35 | 0.725 | [−6.091303, 4.23915] |
| Intercetta: categoria bassa | 653.9618 | 1.85367 | 352.79 | <0.001 | [650.3181, 657.6055] |
Le medie stimate sono circa 653.96 punti per la disponibilità bassa, 654.82 per quella media e 653.04 per quella alta. Entrambi gli intervalli delle differenze includono zero. Il test congiunto dei due coefficienti di categoria restituisce , con ; , corretto e una radice dell’errore quadratico medio pari a 19.085 punti del test. Questi risultati forniscono scarsa evidenza di differenze in questa semplice suddivisione. Non dimostrano che l’accesso ai computer sia privo di un effetto causale: la specificazione è un confronto tra gruppi senza aggiustamenti e la misura riguarda la disponibilità di computer, anziché un intervento assegnato casualmente.
Esiti binari e modello di probabilità lineare
Per un esito binario , il suo valore atteso condizionato è uguale alla sua probabilità di essere pari a 1: . Applicare l’OLS a un esito binario produce quindi un modello di probabilità lineare, o LPM. In , un aumento di un’unità di modifica la probabilità stimata di , ossia di punti percentuali. La scala è fondamentale: un coefficiente di 0.05 significa cinque punti percentuali, non automaticamente un aumento relativo del 5%.
Per i distretti scolastici, si definisce quando il punteggio medio del distretto nei test supera la media complessiva scelta e 0 altrimenti. Una regressione sul reddito medio del distretto produce i seguenti risultati. Il reddito viene mantenuto nelle unità registrate nel dataset, quindi la pendenza si applica a un’unità su quella scala; qualsiasi conversione monetaria deve essere applicata prima di interpretare una variazione espressa in unità diverse.
| Termine | Coefficiente | Errore standard robusto | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Reddito medio del distretto | 0.0328825 | 0.0029316 | 11.22 | <0.001 | [0.0271201, 0.038645] |
| Intercetta | 0.0034945 | 0.0504409 | 0.07 | 0.945 | [−0.095655, 0.102644] |
Le osservazioni sono 420; , la radice dell’errore quadratico medio è 0.44108 e il test complessivo robusto è , con . Un aumento del reddito di un’unità è associato a una probabilità superiore di circa 3.288 punti percentuali di ottenere un punteggio sopra la media. Questo confronto riguarda il superamento di una soglia binaria, non il numero di punti guadagnati nel test.
Limiti delle probabilità, eteroschedasticità e punti percentuali
Una retta non rimane necessariamente tra 0 e 1. Il modello scolastico stimato è , che supera 1 quando il reddito registrato supera circa 30.31. Per , prevede circa 1.319, una probabilità impossibile. Queste previsioni rivelano un limite della forma funzionale; limitarsi a troncarle a 1 non modifica il modello stimato e non fornisce un calcolo dell’effetto marginale fondato sul modello.
L’LPM impone anche una pendenza costante della probabilità. Un aumento del reddito ha lo stesso effetto stimato in prossimità di una probabilità di 0.05 e di 0.95, sebbene lo spazio per ulteriori diminuzioni o aumenti sia molto diverso. L’importanza di questa restrizione dipende dall’intervallo delle covariate e dallo scopo dell’analisi. Un’approssimazione lineare può essere utile in un intervallo centrale anche se si comporta male nelle code.
Con una probabilità condizionata specificata correttamente, la varianza dell’errore binario è . Essa varia quindi generalmente con i regressori, rendendo opportuni errori standard robusti all’eteroschedasticità. L’inferenza robusta affronta questo problema di varianza; non corregge probabilità impossibili, variabili omesse o una media condizionata errata. Se le osservazioni sono dipendenti all’interno dei gruppi, anche il calcolo degli errori standard deve tenere conto di tale dipendenza.
I punti percentuali e le variazioni percentuali rispondono a domande diverse. Una probabilità che passa dal 40% al 50% aumenta di 10 punti percentuali e del 25% rispetto al valore iniziale, perché . In un gruppo di dimensione fissa pari a 100, passare da 40 a 50 membri con una caratteristica illustra entrambe le affermazioni. Senza una probabilità di riferimento, un coefficiente dell’LPM non può essere convertito in un’unica variazione percentuale relativa.
Probit, logit e massima verosimiglianza
Probit e logit sostituiscono la retta di probabilità senza vincoli con una funzione di ripartizione regolare. Con un indice , il modello probit utilizza la funzione di ripartizione della normale standard :
La funzione è l’area sotto la densità normale standard a sinistra di . Trasforma ogni indice a valori reali in una probabilità strettamente compresa tra 0 e 1 per valori finiti. Il modello logit utilizza invece la funzione logistica:
Entrambe le curve si appiattiscono vicino ai rispettivi limiti inferiore e superiore. I coefficienti non trasformati descrivono variazioni di un indice, non variazioni della probabilità in punti percentuali. Per un regressore continuo senza interazioni, l’effetto marginale nel probit è , dove è la densità normale standard; l’effetto marginale nel logit è . La loro entità dipende da tutte le covariate attraverso l’indice. Un effetto marginale medio è la media di queste derivate specifiche delle singole osservazioni, mentre un effetto valutato alle covariate medie è una quantità diversa.
Per un regressore binario, calcolare la differenza discreta tra le probabilità previste quando il suo valore viene posto a 1 e a 0, mantenendo fisse le altre covariate. Le interazioni richiedono ancora maggiore attenzione: il segno del coefficiente di un termine di prodotto non coincide necessariamente, da solo, con il segno di ogni effetto di interazione sulla scala delle probabilità. Presentare probabilità stimate o confronti calcolati esplicitamente è spesso più chiaro.
Questi modelli vengono solitamente stimati mediante massima verosimiglianza anziché OLS. Per osservazioni indipendenti con probabilità , la log-verosimiglianza binaria è:
La massimizzazione seleziona i valori dei parametri che attribuiscono agli esiti osservati la massima verosimiglianza all’interno del modello specificato. Le previsioni di probit, logit e LPM possono essere simili in un intervallo centrale, ma non è garantito, soprattutto nelle code. La scelta tra questi modelli deve considerare il confronto di interesse, l’intervallo delle probabilità previste, la specificazione e l’interpretabilità. Un modello di probabilità non lineare fornisce limiti sensati, non un disegno di ricerca causale.
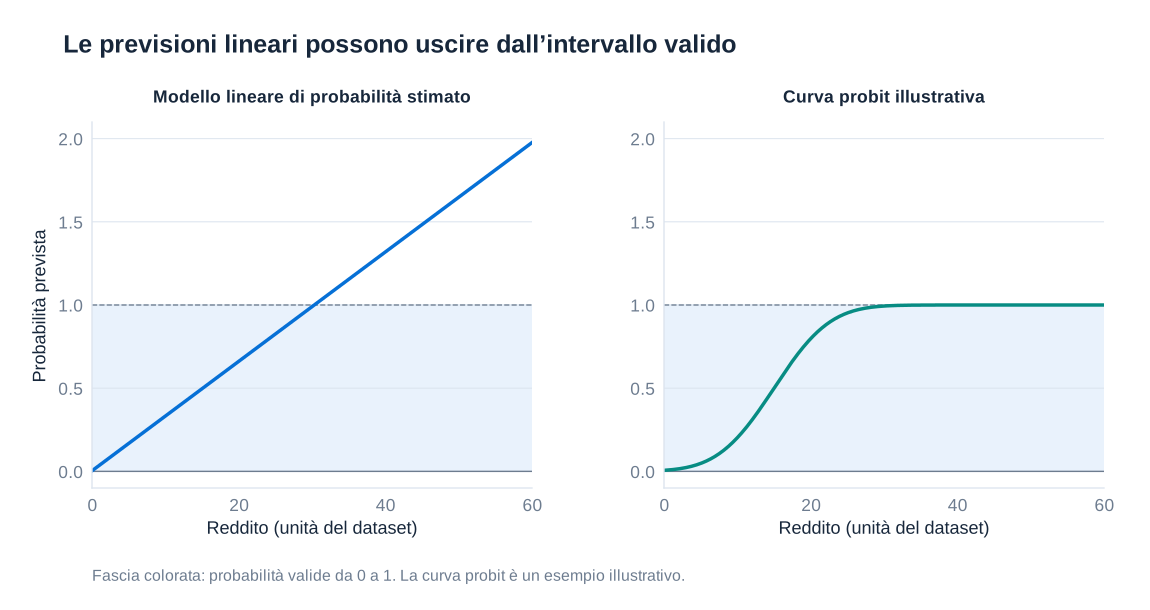
Leggere un risultato completo di regressione
Una tabella dei coefficienti contiene informazioni di natura diversa. Il coefficiente fornisce una relazione condizionata stimata nelle unità del modello. Il suo errore standard misura l’incertezza campionaria secondo lo stimatore della varianza scelto. Una statistica test confronta la stima con un valore ipotizzato, solitamente zero; il p-value descrive la compatibilità con tale ipotesi nulla date le assunzioni del test. Un intervallo di confidenza al 95% sintetizza un intervallo generato da una procedura con una copertura del 95% nel lungo periodo. Né il p-value né l’intervallo misurano la probabilità che una particolare spiegazione causale sia vera.
Il numero di osservazioni indica il campione effettivamente utilizzato. è la quota della variabilità campionaria dell’esito spiegata dalla regressione stimata; corretto penalizza l’aggiunta di regressori e può essere negativo. La radice dell’errore quadratico medio esprime la dispersione dei residui nelle unità della variabile dipendente. Il test F complessivo valuta una restrizione congiunta sui coefficienti di pendenza. Nessuna di queste statistiche sostituisce la valutazione della rilevanza sostanziale degli effetti, un disegno di ricerca valido o un’attenta descrizione del campione.
| Relazione condizionata | Confronto | Interpretazione della variazione stimata |
|---|---|---|
| Un’unità in più di | unità di | |
| Un’unità in più di | Circa il %; confronto stimato esatto sulla scala logaritmica % | |
| 1% in più di | Circa unità dell’esito; esattamente | |
| 1% in più di | Circa il %; è l’elasticità | |
| binaria, modello di probabilità lineare | Un’unità in più di | punti percentuali |
I confronti con esiti in logaritmi si riferiscono direttamente ai valori logaritmici stimati e alle medie geometriche che essi implicano; i confronti tra medie aritmetiche richiedono le condizioni di ritrasformazione discusse nel Capitolo 5. Ogni interpretazione mantiene inoltre fissi gli altri regressori inclusi e rimane associativa, a meno che ipotesi aggiuntive non stabiliscano la causalità.
Esempio svolto: spesa sanitaria annua in livelli
Tre modelli utilizzano 2,970 osservazioni e le stesse variabili esplicative: l’età in anni, il logaritmo naturale del reddito personale e un indicatore di obesità pari a 1 per gli individui obesi e a 0 altrimenti. Il primo esito è la spesa sanitaria totale annua misurata in dollari statunitensi del 2005. I suoi coefficienti combinano quindi tre regole interpretative: un effetto livello–livello dell’età, un effetto livello–log del reddito e una differenza discreta tra gruppi.
| Termine | Coefficiente | Errore standard | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Età, anni | 202.1078 | 43.41592 | 4.66 | <0.001 | [116.9794, 287.2362] |
| ln(reddito personale) | −260.2222 | 772.2026 | −0.34 | 0.736 | [−1774.329, 1253.885] |
| Indicatore di obesità | 1251.303 | 588.4134 | 2.13 | 0.034 | [97.56308, 2405.043] |
| Intercetta | −4462.544 | 7241.433 | −0.62 | 0.538 | [−18661.29, 9736.197] |
Mantenendo fissi il reddito e la condizione di obesità, un anno aggiuntivo di età è associato a una spesa annua superiore di circa USD 202.11. Un aumento del reddito dell’1% corrisponde a una spesa inferiore di circa USD 2.60, perché il coefficiente moltiplica la variazione del logaritmo del reddito; la variazione stimata esatta è . La stima relativa al reddito è molto imprecisa e il suo intervallo include valori positivi e negativi rilevanti, quindi la stima puntuale negativa non dovrebbe essere presentata come prova acquisita che il reddito riduca la spesa.
A parità di età e reddito, il gruppo degli individui obesi presenta una spesa annua stimata superiore di USD 1,251.30. Il suo intervallo va da circa USD 97.56 a USD 2,405.04. L’intercetta descrive un individuo non obeso con età pari a zero e logaritmo del reddito pari a zero, ossia un reddito uguale a uno nell’unità monetaria registrata. Questa combinazione non è generalmente rappresentativa sul piano sostanziale; un’intercetta negativa non implica una spesa negativa per una persona tipica.
La regressione presenta , corretto e una radice dell’errore quadratico medio pari a 14,058 USD. Il test congiunto restituisce , con . L’evidenza statistica di una qualche associazione può coesistere con una bassa capacità esplicativa e ampi errori di previsione individuali. Le stime non isolano effetti causali dell’invecchiamento, del reddito o dell’obesità senza ulteriori ipotesi sulle condizioni di salute omesse, sulla selezione e su altre determinanti della spesa.
Esempio svolto: spesa sanitaria in logaritmi
Il secondo modello utilizza il logaritmo naturale della spesa annua. Riguarda quindi differenze proporzionali nella spesa e richiede osservazioni con spesa positiva affinché il logaritmo sia definito. Sebbene la numerosità campionaria riportata rimanga 2,970, non si dovrebbe mai presumere che un qualsiasi dataset non contenga spese nulle soltanto perché una specificazione logaritmica è comoda.
| Termine | Coefficiente | Errore standard | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Età, anni | 0.0419183 | 0.0058171 | 7.21 | <0.001 | [0.0305124, 0.0533243] |
| ln(reddito personale) | −0.1696737 | 0.1034636 | −1.64 | 0.101 | [−0.3725414, 0.0331939] |
| Indicatore di obesità | 0.420106 | 0.0788386 | 5.33 | <0.001 | [0.2655222, 0.5746899] |
| Intercetta | 6.448543 | 0.9702434 | 6.65 | <0.001 | [4.546125, 8.350962] |
Il coefficiente dell’età corrisponde a una spesa superiore di circa il 4.19% per ogni anno aggiuntivo, oppure a una differenza stimata esatta tra medie geometriche pari a %. Il coefficiente del reddito è un’elasticità: un aumento del reddito dell’1% è associato a una spesa inferiore di circa lo 0.170%, mantenendo fisse l’età e la condizione di obesità. Il valore esatto per la variazione finita è circa −0.169%. Il suo intervallo di confidenza include zero e il p-value è 0.101, quindi i dati non dimostrano un’associazione del reddito diversa da zero al livello convenzionale del 5%.
Il coefficiente dell’obesità è abbastanza elevato da rendere fuorviante la comune approssimazione per coefficienti piccoli. La differenza stimata esatta è %, anziché il 42%. Questo confronto riguarda medie geometriche condizionate. Descriverlo come una differenza del 52.21% nella spesa media aritmetica richiederebbe anche un’ipotesi o un calcolo di ritrasformazione appropriati. L’intercetta è il logaritmo stimato della spesa per la combinazione di covariate di riferimento, non la spesa in dollari.
Il modello riporta , corretto, una radice dell’errore quadratico medio pari a 1.8836 unità logaritmiche e , con . Il suo non può essere confrontato direttamente con quello del Modello 1 per decidere quale preveda meglio la spesa in dollari, perché sono cambiate la variabile dipendente e la scala dei residui.
Esempio svolto: la probabilità di ipertensione
Il terzo esito è pari a 1 se un individuo presenta ipertensione e a 0 altrimenti. L’OLS stima quindi un LPM. I coefficienti dell’età e dell’obesità descrivono differenze di probabilità; il coefficiente del reddito combina un esito di probabilità con un regressore in logaritmi.
| Termine | Coefficiente | Errore standard | Statistica t | p-value | Intervallo di confidenza al 95% |
|---|---|---|---|---|---|
| Età, anni | 0.0053784 | 0.001421 | 3.79 | <0.001 | [0.0025922, 0.0081646] |
| ln(reddito personale) | 0.0914678 | 0.0252735 | 3.62 | <0.001 | [0.0419125, 0.1410232] |
| Indicatore di obesità | 0.1987462 | 0.0192582 | 10.32 | <0.001 | [0.1609854, 0.2365071] |
| Intercetta | −0.6557299 | 0.2370055 | −2.77 | 0.006 | [−1.120442, −0.191018] |
Un anno aggiuntivo di età è associato a una probabilità superiore di punti percentuali. Un aumento del reddito dell’1% modifica la probabilità stimata di circa , ossia di 0.0914678 punti percentuali. Utilizzando la variazione logaritmica esatta si ottengono circa 0.0910135 punti percentuali. Moltiplicare per 100 senza tenere conto anche della variazione logaritmica di 0.01 sovrastimerebbe questo confronto di un fattore pari a 100.
Il gruppo degli individui obesi presenta una probabilità stimata superiore di 19.87462 punti percentuali, condizionatamente a età e reddito. Non si tratta di un aumento relativo del 19.87%: il valore relativo richiederebbe una probabilità di riferimento specificata. L’intercetta negativa illustra nuovamente perché una situazione di riferimento esterna all’intervallo utile dei dati non costituisca, da sola, una probabilità plausibile. Le previsioni dovrebbero essere esaminate in corrispondenza dei valori effettivi delle covariate.
I risultati riportano , corretto, una radice dell’errore quadratico medio pari a 0.46012 e , con . Gli errori standard mostrati sono errori standard OLS convenzionali, a differenza di quelli esplicitamente robusti dell’esempio sui distretti scolastici. Dato l’esito binario, un’analisi empirica corretta dovrebbe ricalcolare l’incertezza in modo robusto all’eteroschedasticità o comunque appropriato prima di affidarsi a questi test. Le interpretazioni dei coefficienti restano quelle indicate, ma la loro precisione statistica deve essere valutata utilizzando uno stimatore della varianza adeguato.
7. Dati panel ed effetti fissi
Un panel segue le stesse unità nel tempo. Il suo contributo distintivo è la possibilità di confrontare una persona, un'impresa, una città o un'altra unità con le proprie osservazioni precedenti. Questo modifica la fonte di informazione utilizzata da una regressione: le differenze persistenti tra unità possono essere separate dai cambiamenti al loro interno. La distinzione è utile ogni volta che una variabile esplicativa è correlata con caratteristiche stabili difficili da misurare. Da sola, tuttavia, non rende causale una relazione osservazionale.
Che cosa registra un panel
Indichiamo con le unità e con i periodi. Un'osservazione rappresenta il risultato dell'unità nel periodo ; è una variabile esplicativa che varia nel tempo. Un panel di città potrebbe registrare la popolazione, lo status di capitale e la presenza di centri di istruzione superiore in date successive. La longitudine è una caratteristica invariante nel tempo, indicata con , perché il suo valore non cambia all'interno della stessa città. Lo status di capitale può cambiare, quindi rientra tra le variabili indicizzate sia da sia da .
Un panel bilanciato osserva ogni unità in ogni periodo e contiene osservazioni. Un panel non bilanciato presenta numeri di osservazioni diversi tra le unità. Questo può dipendere da entrate, uscite, misurazioni mancanti o dalla disponibilità storica dei dati. I dati non bilanciati non sono automaticamente invalidi: i metodi a effetti fissi possono utilizzare le osservazioni disponibili. Tuttavia, la scomparsa selettiva di osservazioni è rilevante. Se un'impresa smette di comunicare dati proprio quando si verifica uno shock negativo non osservato, analizzare soltanto i periodi in cui è osservata può introdurre una distorsione da selezione. Anche l'identificativo dell'unità deve rimanere coerente nel tempo; la modifica di un confine amministrativo può creare un cambiamento apparente che riflette, in parte, un cambiamento dell'oggetto misurato.
Le sezioni trasversali ripetute sono diverse. Osservare ogni anno un nuovo campione di lavoratori consente di confrontare gruppi nel tempo, ma non permette una trasformazione within a livello di lavoratore, a meno che sia possibile collegare le osservazioni degli stessi lavoratori. Le osservazioni ripetute di un panel forniscono informazioni aggiuntive, ma creano anche dipendenza: dieci misurazioni della stessa persona non equivalgono a dieci persone campionate indipendentemente.
Perché il pooled OLS può essere fuorviante
Consideriamo il modello additivo
La componente raccoglie tutte le caratteristiche stabili dell'unità che influenzano il risultato, comprese quelle non osservate. Il disturbo idiosincratico contiene le influenze che variano nel tempo. Una regressione pooled OLS che omette unisce le due componenti in un unico errore. Anche se il disturbo che varia nel tempo è esogeno, una correlazione tra e genera una distorsione da variabile omessa. Per esempio, una città con un porto naturalmente favorevole potrebbe presentare sia una maggiore attività commerciale sia una popolazione più numerosa in ogni periodo. Confrontare città ad alta e bassa attività commerciale mescola l'associazione tra attività e popolazione con il vantaggio persistente del porto.
La distinzione fondamentale è tra variazione tra unità, rappresentata dalle differenze nelle medie delle unità, e variazione all'interno delle unità, rappresentata dagli scostamenti dalla media di ciascuna unità. Una relazione pooled positiva può coesistere con una relazione interna alle unità piatta o negativa. Nessuna delle due stime dovrebbe essere interpretata senza precisare il confronto utilizzato. Gli effetti fissi escludono deliberatamente le differenze persistenti di livello come fonte di identificazione di .
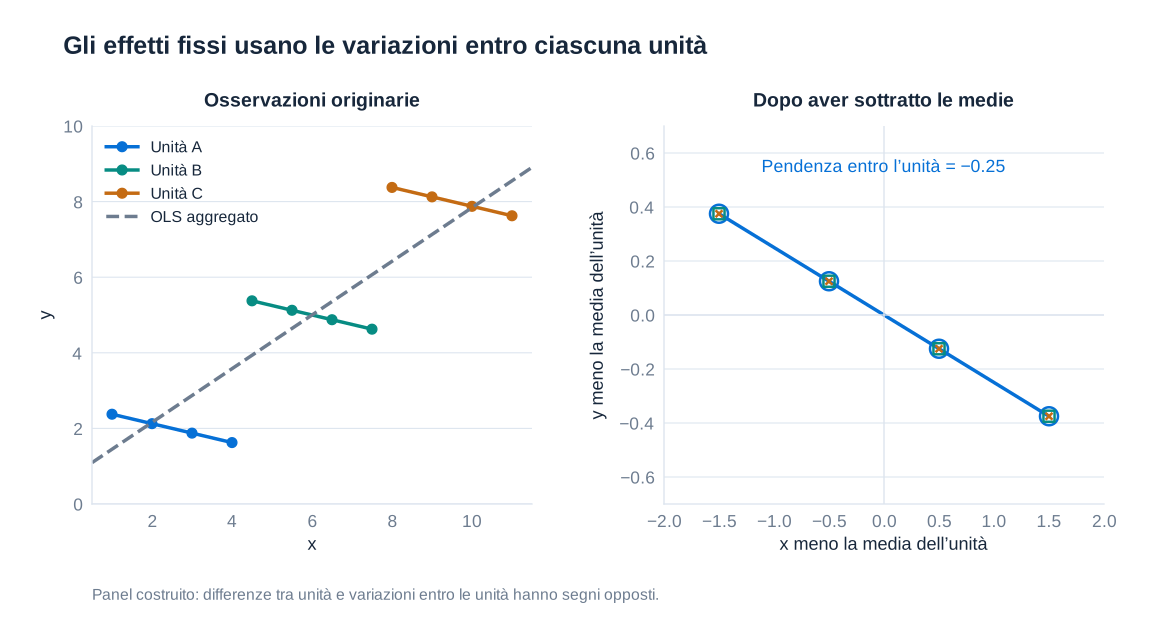
La trasformazione within
Per un panel bilanciato, calcoliamo la media temporale di ciascuna unità. Definiamo e definiamo e nello stesso modo. La media di è semplicemente . Sottraendo l'equazione delle medie dall'equazione originale si ottiene
Scompaiono sia l'intercetta comune sia quella specifica dell'unità. L'OLS applicato a queste variabili centrate rispetto alla propria media stima quindi la pendenza senza richiedere che sia incorrelata con . Con una sola variabile esplicativa, lo stimatore within è
Il denominatore evidenzia un requisito fondamentale: la variabile esplicativa deve cambiare all'interno di almeno alcune unità. Una variabile costante all'interno di ogni unità ha valore zero dopo la sottrazione della media e non può avere un coefficiente identificato separatamente. Per questo una regressione con effetti fissi di città non può stimare un effetto principale separato della longitudine. Il suo contributo è assorbito dall'intercetta della città. Anche una quantità ridotta di variazione interna alle unità può produrre stime imprecise, persino quando il dataset completo contiene molte osservazioni.
Per un panel non bilanciato, la media di ciascuna unità viene calcolata sui periodi in cui essa è osservata, utilizzando il proprio numero di osservazioni . Il procedimento algebrico rimane valido per un effetto additivo invariante nel tempo. Per formulare inferenze sulla popolazione di interesse restano necessarie ipotesi appropriate sul processo di osservazione.
Gli effetti fissi come indicatori di unità
La stessa pendenza può essere stimata assegnando a ciascuna unità una propria intercetta. In presenza di un'intercetta comune, si includono indicatori di unità; l'unità omessa fornisce l'intercetta di riferimento. In alternativa, si includono tutti gli indicatori e si omette l'intercetta comune. Includere sia un'intercetta comune sia tutti gli indicatori di unità genera multicollinearità perfetta, perché gli indicatori sommano a uno per ogni osservazione.
La regressione ai minimi quadrati con variabili dummy e la regressione within producono la stessa pendenza stimata quando sono applicate alle stesse osservazioni e agli stessi regressori. Il software deve inoltre tenere correttamente conto degli effetti fissi stimati nel calcolo degli aggiustamenti dei gradi di libertà. Scegliere un'unità di riferimento diversa modifica l'interpretazione dell'intercetta e dei coefficienti degli indicatori, ma non modifica i valori stimati né la pendenza del regressore che varia nel tempo. Le procedure di stima moderne assorbono grandi insiemi di effetti fissi, anziché costruire esplicitamente migliaia di colonne di indicatori.
Differenze prime
Un altro modo per eliminare consiste nel sottrarre l'osservazione precedente della stessa unità:
L'effetto fisso si annulla perché . Una regressione in differenze prime verifica se a un cambiamento della variabile esplicativa si accompagna un cambiamento del risultato. La costruzione delle differenze comporta la perdita dell'osservazione iniziale di ciascuna unità. Se mancano alcune date, righe registrate consecutive non devono essere automaticamente trattate come periodi consecutivi: un cambiamento nell'arco di due anni non è la stessa grandezza di un cambiamento annuale.
Con esattamente due periodi e lo stesso campione, le differenze prime e lo stimatore within producono la stessa pendenza. Con più di due periodi, entrambi eliminano un effetto additivo fisso, ma le loro stime non devono necessariamente coincidere. La loro efficienza relativa dipende dalla struttura seriale del disturbo idiosincratico. Il passaggio alle differenze può anche amplificare l'importanza dell'errore di misurazione quando la variabile vera cambia poco nel tempo. La scelta dovrebbe quindi riflettere il modello economico, la qualità dei dati e il processo degli errori.
Effetti di unità ed effetti di periodo
Un modello a effetti fissi a due vie comprende sia intercette di unità sia intercette di periodo:
Gli effetti di unità assorbono le differenze stabili tra unità: la localizzazione, vantaggi infrastrutturali persistenti o caratteristiche durevoli di un individuo. Gli effetti di periodo assorbono gli shock comuni a tutte le unità in una determinata data, come una recessione nazionale o un cambiamento tecnologico generale. Per le popolazioni urbane, un'ondata epidemica comune potrebbe essere rappresentata da un effetto di periodo soltanto nella misura in cui il suo effetto additivo sia condiviso dalle diverse città. Uno shock che colpisce i porti più intensamente delle città dell'entroterra non viene eliminato completamente da un'unica intercetta temporale comune.
In un panel bilanciato, sottrarre le medie di unità e le medie temporali e aggiungere la media complessiva elimina entrambi gli insiemi di intercette. Con osservazioni non bilanciate, questa semplice formula di doppia sottrazione delle medie in un solo passaggio è generalmente insufficiente; occorre uno stimatore che assorba correttamente entrambi gli effetti. Le variabili che si muovono in modo identico per ogni unità in ciascuna data sono collineari con gli effetti temporali. L'identificazione richiede quindi una variazione che rimanga dopo l'eliminazione di entrambi gli insiemi di effetti.
Esogeneità, dipendenza seriale e inferenza
Una condizione sufficiente standard per lo stimatore statico a effetti fissi è l'esogeneità stretta del disturbo idiosincratico:
Questa condizione ammette la correlazione tra i regressori e l'effetto stabile , ma esclude la correlazione tra un disturbo in un periodo e i regressori di qualsiasi periodo. È più forte dell'esogeneità contemporanea. Se un calo inatteso della popolazione urbana induce il governo a introdurre una politica nel periodo successivo, lo shock corrente è collegato a un regressore futuro. Sottrarre la media della città non elimina questa retroazione. Fattori omessi che variano nel tempo, determinazione simultanea e misurazione endogena restano possibili fonti di distorsione. Le variabili dipendenti ritardate richiedono particolare cautela nei panel brevi, perché la trasformazione within le rende generalmente correlate con il disturbo trasformato.
Le osservazioni ripetute creano anche un problema di inferenza. Dopo l'eliminazione degli effetti fissi, gli shock idiosincratici possono ancora essere persistenti all'interno delle unità. Gli errori standard robusti per cluster consentono eteroschedasticità e correlazione seriale all'interno di un cluster specificato, facendo affidamento su un'adeguata indipendenza tra cluster. Se la politica varia a livello di Stato, costruire i cluster soltanto a livello individuale può sottostimare notevolmente l'incertezza: molti individui condividono lo stesso shock di politica. Il livello dei cluster dovrebbe seguire il meccanismo di assegnazione e i disturbi comuni plausibili, e il numero di cluster indipendenti conta più del semplice numero di righe. Gli errori standard corretti per cluster affrontano il problema dell'incertezza; non correggono un regressore endogeno.
Effetti casuali e fonte della variazione identificante
Anche un modello a effetti casuali separa da , ma utilizza sia l'informazione interna alle unità sia quella tra unità. Nella sua forma convenzionale richiede che l'effetto di unità sia incorrelato con i regressori in tutte le date, condizionatamente ai controlli inclusi. Questa ipotesi è impegnativa quando, per esempio, la qualità non osservata della gestione influenza sia gli investimenti sia la produzione di un'impresa. Se l'ipotesi è credibile, gli effetti casuali possono migliorare l'efficienza e stimare i coefficienti di regressori invarianti nel tempo che gli effetti fissi assorbono.
Gli effetti casuali sono quindi una scelta sostanziale di modellizzazione, non un metodo obsoleto. Gli approcci a effetti casuali correlati possono allentare l'ipotesi convenzionale includendo esplicitamente funzioni della storia dei regressori di un'unità, come le medie temporali. Un confronto tra stime a effetti fissi e a effetti casuali può essere informativo, ma un test automatizzato non può stabilire la credibilità economica di tutte le ipotesi identificanti. Soprattutto, una tabella contenente coefficienti per caratteristiche geografiche invarianti nel tempo non può essere descritta come una regressione standard a effetti fissi di città che stima anche gli effetti principali di tali caratteristiche geografiche.
Sviluppo urbano di lungo periodo: leggere una tabella empirica
Lo studio di Bosker, Buringh e van Zanden sullo sviluppo urbano tra l'800 e il 1800 raccoglie informazioni su 793 città in Europa, Medio Oriente e Nord Africa. Il contesto distingue la geografia stabile dalle istituzioni che cambiano. L'accesso al mare e le reti di trasporto possono influenzare il commercio, mentre lo status politico e religioso può modificare il ruolo amministrativo o economico di una città. La copertura storica e la disponibilità delle variabili fanno sì che i campioni delle singole regressioni non debbano necessariamente contenere ogni città in ogni data.
La seguente tabella di base presenta una specificazione a effetti casuali con ulteriori effetti fissi di ecozona, Paese e secolo. Non è la specificazione a effetti fissi di città sviluppata sopra. La variabile dipendente è il logaritmo naturale della popolazione urbana. Ogni cella riporta un coefficiente seguito, tra parentesi quadre, dal relativo p-value calcolato con cluster a livello di città. Un p-value visualizzato come 0.00 è un valore piccolo arrotondato, non una probabilità di cui si sappia che è esattamente zero. “Non inclusa” identifica una variabile non stimata in quella specificazione, anziché un risultato mancante.
| Caratteristica | Tutte le città | Città musulmane | Città cristiane | Medio Oriente / Nord Africa | Europa | Città musulmane: Medio Oriente / Nord Africa | Città cristiane: Europa |
|---|---|---|---|---|---|---|---|
| Accesso al mare | 0.25*** [0.00] | 0.24 [0.11] | 0.25*** [0.00] | 0.42*** [0.01] | 0.26*** [0.00] | 0.38** [0.04] | 0.25*** [0.00] |
| Accesso a un fiume | 0.09** [0.04] | 0.12 [0.23] | 0.05 [0.31] | 0.21* [0.07] | 0.06 [0.25] | 0.11 [0.42] | 0.05 [0.3] |
| Strada romana | 0.03 [0.59] | −0.09 [0.55] | 0.06 [0.22] | 0.08 [0.71] | 0.03 [0.61] | 0.05 [0.84] | 0.05 [0.28] |
| Nodo di strade romane | 0.09* [0.10] | 0.08 [0.54] | 0.10** [0.04] | 0.12 [0.55] | 0.08 [0.13] | 0.12 [0.57] | 0.10** [0.05] |
| Via carovaniera | 0.08 [0.46] | 0.31* [0.05] | −0.34*** [0.00] | 0.06 [0.66] | Non inclusa | 0.25 [0.15] | Non inclusa |
| Nodo carovaniero | 0.5*** [0.00] | 0.78*** [0.00] | 0.09 [0.61] | 0.55*** [0.00] | Non inclusa | 0.70*** [0.00] | Non inclusa |
| Sede vescovile | 0.18*** [0.00] | 0.22** [0.04] | 0.19*** [0.00] | 0.37*** [0.00] | 0.17*** [0.00] | 0.27* [0.06] | 0.19*** [0.00] |
| Sede arcivescovile | 0.34*** [0.00] | 0.12 [0.45] | 0.41*** [0.00] | 0.35 [0.16] | 0.39*** [0.00] | 0.22 [0.36] | 0.41*** [0.00] |
| Città santa cristiana | 0.26 [0.26] | Non inclusa | 0.47 [0.12] | 0.29 [0.57] | 0.22 [0.54] | Non inclusa | 0.34 [0.34] |
| Città santa musulmana | 0.19 [0.24] | −0.08 [0.79] | Non inclusa | 0.02 [0.93] | Non inclusa | −0.18 [0.62] | Non inclusa |
| Capitale | 0.87*** [0.00] | 0.67*** [0.00] | 0.93*** [0.00] | 0.73*** [0.00] | 0.91*** [0.00] | 0.72*** [0.00] | 0.95*** [0.00] |
| Centro di istruzione superiore | 0.32*** [0.00] | 0.09 [0.83] | 0.30*** [0.00] | 0.11 [0.75] | 0.29*** [0.00] | 0.16 [0.74] | 0.30*** [0.00] |
| Madrasa | 0.25** [0.01] | 0.12 [0.25] | Non inclusa | 0.19 [0.11] | 0.12 [0.48] | 0.16 [0.19] | Non inclusa |
| Saccheggiata | 0.03 [0.56] | 0.02 [0.57] | −0.09 [0.14] | 0.07 [0.103] | −0.16*** [0.01] | 0.03 [0.41] | −0.14** [0.03] |
| Log del potenziale urbano musulmano | 0.08 [0.31] | 0.30** [0.04] | 0.03 [0.72] | 0.24 [0.12] | 0.19** [0.04] | 0.29* [0.10] | 0.07 [0.47] |
| Log del potenziale urbano cristiano | 0.23*** [0.00] | 0.29 [0.12] | 0.25*** [0.00] | −0.02 [0.9] | 0.21*** [0.00] | 0.18 [0.43] | 0.25*** [0.00] |
| R² | 0.46 | 0.52 | 0.43 | 0.60 | 0.40 | 0.56 | 0.41 |
| Osservazioni | 2,596 | 656 | 1,940 | 570 | 2,026 | 499 | 1,869 |
Variabile dipendente: logaritmo naturale della popolazione urbana. Le parentesi quadre contengono p-value basati su errori standard corretti per cluster a livello di città. Gli indicatori di significatività sono riprodotti con la precisione riportata: * 10%, ** 5%, *** 1%. Tutte le specificazioni ammettono effetti casuali di città e includono effetti fissi di ecozona, Paese e secolo. I controlli aggiuntivi riguardano la religione, dove applicabile, le pertinenti distanze logaritmiche da La Mecca, Bisanzio e Roma, il logaritmo dell'altitudine, il logaritmo dell'asperità del territorio circostante e il potenziale di coltivazione. L'indicatore di centro di istruzione superiore e quello di madrasa distinguono le due categorie istituzionali utilizzate nello studio.
I modelli di trasporto differiscono tra sottocampioni: l'accesso al mare presenta un'associazione positiva nella maggior parte delle specificazioni, mentre le reti carovaniere mostrano associazioni particolarmente forti nei campioni di città musulmane. Le misure di potenziale urbano distinguono l'accesso alle reti di città musulmane e cristiane; i loro coefficienti logaritmici sono elasticità condizionate al modello. Lo status di capitale è positivamente associato alla popolazione in tutta la tabella. Anche lo status amministrativo religioso e i centri di istruzione mostrano associazioni positive in diversi campioni. Questi risultati descrivono relazioni condizionate, non una prova automatica di effetti causali delle istituzioni. Una città in crescita può acquisire un'istituzione politica o educativa proprio perché è già in espansione.
L'interpretazione dipende dalla forma funzionale. Un coefficiente dello status di capitale pari a 0.87 corrisponde a un rapporto stimato tra popolazioni di , ossia a circa il 139% in più nella specificazione logaritmica esponenziata, anziché esattamente all'87%. Per una variabile di potenziale urbano in logaritmi, un coefficiente di 0.23 significa invece che una variazione dell'1% del potenziale urbano è associata approssimativamente a una variazione dello 0.23% della popolazione. L'esponenziazione descrive rapporti stimati sulla scala logaritmica; tradurli in medie aritmetiche condizionate della popolazione può richiedere anche un aggiustamento di ritrasformazione quando la distribuzione del disturbo cambia tra le osservazioni.
Interpretare correttamente gli indicatori temporali
Omettendo l'anno 800, il coefficiente di un secolo confronta un periodo con quel periodo di riferimento, condizionatamente agli altri regressori. La tabella seguente è un esempio di interpretazione dei coefficienti. Il campione dichiarato contiene 8,723 osservazioni, quindi non va confuso con la specificazione di base precedente, che ne contiene 2,596. Sono elencati soltanto i secoli riportati; non sono fornite stime per le voci omesse nell'esempio.
| Secolo | Coefficiente logaritmico | Statistica t |
|---|---|---|
| 800 | Periodo di riferimento | Non stimato |
| 900 | 0.299 | 1.89 |
| 1000 | 0.845*** | 5.35 |
| 1100 | 0.963*** | 6.10 |
| 1200 | 1.553*** | 9.83 |
| 1300 | 3.006*** | 19.03 |
| 1400 | 2.224*** | 14.08 |
| 1700 | 4.955*** | 31.37 |
| 1800 | 8.036*** | 50.87 |
L'anno 800 è la categoria omessa. L'esempio non riporta coefficienti per il 1500 o il 1600. Tre asterischi indicano significatività al livello dell'1%.
In un modello con risultato in logaritmi, è un'approssimazione della differenza percentuale valida per coefficienti piccoli. Il confronto esatto ottenuto mediante esponenziazione è . Pertanto 0.299 implica circa il 34.9%, mentre 0.845 implica circa il 132.8%. Per 8.036, l'approssimazione è del tutto inappropriata: il corrispondente rapporto stimato è circa 3,090.2, non una differenza di popolazione dell'803.6%. Il valore eccezionalmente elevato mostra perché occorre verificare la scala e la provenienza di un risultato prima di attribuirgli un'interpretazione storica sostanziale.
Effetti mutevoli della geografia e delle istituzioni
Sebbene l'effetto principale di una caratteristica invariante nel tempo sia assorbito dagli effetti di unità, la sua interazione con il tempo può essere identificata. Supponiamo che registri l'accesso costiero. In un modello con effetti fissi di città e temporali, si include in interazione con ciascun indicatore di periodo, tranne quello dell'anno di riferimento. Un coefficiente misura quindi come la differenza tra città costiere e dell'entroterra sia cambiata rispetto a quell'anno di riferimento, anziché la differenza complessiva in quell'anno.
| Secolo | Coefficiente dell'interazione |
|---|---|
| 800 | Periodo di riferimento |
| 900 | 0.14 |
| 1000 | 0.09 |
| 1100 | 0.02 |
| 1200 | −0.03 |
| 1300 | 0.12 |
| 1400 | 0.02 |
| 1500 | 0.11 |
| 1600 | 0.27 |
| 1700 | 0.38** |
| 1800 | 0.45** |
Sono inclusi effetti fissi di città e di periodo. Due asterischi indicano significatività al livello del 5%. In questo esempio non sono forniti errori standard né statistiche t.
Il coefficiente 0.45 per il 1800 rappresenta un incremento di 0.45 punti logaritmici nel divario tra città costiere e dell'entroterra rispetto all'800. L'esponenziazione fornisce un rapporto di rapporti pari a , ossia un aumento di circa il 56.8% di quel rapporto relativo. Non si tratta automaticamente di una differenza di 45 punti percentuali nei normali tassi di crescita della popolazione. Un'affermazione di questo tipo in punti percentuali richiederebbe ulteriori informazioni sulla situazione di partenza e sui tassi di crescita confrontati.
Una caratteristica che varia nel tempo può essere posta in interazione con tutti gli indicatori di periodo quando si omette il suo effetto principale complessivo separato e la matrice dei regressori ha rango sufficiente. Per lo status di capitale, questa parametrizzazione stima direttamente un coefficiente specifico per periodo. Se invece si include un coefficiente complessivo dello status di capitale insieme alle interazioni per tutti i periodi tranne quello di riferimento, le interazioni diventano scostamenti da quel coefficiente di riferimento. Si tratta di parametrizzazioni alternative delle stesse relazioni stimate, non di teorie economiche in concorrenza.
| Secolo | Coefficiente dello status di capitale |
|---|---|
| 800 | 0.19 |
| 900 | 0.50 |
| 1000 | 0.41 |
| 1100 | 0.40*** |
| 1200 | 0.48*** |
| 1300 | 0.47*** |
| 1400 | 0.45*** |
| 1500 | 0.61*** |
| 1600 | 0.63** |
| 1700 | 0.82** |
| 1800 | 0.64* |
Sono inclusi effetti fissi di città e di periodo. Significatività: * 10%, ** 5%, *** 1%. In questo esempio non sono forniti errori standard né statistiche t.
Per esempio, un coefficiente dello status di capitale specifico per periodo pari a 0.64 corrisponde a una differenza condizionata esponenziata di circa l'89.6%. Che ciò meriti un'interpretazione causale dipende ancora dal motivo per cui lo status di capitale è cambiato e dal controllo dei pertinenti fattori confondenti che variano nel tempo. Le interazioni ampliano la flessibilità del modello, ma non creano variazione esogena.
Valutare un risultato ottenuto con dati panel
Una valutazione utile inizia identificando l'unità, il periodo e il campione effettivamente utilizzato nella stima. Si chiede poi quali variabili cambino all'interno delle unità, quali effetti siano assorbiti e quale variazione residua identifichi il coefficiente. La spiegazione economica deve chiarire perché tale variazione non sia collegata al disturbo idiosincratico. Infine, il calcolo dell'incertezza deve rispettare la dipendenza generata dalle osservazioni ripetute e dagli shock condivisi. I dati panel aiutano a eliminare una specifica classe di variabili omesse, ossia le caratteristiche additive stabili delle unità, ma un disegno causale credibile deve affrontare anche i fattori confondenti che rimangono.
8. Difference-in-differences
Il metodo difference-in-differences, solitamente abbreviato in DiD, stima un effetto confrontando la variazione di un risultato in un gruppo trattato con la sua variazione in un gruppo di confronto. Utilizza due dimensioni di variazione: le differenze tra gruppi e le differenze nel tempo. La sua domanda centrale è se l'evoluzione del gruppo di confronto possa rivelare che cosa sarebbe accaduto al gruppo trattato in assenza di trattamento. Il metodo è particolarmente utile quando una politica cambia in un luogo o per un gruppo, mentre un gruppo di confronto credibile rimane non trattato.
Perché occorre una doppia differenza
Un confronto prima-dopo all'interno di un gruppo trattato combina l'effetto del trattamento con tutto ciò che è cambiato nel tempo. Un aumento delle rese agricole successivo a una riforma può riflettere in parte condizioni meteorologiche migliori o nuove varietà di sementi. Il confronto tra trattati e controlli dopo la riforma presenta un problema diverso: i gruppi potevano essere diversi già prima di qualsiasi riforma. Il DiD sottrae la variazione del gruppo di confronto da quella del gruppo trattato, eliminando sia un cambiamento temporale comune sia una differenza stabile preesistente tra i gruppi.
Indichiamo con il gruppo trattato, con il gruppo di confronto e con e i periodi precedenti e successivi al trattamento. Lo stimatore campionario è
Equivalentemente, è la differenza tra i gruppi dopo il trattamento meno la loro differenza prima del trattamento. Questo calcolo è sempre possibile quando esistono le quattro medie. Che il risultato rappresenti un effetto causale dipende dalle ipotesi sul controfattuale non osservato. Un comando di regressione non può fornire tali ipotesi.
Un calcolo completo: riforma delle affittanze agricole e rese del riso
L'Operazione Barga, introdotta nel Bengala Occidentale nel 1978, mirava a regolamentare i canoni delle affittanze agricole e a rafforzare la sicurezza dei mezzadri. Una maggiore sicurezza e una quota maggiore di prodotto trattenuto potevano modificare gli incentivi all'impegno, all'investimento e alla contrattazione. Un noto esempio associato al lavoro di Banerjee, Gertler e Ghatak confronta le rese del riso nel Bengala Occidentale con quelle del vicino Bangladesh, che non fu interessato dalla stessa riforma. Il risultato è misurato in chilogrammi per ettaro, quindi le differenze mantengono questa unità di misura.
| Gruppo | Prima della riforma | Dopo la riforma | Variazione |
|---|---|---|---|
| Bengala Occidentale | 1,308 | 1,650 | 342 |
| Bangladesh | 1,297 | 1,562 | 265 |
| Bengala Occidentale meno Bangladesh | 11 | 88 | 77 |
L'aumento del gruppo trattato è kg/ha. L'aumento del gruppo di confronto è kg/ha. La loro differenza è quindi kg/ha. Lo stesso risultato si ottiene da . Utilizzare soltanto l'aumento del gruppo trattato attribuirebbe alla riforma tutti i 342 kg/ha. Utilizzare soltanto la differenza finale tra i gruppi produrrebbe 88 kg/ha e ignorerebbe il divario iniziale.
La resa controfattuale del Bengala Occidentale dopo la riforma è la sua resa iniziale più l'aumento del gruppo di confronto:
L'effetto stimato è la distanza verticale tra la resa effettiva, 1,650, e la resa controfattuale, 1,573: precisamente 77 kg/ha. La resa finale effettiva del gruppo di controllo è 1,562, che non rappresenta il controfattuale del gruppo trattato perché i loro livelli iniziali erano diversi. Rispetto al controfattuale stimato, 77 kg/ha corrispondono a circa il 4.9%; rispetto alla resa iniziale del gruppo trattato, a circa il 5.9%. Queste percentuali rispondono a domande diverse e devono essere indicate di conseguenza. Quattro medie sono sufficienti per calcolare una stima puntuale, ma non forniscono un errore standard né dimostrano che valgano le ipotesi identificanti.
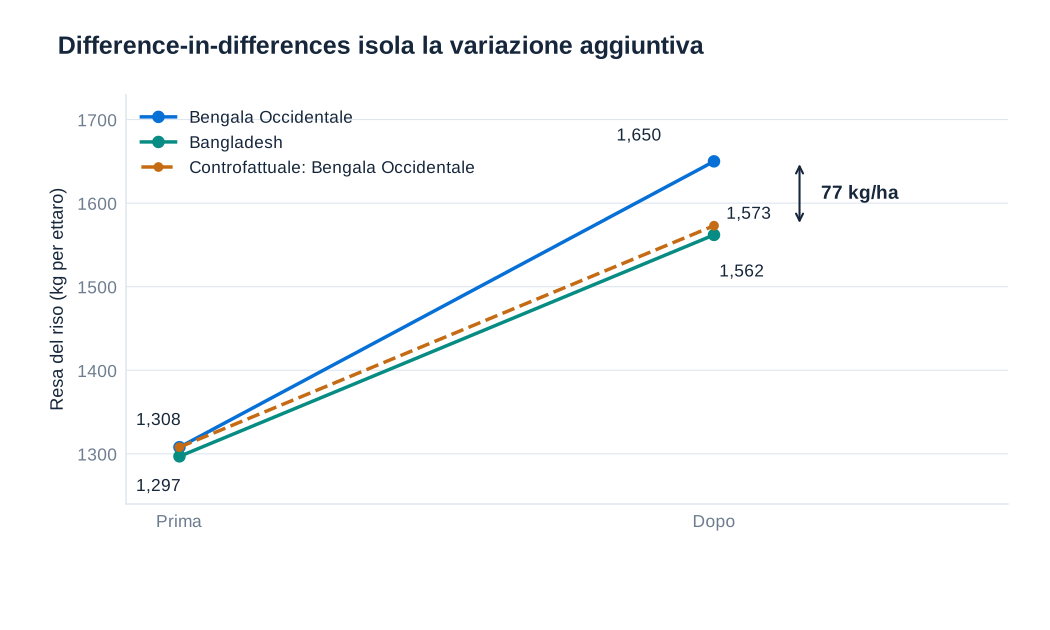
I trend paralleli sono un'ipotesi controfattuale
Indichiamo con il risultato che l'unità avrebbe senza trattamento e con il risultato in presenza di trattamento. Sia l'indicatore di appartenenza al gruppo trattato. L'ipotesi di trend paralleli richiede variazioni medie uguali nei risultati potenziali in assenza di trattamento:
Questo non richiede livelli iniziali uguali del risultato. Non richiede neppure che i risultati osservati rimangano paralleli dopo il trattamento; è proprio un effetto del trattamento a poter far divergere le traiettorie osservate. L'ipotesi riguarda la traiettoria che il gruppo trattato avrebbe seguito senza trattamento. Tale traiettoria non è osservata dopo l'inizio del trattamento, ed è per questo che l'ipotesi di trend paralleli non può essere verificata direttamente usando i dati successivi al trattamento.
In assenza di anticipazione e con un gruppo di confronto non trattato, il DiD osservato è uguale all'effetto medio del trattamento sui trattati più la differenza tra i trend che i gruppi avrebbero seguito senza trattamento. L'ipotesi di trend paralleli pone quest'ultimo termine uguale a zero. Si identifica così un effetto per la popolazione trattata, non necessariamente l'effetto che si avrebbe se ogni altro gruppo adottasse la stessa politica. Una geografia simile o medie iniziali simili possono contribuire a giustificare un confronto, ma nessuna delle due proprietà garantisce variazioni controfattuali simili.
Anticipazione, effetti di propagazione e composizione
Assenza di anticipazione significa che il comportamento precedente alla data di trattamento stabilita non ha già reagito alla politica imminente. Se una riforma viene annunciata in anticipo e gli agricoltori iniziano subito a investire, trattare il periodo tra annuncio e attuazione come una situazione iniziale non influenzata può distorcere la stima. La data di trattamento pertinente dovrebbe riflettere il momento in cui il comportamento può cambiare.
Assenza di interferenza tra i gruppi confrontati richiede un'attenta riflessione sugli effetti di propagazione. Una regione vicina può essere un controllo interessante perché affronta condizioni simili, eppure il commercio, la migrazione o la concorrenza tra politiche possono trasmettere il trattamento anche a quella regione. Se reagisce anche il risultato del gruppo di confronto, il contrasto stimato generalmente non rappresenta l'effetto sul gruppo trattato rispetto a un mondo completamente privo di trattamento.
Anche la composizione dei gruppi deve rimanere adatta al confronto. Nelle sezioni trasversali ripetute possono essere osservate persone diverse prima e dopo, e la migrazione indotta dal trattamento o la mancata risposta a un'indagine possono cambiare la popolazione rappresentata dalla media di un gruppo. Un panel riduce alcuni problemi di composizione, ma può comunque risentire di uscite selettive dal campione. Le covariate che variano nel tempo possono migliorare un confronto condizionato quando rappresentano fattori confondenti appropriati; controllare una variabile causata dal trattamento può invece eliminare parte dell'effetto che si intende stimare o introdurre distorsione.
La regressione con due gruppi e due periodi
Il DiD elementare può essere stimato mediante una regressione con interazione:
Qui dopo il trattamento e zero prima. L'intercetta è la media del gruppo di confronto prima del trattamento. Il coefficiente è la differenza iniziale del gruppo trattato rispetto a tale media. Il coefficiente è la variazione nel tempo del gruppo di confronto. L'interazione coglie la variazione aggiuntiva del gruppo trattato. Queste affermazioni si ricavano ponendo i due indicatori uguali a zero o a uno in ciascuna delle quattro celle.
| Grandezza | Espressione nella regressione | Valore (kg/ha) |
|---|---|---|
| Gruppo di confronto, prima | 1,297 | |
| Gruppo trattato, prima | 1,308 | |
| Gruppo di confronto, dopo | 1,562 | |
| Gruppo trattato, dopo | 1,650 | |
| Differenza iniziale tra gruppi | 11 | |
| Variazione del gruppo di confronto | 265 | |
| Variazione aggiuntiva del gruppo trattato | 77 |
La regressione satura riproduce le quattro medie campionarie delle celle e la stessa stima puntuale DiD. Se si introducono pesi o regressori aggiuntivi, la stima risultante riflette tali scelte e non deve necessariamente coincidere con il semplice contrasto non ponderato tra le quattro medie. Un coefficiente in chilogrammi per ettaro rimane un effetto assoluto sulla resa; un modello con risultato in logaritmi richiederebbe invece un'interpretazione sulla scala logaritmica e una trasformazione esplicitamente giustificata.
Molte unità, molti periodi e intensità del trattamento
Con molte unità e molti periodi, gli effetti fissi offrono una rappresentazione utile in forma di regressione:
Gli effetti di unità sostituiscono un'unica differenza media di livello tra trattati e controlli con un'intercetta per ciascuna unità. Gli effetti di periodo sostituiscono un singolo indicatore successivo al trattamento con un'intercetta per ciascuna data. La variabile di trattamento registra l'esposizione effettiva di quell'unità in quel periodo. Questa flessibilità è utile, ma non significa che ogni coefficiente a effetti fissi a due vie stimi automaticamente un effetto causale medio ben definito.
Le politiche sull'età minima legale per l'acquisto di alcol illustrano perché il trattamento non debba essere necessariamente binario o iniziare in una data comune. Dopo la fine del proibizionismo negli Stati Uniti, gli Stati stabilirono regole diverse sull'età; diversi di essi abbassarono le soglie nei primi anni 1970. Nel confronto storico, l'Alabama abbassò la soglia a 19 anni nel 1975, l'Arkansas la mantenne a 21 e il Tennessee la abbassò a 18 nel 1971, prima di rialzarla a 19 nel 1979. Successivamente, la politica federale favorì un'età minima di 21 anni, adottata in tutti gli Stati entro il 1988. Questi cambiamenti creano variazione nella quota di giovani adulti legalmente autorizzati ad acquistare alcol.
Definiamo come la proporzione di persone di età pari a 18–20 anni nello Stato e nell'anno legalmente autorizzate all'acquisto. Un modello per il loro tasso di mortalità può essere scritto come
Quando è codificata tra zero e uno e rappresenta i decessi per 100,000 persone, descrive la differenza stimata associata al passaggio da nessun individuo autorizzato a tutti gli individui autorizzati nella fascia d'età. Un aumento di 10 punti percentuali della quota autorizzata corrisponde a . Il modello impone una relazione lineare nell'intensità del trattamento; per interpretare causalmente le differenze tra dosi sono necessarie ipotesi più forti. Gli effetti di Stato assorbono le differenze fisse tra Stati e gli effetti di anno assorbono gli shock annuali comuni, mentre cambiamenti simultanei delle politiche o trend differenziati di mortalità possono ancora confondere la stima.
Evidenza precedente al trattamento ed event study
Diversi periodi precedenti al trattamento rendono un disegno di ricerca più informativo perché rivelano se i gruppi si stavano già muovendo in modo diverso. Per una data di trattamento comune , una specificazione event study sostituisce un unico coefficiente successivo al trattamento con interazioni tra l'appartenenza al gruppo trattato e le date relative al trattamento:
Il periodo immediatamente precedente al trattamento, , viene omesso come riferimento. I coefficienti precedenti al trattamento misurano quanto il divario tra gruppo trattato e gruppo di confronto nelle date anteriori differisca da quel divario di riferimento. I coefficienti successivi al trattamento descrivono come il divario evolva dopo l'esposizione. Rappresentare graficamente le stime puntuali con intervalli di incertezza appropriati consente di valutare tempi, precisione e persistenza più facilmente che con un unico coefficiente medio.
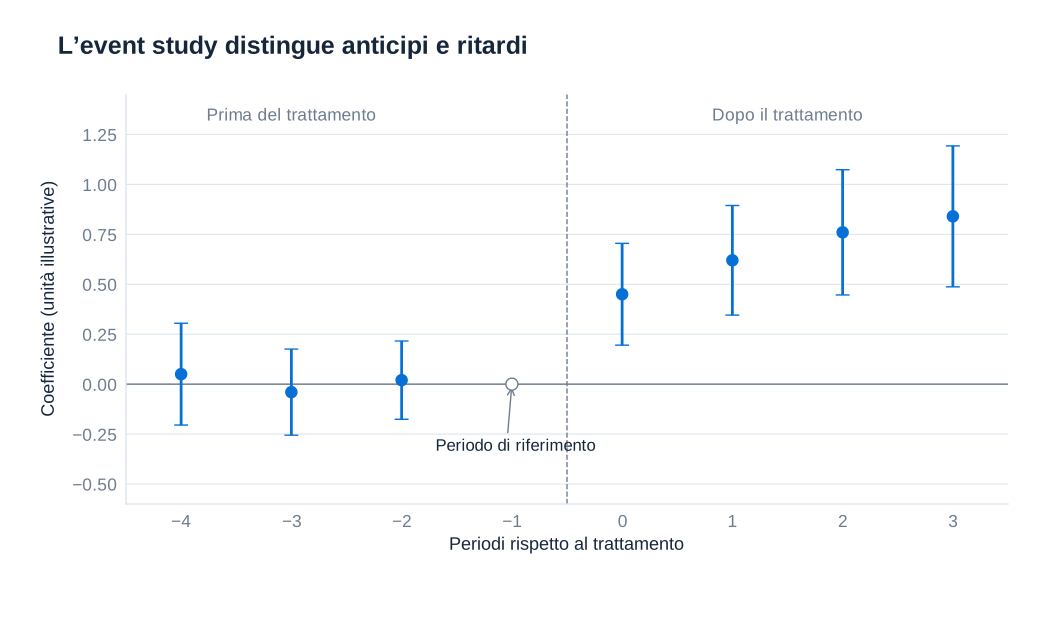
Stime precedenti al trattamento vicine a zero sono compatibili con trend paralleli, ma non dimostrano l'ipotesi. Un test può avere bassa potenza, gli intervalli di confidenza possono ammettere differenze economicamente rilevanti e un nuovo shock successivo al trattamento può influenzare i gruppi in modo diverso nonostante storie simili. Viceversa, differenze significative prima del trattamento possono rivelare anticipazione, un gruppo di confronto inadeguato o una specificazione errata. Sono informativi sia le singole stime sia un test congiunto dei coefficienti precedenti al trattamento, insieme a una conoscenza sostanziale del contesto. La credibilità riguarda i trend controfattuali successivi al trattamento, quindi un test non significativo sui trend precedenti non deve mai essere presentato come una validazione conclusiva.
Trend differenziati e relativi limiti
Un DiD convenzionale non funziona quando le unità trattate e quelle di confronto avrebbero continuato a seguire trend diversi in assenza di trattamento. Una specificazione per l'analisi di sensibilità aggiunge trend temporali lineari specifici per unità:
Il coefficiente consente a ciascuna unità di avere uno scostamento lineare stabile dalla traiettoria temporale comune. Il coefficiente del trattamento riflette quindi gli scostamenti da tali traiettorie stimate. Questo sostituisce la semplice ipotesi di trend paralleli con un'affermazione più forte sulla forma funzionale che descrive come sarebbero evolute le differenze in assenza di trattamento. Non è una correzione generale per qualsiasi divergenza arbitraria.
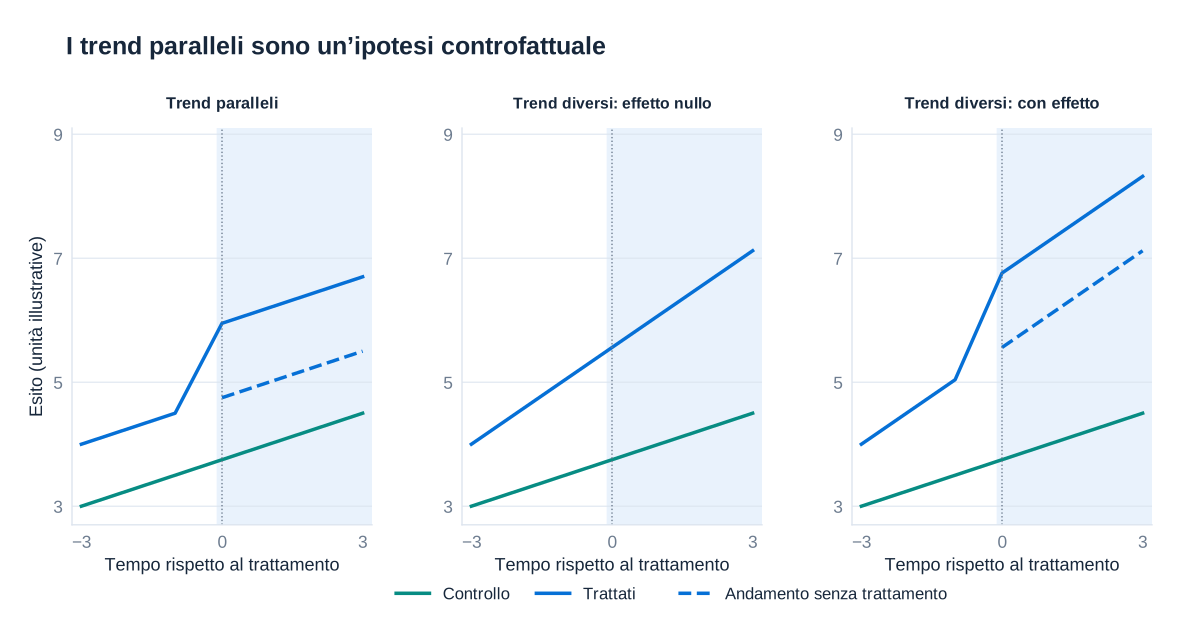
Tre casi chiariscono la distinzione. Con traiettorie parallele in assenza di trattamento e un salto discreto indotto dal trattamento, un DiD standard può recuperare il salto. Con traiettorie non parallele in assenza di trattamento e nessun effetto del trattamento, il divario variabile tra i gruppi può produrre un DiD spurio. Con traiettorie non parallele e un salto effettivo, un modello con trend differenziati correttamente specificato può separare la discontinuità da una divergenza preesistente regolare. Tuttavia, se gli effetti del trattamento emergono gradualmente, stimare trend specifici per unità utilizzando tutti i periodi può assorbire parte dell'effetto. Le conclusioni dovrebbero quindi considerare l'interazione tra le stime dei trend, la dinamica del trattamento e la finestra precedente al trattamento scelta.
Adozione scaglionata ed effetti eterogenei
Quando le unità adottano il trattamento in date diverse e gli effetti variano tra coorti o durate di esposizione, una regressione convenzionale a effetti fissi a due vie può utilizzare unità già trattate come controlli per unità appena trattate. Il coefficiente risultante può combinare confronti con pesi difficili da interpretare o persino negativi e non deve necessariamente coincidere con l'effetto medio del trattamento sui trattati che si intende stimare. L'interpretazione chiara del DiD elementare non dovrebbe essere trasferita automaticamente.
Gli approcci moderni stimano effetti per coorti e date di trattamento utilizzando unità di confronto appropriate, mai trattate o non ancora trattate, e poi aggregano tali effetti in modo trasparente. Il ricercatore deve definire la popolazione di interesse e lo schema di ponderazione, giustificare i trend paralleli e l'assenza di anticipazione per i confronti selezionati e individuare quali orizzonti successivi al trattamento dispongano di controlli credibili. Le politiche reversibili e il trattamento continuo richiedono ulteriore cautela, perché i metodi concepiti per un'unica data di adozione definitiva non si applicano automaticamente.
Incertezza e quantità effettiva di informazione
I risultati e l'esposizione alle politiche spesso persistono nel tempo. Trattare ogni osservazione persona-anno o Stato-anno come indipendente può rendere gli errori standard troppo piccoli. In un disegno basato su politiche statali, costruire cluster a livello di Stato consente ai disturbi di essere correlati tra anni e tra osservazioni che condividono lo stesso Stato. Se shock importanti attraversano i confini statali, i soli cluster di Stato possono non cogliere l'intera struttura di dipendenza. Il livello appropriato segue il disegno di ricerca e la correlazione plausibile dei disturbi.
Un numero maggiore di osservazioni all'interno delle stesse poche unità di politica non crea molti esperimenti di politica indipendenti. Il punto rilevante è il numero e il bilanciamento dei cluster indipendenti, soprattutto quanti di essi ricevono il trattamento. Non esiste una soglia universale oltre la quale l'inferenza robusta per cluster diventi automaticamente affidabile. Con pochi cluster possono essere necessari metodi quali correzioni appropriate per piccoli campioni, procedure wild-cluster bootstrap o inferenza per randomizzazione basata sul disegno, esplicitandone le ipotesi. Le quattro medie aggregate delle rese del riso, per esempio, non possono da sole giustificare un errore standard convenzionale. Uno studio DiD completo combina calcoli trasparenti, un controfattuale difendibile e un calcolo dell'incertezza coerente con l'effettiva struttura di assegnazione.
9. Status giuridico e rappresentanza politica
Le politiche pubbliche possono modificare la partecipazione politica senza cambiare immediatamente chi ha legalmente diritto di voto. La regolarizzazione degli immigrati offre un esempio particolarmente significativo: eliminare l’incertezza sul soggiorno e sull’occupazione può modificare gli investimenti delle famiglie, l’impegno civico e la capacità di una comunità già presente di sostenere candidati politici. Questo capitolo esamina lo studio di Bernini e Sabet sull’Immigration Reform and Control Act (IRCA). Collega intensità del trattamento, effetti fissi, event study, variabili strumentali e analisi dei meccanismi all’interno di un’unica indagine empirica. L’esito denominato mobilità politica è l’avanzamento tra cariche elettive; non indica la migrazione geografica o il passaggio da un posto di lavoro a un altro.
La regolarizzazione prima dell’acquisizione diffusa del diritto di voto
L’IRCA fu approvato nel 1986 e consentì a quasi tre milioni di immigrati privi di regolare autorizzazione al soggiorno di ottenere uno status giuridico regolare. Circa l’86 percento dei richiedenti era ispanico. La residenza permanente iniziò a essere concessa nel 1989, mentre il normale periodo di attesa di cinque anni prima della naturalizzazione separava la regolarizzazione dall’acquisizione della cittadinanza e del diritto di voto. L’analisi politica principale si concentra quindi sul periodo 1984–1994. Questa scansione temporale permette di distinguere utilmente le conseguenze di uno status giuridico più sicuro da quelle dell’aggiunta diretta di elettori appena naturalizzati al corpo elettorale.
Le persone prive di uno status giuridico regolare erano già residenti ed erano incluse nelle statistiche demografiche. La regolarizzazione modificò quindi la composizione giuridica della popolazione esistente, anziché aggiungere meccanicamente lo stesso numero di nuovi residenti. Si tratta di un argomento istituzionale, non di una garanzia dell’assenza di migrazioni o di altre risposte demografiche. Tali risposte devono essere esaminate empiricamente. La scansione temporale non implica neppure che ogni cambiamento politico precedente al 1995 fosse completamente estraneo alla naturalizzazione: l’affermazione sostenibile riguarda il periodo anteriore alla naturalizzazione diffusa dei beneficiari dell’IRCA.
Il meccanismo politico va oltre il voto espresso dai beneficiari. La protezione dal rischio di espulsione e l’accesso permanente all’occupazione possono incoraggiare gli investimenti nell’istruzione, rendere le famiglie più propense a rivolgersi alle istituzioni pubbliche e rafforzare le organizzazioni che assistono nuclei familiari i cui componenti hanno status giuridici diversi. Possono reagire i familiari e gli altri membri della comunità che già possiedono il diritto di voto. Un aumento dei titolari ispanici di cariche pubbliche è quindi compatibile con il fatto che, durante il principale periodo di osservazione, la maggior parte dei residenti appena regolarizzati rimanga priva del diritto di voto.
Misurare l’esposizione e scegliere l’unità di analisi in funzione della domanda
Il trattamento è una misura continua a livello di contea. I ricercatori rapportano i richiedenti IRCA alla popolazione della contea nel 1980, moltiplicano per 1,000 e standardizzano la variabile risultante. Una variazione unitaria della misura standardizzata corrisponde a una deviazione standard dell’esposizione tra contee. Non indica un richiedente aggiuntivo, un punto percentuale della popolazione o il fatto che ogni residente riceva il trattamento.
Indicando l’esposizione non standardizzata con e la sua forma standardizzata con , le unità di misura diventano esplicite:
I dati amministrativi contengono 3,039,239 richiedenti, di cui 2,744,173 hanno un identificativo della contea. I restanti 295,066 conservano l’identificativo dello Stato, ma le informazioni sulla contea sono oscurate. Distribuire queste osservazioni tra le contee introduce un problema di misurazione, non soltanto un inconveniente nella pulizia dei dati: regole di allocazione diverse possono modificare la misura dell’intensità. Lo studio ripete quindi l’analisi utilizzando procedure di imputazione, denominatori e previsioni alternativi.
La rappresentanza politica è ricavata da un nuovo database longitudinale di titolari ispanici di cariche elettive. Per la rappresentanza aggregata, l’unità è una categoria di cariche all’interno di una contea e di un anno. Per la progressione di carriera, è il singolo titolare di una carica in un determinato anno. Le iscrizioni scolastiche, l’occupazione degli insegnanti, la partecipazione politica e gli esiti di finanza pubblica provengono da ulteriori fonti amministrative e indagini campionarie. Questi dataset rispondono a domande diverse e non devono necessariamente contenere le stesse osservazioni. Un numero maggiore di record individuali non genera un numero altrettanto elevato di assegnazioni indipendenti del trattamento, perché l’esposizione varia a livello di contea.
Un disegno difference-in-differences con trattamento continuo
La specificazione di base confronta le variazioni degli esiti tra luoghi con diversa esposizione all’IRCA, prima e dopo l’inizio della concessione della residenza permanente:
Qui indica l’unità di osservazione, la sua contea e il suo Stato. L’effetto fisso dell’unità assorbe le differenze stabili tra contee, scuole o politici, a seconda dell’esito. Gli effetti Stato-per-anno assorbono gli shock condivisi all’interno di uno Stato in un determinato anno. Le caratteristiche iniziali delle contee , interagite con l’indicatore successivo al trattamento, consentono alla variazione nel periodo successivo di differire in funzione delle condizioni demografiche ed economiche preesistenti. Gli errori standard sono raggruppati in cluster per contea perché sia l’esposizione sia i plausibili shock non osservati sono condivisi all’interno delle contee.
La condizione identificante è un’ipotesi condizionata di trend paralleli: in assenza della regolarizzazione, le variazioni degli esiti non sarebbero cambiate sistematicamente con l’intensità iniziale dell’IRCA, una volta tenuto conto dei controlli e degli effetti fissi inclusi. Il confronto avviene tra luoghi più e meno esposti, non tra beneficiari e non beneficiari assegnati casualmente. Il coefficiente descrive la variazione differenziale dell’esito associata a una deviazione standard dell’esposizione della contea secondo questo modello. Interpretarlo come l’effetto individuale della concessione di uno status giuridico regolare a una persona cambierebbe sia il parametro oggetto di stima sia l’unità del trattamento.
Un event study sostituisce la singola interazione con il periodo successivo con interazioni dell’esposizione specifiche per ciascun anno e omette il 1988 come anno di riferimento. I suoi coefficienti misurano le differenze rispetto a tale riferimento. Per gli esiti disponibili soltanto a intervalli lunghi, una regressione sulle differenze di lungo periodo mette in relazione la variazione dell’esito con l’esposizione, i controlli iniziali e gli effetti fissi di Stato. Queste alternative conservano il confronto centrale, adattandolo alla frequenza delle osservazioni.
Che cosa misurano effettivamente le stime della rappresentanza
L’esito relativo alla rappresentanza divide il numero di titolari ispanici di cariche pubbliche per il numero totale di seggi nella stessa categoria di cariche e nella stessa contea, misurato nel 1987. Mantenere fisso questo denominatore aiuta a separare i cambiamenti nella rappresentanza ispanica dalle variazioni del numero di cariche disponibili. I risultati seguenti utilizzano coerentemente il lavoro di ricerca del luglio 2026. Gli effetti e gli errori standard sono espressi in punti percentuali per un aumento di una deviazione standard dell’esposizione della contea; le medie iniziali sono percentuali.
| Categoria di cariche | Effetto, punti percentuali | Errore standard con cluster per contea | Media precedente al 1989, percento |
|---|---|---|---|
| Tutte le cariche elettive locali | 0.488 | 0.141 | 1.226 |
| Tutti gli organi collegiali di governo locale | 0.613 | 0.211 | 1.418 |
| Consigli scolastici | 0.997 | 0.334 | 1.488 |
| Tutte le cariche cittadine | 0.737 | 0.263 | 1.350 |
| Consigli cittadini | 0.603 | 0.253 | 1.335 |
| Tutte le cariche di contea | 0.000 | 0.141 | 0.876 |
| Consigli di contea | −0.148 | 0.333 | 1.479 |
Il coefficiente relativo ai consigli scolastici è pari a circa un punto percentuale. Rispetto alla media iniziale, . Il calcolo corrispondente per i consigli cittadini è . Nessuno dei due numeri significa che la rappresentanza sia aumentata di 67 o 45 punti percentuali. Le stime a livello di contea sono troppo imprecise per accertare incrementi comparabili. Il quadro suggerisce un’espansione nelle istituzioni scolastiche e cittadine, dove le possibilità di accesso alle cariche elettive sono più numerose.
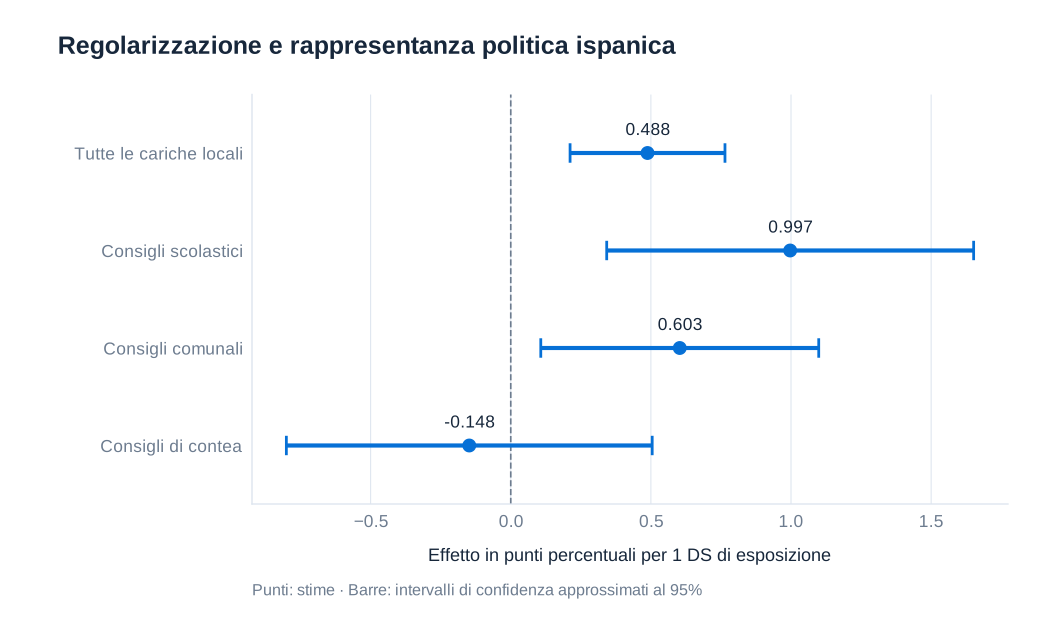
Le stime dell’event study rafforzano l’argomento temporale. I coefficienti precedenti al 1989 sono congiuntamente indistinguibili da zero, mentre la rappresentanza aumenta gradualmente dopo la regolarizzazione: circa 0.4 punti percentuali entro il 1990, 0.8 entro il 1992 e 1.3–1.4 entro il 1994 per l’esito che combina consigli scolastici e cittadini. Queste stime dinamiche riguardano un esito combinato e non devono sostituire il coefficiente separato dei consigli scolastici riportato nella tabella. Gli incrementi graduali attraverso i cicli elettorali sono coerenti con l’integrazione politica, anziché con un’immediata riclassificazione dei titolari di cariche già esistenti. Un test dei trend precedenti non può dimostrare che il controfattuale non osservato sarebbe rimasto parallelo.
Seguire lo stesso politico nel tempo
Gli incrementi aggregati potrebbero riflettere un maggior numero di nuovi titolari di cariche, l’avanzamento dei politici già presenti o entrambi. Per studiare le carriere, i ricercatori seguono i titolari ispanici di cariche pubbliche e registrano se passano da un livello di governo a un altro da un anno al successivo. La variabile dipendente vale 100 in presenza di una transizione e zero altrimenti, quindi i coefficienti della regressione esprimono direttamente variazioni in punti percentuali delle probabilità di transizione. Gli effetti fissi individuali eliminano le differenze stabili nell’ambizione o nelle capacità, ma non assorbono opportunità o shock che variano nel tempo.
| Esito | Effetto, punti percentuali | Errore standard con cluster | Probabilità iniziale, percento |
|---|---|---|---|
| Qualsiasi avanzamento, tutte le cariche | 0.280 | 0.117 | 0.804 |
| Qualsiasi arretramento, tutte le cariche | −0.011 | 0.053 | 0.687 |
| Avanzamento tra organi collegiali di governo | 0.426 | 0.096 | 0.557 |
| Dal consiglio scolastico al consiglio cittadino | 0.317 | 0.135 | 0.582 |
| Dal consiglio cittadino al consiglio di contea | 0.066 | 0.035 | 0.129 |
Per gli avanzamenti tra organi collegiali di governo, l’incremento relativo calcolato dai valori riportati è . L’aumento assoluto rimane pari a 0.426 punti percentuali: una variazione relativa elevata può derivare da una probabilità iniziale piccola. Per tutte le cariche, il calcolo analogo è circa il 34.8 percento. Utilizzare i valori mostrati nella tabella evita percentuali fuorvianti ottenute dividendo numeri fortemente arrotondati.
L’avanzamento più evidente si verifica dai consigli scolastici a quelli cittadini. La stima più piccola relativa al passaggio dalla città alla contea è meno precisa, e i dati non accertano un’espansione generale dei passaggi a cariche statali o federali. Non emerge neppure un chiaro aumento della mobilità discendente. Nel loro insieme, questi risultati sostengono un’interpretazione di progressione verso l’alto attraverso livelli istituzionali vicini, anziché di ricambio indiscriminato lungo la gerarchia politica.
L’insediamento storico come strumento
L’esposizione della contea può rimanere correlata con condizioni locali non osservate. La strategia a variabili strumentali utilizza la quota di lavoratori agricoli ispanici nel 1970, interagita con l’indicatore successivo al 1989, per prevedere l’esposizione. L’insediamento agricolo storico e le reti migratorie contribuiscono a spiegare perché alcune contee abbiano successivamente avuto più richiedenti ammissibili. La disposizione dell’IRCA relativa ai lavoratori agricoli rende questo collegamento particolarmente rilevante.
Il primo stadio prevede l’interazione endogena dell’esposizione a partire dall’interazione dell’insediamento storico e dalle stesse covariate esogene e dagli stessi effetti fissi. Il secondo stadio sostituisce l’interazione dell’esposizione con la sua componente stimata. I minimi quadrati a due stadi utilizzano soltanto la variazione dell’esposizione associata allo strumento. Nella specificazione di base relativa alla rappresentanza, la stima del secondo stadio riportata è 1.369 punti percentuali, con un errore standard con cluster di 0.336, e la statistica Wald di Kleibergen–Paap del primo stadio è 219. Per la mobilità ascendente, la stima corrispondente è 0.913, il suo errore standard è 0.222 e la statistica del primo stadio è 40. La forza dello strumento differisce quindi tra esiti e campioni.
La rilevanza non coincide con la validità. La restrizione di esclusione richiede che l’insediamento agricolo storico influenzi le successive variazioni della rappresentanza attraverso l’esposizione all’IRCA, anziché attraverso un altro canale omesso. Uno strumento misurato molti anni prima può comunque essere invalido se prevede un’organizzazione civica persistente, trasformazioni agricole o cambiamenti nelle opportunità politiche rurali. Lo studio esamina questi canali utilizzando le organizzazioni civiche ispaniche preesistenti, la composizione delle colture, le quote di popolazione rurale e la composizione per cittadinanza. La stabilità dopo l’aggiunta di questi controlli costituisce un’evidenza utile, ma non può eliminare logicamente ogni meccanismo alternativo.
Le stime più elevate ottenute con variabili strumentali sono coerenti con un’attenuazione dovuta all’errore di misurazione dell’esposizione della contea. Potrebbero anche riflettere una diversa ponderazione di risposte eterogenee o il mancato rispetto della restrizione di esclusione. Un’interpretazione attenta riconosce queste alternative, anziché trattare la differenza tra OLS e IV come prova che l’errore di misurazione sia l’unica spiegazione.
Il rafforzamento della comunità e le spiegazioni alternative
L’analisi dei meccanismi si chiede se gli esiti intermedi siano coerenti con una spiegazione unitaria. Le iscrizioni scolastiche aumentano nelle contee più esposte, soprattutto tra gli studenti ispanici e nelle età della scuola secondaria. I dati individuali suggeriscono che gli incrementi della frequenza si concentrano tra i giovani ispanici nati all’estero, mentre i miglioramenti nel completamento degli studi raggiungono anche i giovani ispanici nati nel Paese. Questa combinazione è coerente sia con risposte dirette alla sicurezza giuridica sia con effetti di propagazione all’interno delle famiglie o delle comunità.
Il corpo docente cambia composizione, anziché mostrare una chiara espansione della sua dimensione complessiva. La quota stimata di insegnanti ispanici aumenta di 0.665 punti percentuali, con un errore standard di 0.211, mentre la quota di insegnanti bianchi diminuisce di 0.753 punti. Tra le insegnanti donne, la quota ispanica aumenta di 0.935 punti. Questi risultati riguardano esiti definiti come quote del personale docente; non devono essere descritti come lo stesso numero di punti percentuali dell’occupazione complessiva della contea. La concentrazione nell’istruzione amministrata localmente è coerente con un canale istituzionale locale.
I dati elettorali, l’iscrizione nelle liste elettorali, le indagini sulla partecipazione e la copertura dei giornali forniscono evidenze complementari di un maggiore impegno politico. Per esempio, le risposte alle indagini delle persone nate negli Stati Uniti da genitori nati all’estero indicano un maggiore coinvolgimento nell’incoraggiare altri a votare e nelle attività di campagna elettorale. Questi intervistati non coincidono con i beneficiari dell’IRCA, e l’origine familiare è una proxy imperfetta dell’appartenenza a un nucleo con status giuridici diversi. Le loro risposte aiutano comunque a spiegare come la regolarizzazione potesse produrre effetti politici prima che la maggior parte dei beneficiari acquisisse personalmente il diritto di voto.
Lo studio indaga anche le reazioni contrarie. In California, l’esposizione non prevede un aumento statisticamente rilevabile del sostegno alla Proposition 187 o al governatore Pete Wilson, e analisi correlate esaminano le contee vicine e gli atteggiamenti rilevati dalle indagini. La conclusione appropriata è che questi test non rivelano una contro-mobilitazione sistematica negli esiti e nei campioni studiati. Concludere che nessun individuo abbia subito ostilità o che ogni forma di reazione avversa fosse assente andrebbe oltre l’evidenza disponibile.
Dalla rappresentanza alle politiche dei distretti scolastici
Un cambiamento nella rappresentanza descrittiva non implica necessariamente un cambiamento nelle politiche. Le finanze dei distretti scolastici consentono di verificare se le priorità di spesa cambino con l’esposizione alla regolarizzazione. Lo studio mette in relazione le variazioni tra il 1987 e il 1997 con l’esposizione della contea. La tabella seguente si concentra su quote con unità chiare e confrontabili; la spesa e le entrate totali sono analizzate separatamente attraverso variazioni logaritmiche.
| Quota di bilancio | Effetto, punti percentuali | Errore standard con cluster | Media del 1987, percento |
|---|---|---|---|
| Spesa corrente | −0.644 | 0.205 | 92.835 |
| Retribuzioni correnti | −0.514 | 0.177 | 60.064 |
| Spesa in conto capitale | 0.644 | 0.205 | 7.165 |
| Spesa per costruzioni | 0.609 | 0.212 | 4.305 |
| Entrate tributarie | −0.409 | 0.178 | 33.162 |
| Trasferimenti tra livelli di governo | 0.296 | 0.185 | 59.649 |
Il coefficiente relativo alle costruzioni corrisponde a un aumento di circa il 14.1 percento rispetto alla quota iniziale, mentre il coefficiente delle entrate tributarie rappresenta una diminuzione di circa l’1.23 percento rispetto alla quota iniziale. Le quote della spesa corrente e in conto capitale si muovono in direzioni opposte perché ripartiscono la spesa totale. Il coefficiente positivo dei trasferimenti è stimato con minore precisione rispetto alla diminuzione della quota tributaria; non dovrebbe essere presentato come un aumento altrettanto certo. I bilanci totali non mostrano alcuna variazione complessiva statisticamente rilevabile.
L’evidenza sulle proposte sottoposte al voto in California mostra un maggiore ricorso a proposte di emissione di obbligazioni garantite dalla capacità fiscale generale dell’ente e un minore ricorso a proposte di aumento delle imposte immobiliari. Le obbligazioni sono strumenti di indebitamento; non appartengono alla stessa categoria contabile dei trasferimenti tra livelli di governo. Queste osservazioni suggeriscono uno spostamento verso gli investimenti in conto capitale e il finanziamento mediante debito, mentre la tabella nazionale delle entrate documenta un cambiamento distinto nella composizione delle entrate. Il periodo di osservazione fiscale si estende oltre il principale periodo politico precedente alla naturalizzazione, rendendo inappropriata l’affermazione che gli effetti fiscali precedano esclusivamente l’acquisizione del diritto di voto. Infine, l’evidenza non deriva da un esperimento separato che assegni casualmente la presenza di membri ispanici nei consigli, quindi non può isolare la rappresentanza come unico mediatore della risposta fiscale.
Robustezza, interpretazione e fonte della ricerca
Lo studio esamina costruzioni alternative dell’esposizione, l’esclusione della California, l’applicazione della legislazione sul diritto di voto, campioni bilanciati, contee e titolari di cariche influenti, controlli alternativi, effetti non lineari dell’esposizione, il taglio delle code delle distribuzioni, anni di riferimento alternativi ed errori correlati nello spazio. Queste verifiche affrontano rischi diversi. Per esempio, escludere una contea verifica se la stima sia determinata da un singolo luogo influente; l’inferenza spaziale affronta la dipendenza tra contee vicine; le imputazioni alternative verificano se il risultato dipenda dalle localizzazioni oscurate dei richiedenti. Il superamento di uno di questi esercizi non sostituisce gli altri.
L’indagine illustra come un’argomentazione causale si costruisca combinando disegno, scansione temporale, definizioni dei dati e spiegazioni alternative. La conclusione più solida riguarda l’integrazione politica locale associata a uno specifico programma storico di regolarizzazione, condizionatamente alle ipotesi identificanti. L’estrapolazione a un diverso regime giuridico, a una protezione temporanea, a una diversa popolazione migrante o a un nuovo afflusso migratorio richiede ulteriori argomentazioni. Per il lettore che valuta un qualsiasi lavoro empirico sulle politiche pubbliche, le domande essenziali rimangono: quale variazione identifica l’effetto, quale popolazione descrive, quali sono le sue unità di misura e quali ipotesi potrebbero non essere rispettate?
Fonte della ricerca: Andrea Bernini e Navid Sabet (luglio 2026), Legal Status and Local Political Power: Evidence from the Immigration Reform and Control Act. I risultati sulla rappresentanza utilizzano la Tabella 2; la mobilità politica utilizza la Tabella 3; i risultati a variabili strumentali utilizzano la Tabella 4; gli esiti relativi agli insegnanti utilizzano la Tabella 6; i risultati di finanza pubblica utilizzano la Tabella 8. Le variazioni relative in questo capitolo sono calcolate a partire dai coefficienti e dalle medie iniziali riportati.
10. Terrorismo, atteggiamenti politici e voto
La violenza politica può modificare il voto attraverso diversi canali: persone precedentemente inattive possono partecipare, elettori già attivi possono cambiare preferenze, i partiti possono modificare i propri messaggi e la copertura mediatica può rendere alcune questioni più salienti. Distinguere queste spiegazioni richiede più che correlare il numero di attentati con un risultato elettorale. Lo studio di Sabet, Liebald e Friebel sulla Germania offre un esempio applicato di confronto quasi sperimentale condizionato, stima su dati panel, inferenza con cluster e combinazione di evidenze aggregate e individuali. L’analisi di questo capitolo utilizza i risultati pubblicati nel 2025.
La domanda, il contesto e il confronto rilevante
La domanda centrale è se gli attentati terroristici locali riusciti aumentino il sostegno all’Alternative für Deutschland (AfD), rispetto agli attentati falliti. Si tratta di un parametro oggetto di stima più circoscritto rispetto all’effetto di tutta la violenza politica confrontata con l’assenza di violenza. I comuni che subiscono attentati possono differire da quelli non colpiti per popolazione, migrazioni, condizioni economiche o storia politica. Un semplice confronto tra comuni colpiti e non colpiti rischierebbe quindi di attribuire tali differenze al terrorismo.
I ricercatori condizionano invece il confronto al fatto che sia stato tentato un attentato. Confrontano luoghi nei quali un attentato è riuscito con luoghi nei quali i tentativi sono falliti. La fonte proposta di variazione quasi casuale è l’incertezza sul fatto che un attentato tentato raggiunga il proprio obiettivo fisico immediato. Nel Global Terrorism Database, la riuscita si riferisce all’esecuzione concreta, come la detonazione di un ordigno, anziché al conseguimento finale di un obiettivo politico da parte dell’autore. Gli assassinii mirati sono esclusi perché la classificazione della loro riuscita è definita diversamente.
Anche il contesto istituzionale conta. L’AfD è entrata nel panorama elettorale tedesco nel 2013, e lo studio esamina le elezioni federali, del Parlamento europeo e dei Länder fino al 2021. Questi tipi di elezione non devono necessariamente reagire allo stesso modo. Gli elettori possono attribuire la sicurezza interna e alcuni aspetti dell’insediamento dei rifugiati a livelli diversi di governo, e i partiti possono dare a questi temi un’enfasi diversa nelle proprie campagne. Stimare effetti separati per tipo di elezione è quindi motivato sul piano sostanziale, anziché rappresentare soltanto una ricerca di un sottogruppo significativo.
Dagli attentati a un panel di comuni
Il database di partenza registra 232 attentati in Germania tra il 2010 e il 2020, associati a 124 comuni. Circa l’86 percento degli attentati è riuscito e il 14 percento è fallito. La maggior parte era di piccola scala e locale, e circa tre quarti riguardavano cause di destra e attacchi contro stranieri. Questo non significa che la quota di comuni trattati sia pari all’86 percento: gli attentati ripetuti e la classificazione a livello comunale cambiano il denominatore.
Un comune è classificato come interessato da attentati riusciti se ne subisce almeno uno. Il gruppo di confronto è costituito da luoghi con almeno un tentativo fallito e nessun attentato riuscito. Nel campione di base vi sono 124 cluster comunali, ma soltanto 11 comuni con soli attentati falliti. La data di riferimento è quella del primo attentato riuscito o fallito rilevante per il rispettivo gruppo. I comuni che subiscono più tentativi richiedono particolare attenzione perché gli eventi successivi possono sovrapporsi ai periodi successivi al trattamento degli eventi precedenti.
Gli esiti elettorali misurano la quota dell’AfD sui voti validi espressi per i partiti. Quando gli elettori esprimono voti separati per candidati e partiti, il voto al partito evita di confondere il sostegno al partito con l’attrattiva di un particolare candidato. I dati comprendono le elezioni federali del 2013, 2017 e 2021, le elezioni europee del 2014 e 2019 e le elezioni dei Länder del periodo 2013–2021. Le covariate comunali e i dati panel individuali ad accesso riservato supportano ulteriori verifiche e l’analisi dei meccanismi.
La riuscita non è un’etichetta che riassume la gravità di tutte le conseguenze. Un tentativo fallito può comunque spaventare i residenti o ricevere attenzione mediatica. Di conseguenza, anche un confronto valido tra attentati riusciti e falliti identifica inizialmente la loro differenza. Interpretarla come l’effetto complessivo del terrorismo richiede di esaminare che cosa producano i tentativi falliti rispetto ad appropriati luoghi non esposti.
Perché contano il bilanciamento e l’evidenza sui trend precedenti
L’ipotesi chiave è che, condizionatamente all’essere bersaglio di un attentato, la riuscita non sia sistematicamente collegata a fattori che modificherebbero autonomamente il voto. Lo studio verifica reddito, occupazione, popolazione, migrazioni, numero di richiedenti asilo, istruzione, geografia, assistenza sociale e caratteristiche politiche precedenti all’attentato. Confronta anche tecnologie e motivazioni degli attentati. Gli attentati riusciti producono più vittime e feriti, una conseguenza dell’esecuzione riuscita che non invalida di per sé la comparabilità precedente al trattamento.
Una regressione di bilanciamento può essere scritta come , dove indica un attentato riuscito e è una caratteristica misurata prima dell’evento. Un piccolo e stimato con scarsa precisione è rassicurante, ma il mancato rifiuto di non dimostra l’uguaglianza. I test di bilanciamento possono non rilevare differenze rilevanti quando i campioni sono piccoli e non verificano direttamente caratteristiche non osservate, come l’organizzazione degli autori, la qualità degli ordigni o l’efficacia della polizia locale.
Lo studio pubblicato esamina anche gli andamenti dell’event study utilizzando stimatori che tengono conto di trattamenti introdotti in momenti diversi e di effetti eterogenei. Per l’esito relativo all’AfD, il test congiunto dei coefficienti del periodo precedente riporta un p-value di 0.15 e il test di un trend lineare precedente ha un p-value di 0.46. Questi valori non sono probabilità che l’ipotesi di identificazione sia vera. Indicano che i test specificati non rifiutano le rispettive ipotesi nulle ai livelli convenzionali. Il trend controfattuale successivo all’attentato rimane non osservato.
Combinare livelli e trend è utile perché esiti iniziali uguali non implicano variazioni future uguali, mentre livelli diversi non invalidano necessariamente un disegno difference-in-differences. L’insegnamento più generale è esaminare la dimensione economica e l’incertezza dei possibili squilibri, non soltanto verificare se una sequenza di p-value superi 0.05.
L’equazione di stima e la sua interpretazione
Sia la quota di voti dell’AfD nel comune , per il tipo di elezione e nell’anno . Sia l’indicatore di attentato riuscito e sia l’indicatore che l’elezione si svolge dopo l’attentato di riferimento. Una rappresentazione trasparente del modello con dati raggruppati è:
Le etichette , e indicano le elezioni federali, europee e dei Länder. Gli effetti comune-per-tipo-di-elezione assorbono gli andamenti locali persistenti del voto specifici di ciascun tipo, mentre gli effetti anno-per-tipo-di-elezione assorbono gli shock comuni specifici dell’elezione. I termini di controllo contengono le necessarie interazioni di ordine inferiore, con una normalizzazione appropriata affinché i tre coefficienti mostrati siano effetti complessivi specifici per elezione. Includere un termine comune ridondante riuscita-per-periodo-successivo insieme a tutte e tre le interazioni complete per tipo di elezione creerebbe collinearità.
In una semplice interpretazione a due periodi, ciascun coefficiente confronta la variazione prima–dopo nei luoghi con attentati riusciti con la variazione corrispondente nei luoghi con attentati falliti, per quel tipo di elezione. Il panel effettivo riunisce più eventi e anni, quindi l’identificazione e la ponderazione richiedono il modello completo. Il disturbo è l’errore della regressione; non è esso stesso un errore standard. Gli errori standard sono stimati a partire dai dati e raggruppati in cluster per comune, per consentire che gli esiti all’interno dello stesso luogo siano correlati.
Leggere i risultati elettorali senza confondere le unità di misura
La specificazione di base comprende 734 osservazioni e 124 cluster comunali. I suoi coefficienti sono riportati su una scala della quota di voti compresa tra zero e uno. Moltiplicare sia i coefficienti sia gli errori standard per 100 li converte in punti percentuali. La tabella applica questa conversione alle stime di base pubblicate.
| Tipo di elezione | Effetto, punti percentuali | Errore standard con cluster per comune | Intervallo approssimato al 95%, punti percentuali |
|---|---|---|---|
| Federale | 0.05 | 1.99 | −3.85 a 3.95 |
| Parlamento europeo | −1.16 | 2.52 | −6.10 a 3.78 |
| Land | 4.46 | 1.12 | 2.26 a 6.66 |
Gli intervalli utilizzano l’approssimazione normale, , e sono inclusi per rendere visibile l’incertezza. Non sostituiscono l’analisi di robustezza del lavoro relativa al numero limitato di cluster. La stima per le elezioni dei Länder è di circa 4.5 punti percentuali. Rispetto alla media campionaria arrotondata del 17 percento, . Si tratta di un aumento relativo della quota di voti, non dell’affermazione che il 26 percento degli individui abbia cambiato partito o che il sostegno sia aumentato di 26 punti percentuali.
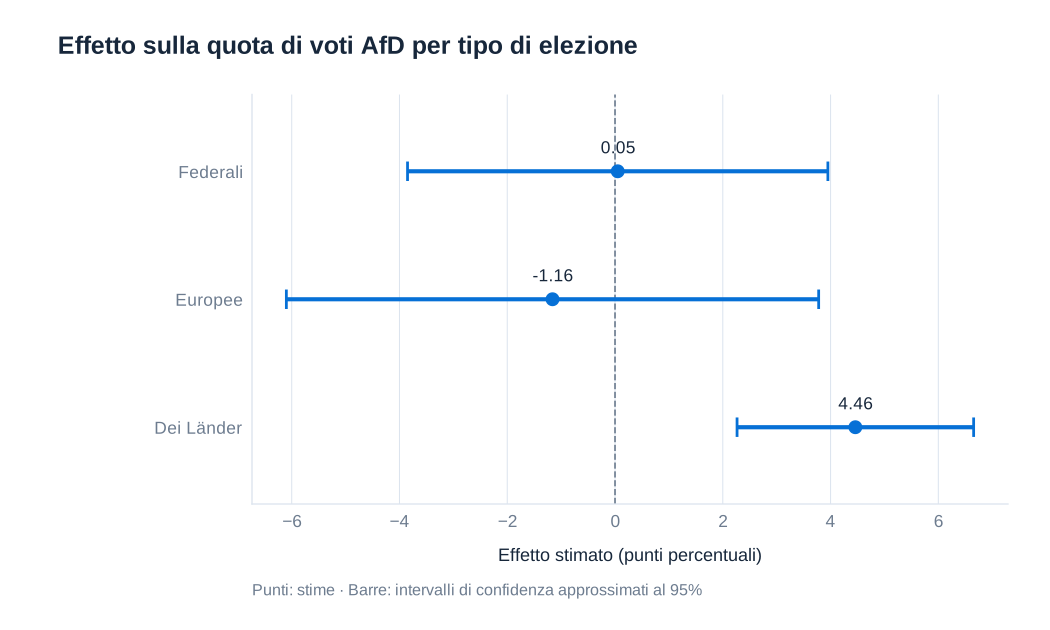
Le stime federali ed europee non sono statisticamente distinguibili da zero in questa specificazione di base. I loro intervalli di incertezza comprendono effetti di entrambi i segni, quindi l’evidenza non accerta effetti esattamente nulli. Analogamente, una stima significativa per le elezioni dei Länder e una stima non significativa per un altro tipo non costituiscono, da sole, un test formale della differenza tra i due effetti. Quel confronto richiede l’errore standard della loro differenza, tenendo conto della covarianza.
Il coefficiente delle elezioni dei Länder rimane positivo nelle specificazioni aggiuntive: 4.16 punti con controlli Est-per-anno, 4.93 escludendo Berlino, 5.87 rimuovendo i comuni con più attentati e 3.34 includendo l’insieme completo delle covariate iniziali interagite con l’anno. Queste sono specificazioni alternative di un’unica domanda sostanziale; non dovrebbero essere mediate come se fossero studi indipendenti.
Mettere alla prova identificazione e inferenza
Le dimensioni ridotte del gruppo di confronto con soli attentati falliti rendono l’inferenza una questione centrale. Centinaia di osservazioni elettorali non forniscono centinaia di comuni di controllo indipendenti. Il lavoro utilizza quindi l’inferenza mediante wild cluster bootstrap, esamina l’effetto dell’esclusione a turno di ciascun comune e applica uno stimatore alternativo concepito per trattamenti introdotti in momenti diversi. Queste verifiche affrontano l’incertezza, i luoghi influenti e ponderazioni potenzialmente problematiche in presenza di effetti eterogenei.
Un’analisi a finestra mobile include ulteriori attentati confrontando le elezioni intorno a ciascun episodio comune–attentato. Questo recupera informazioni perse considerando soltanto il primo evento rilevante, ma crea un’altra difficoltà: un’elezione successiva a un attentato può precederne un altro. Le finestre sovrapposte rendono meno semplici il parametro oggetto di stima e la struttura di dipendenza. Lo studio tratta quindi questo approccio come un esercizio di robustezza, anziché presumere che ogni finestra sia un esperimento indipendente.
Per indagare gli attentati falliti, i ricercatori costruiscono un gruppo di confronto alternativo di comuni senza attentati e simili nelle caratteristiche osservabili, utilizzando il propensity-score matching. Gli attentati riusciti confrontati con questi luoghi abbinati producono una stima per le elezioni dei Länder di 2.99 punti percentuali, con un errore standard di 1.32. Gli attentati falliti confrontati con luoghi abbinati producono −1.69 punti, con un errore standard di 1.98. Quest’ultima stima non è conclusiva. L’esercizio sostiene un ruolo più forte degli attentati riusciti, ma non dimostra che quelli falliti abbiano conseguenze esattamente nulle.
Il matching cambia il requisito identificante: si basa sulla capacità delle caratteristiche osservabili selezionate di tenere adeguatamente conto delle differenze rilevanti tra luoghi presi di mira e non presi di mira. Non crea un’assegnazione casuale. Gli effetti di propagazione geografica sollevano un’ulteriore questione perché i comuni vicini possono reagire anche senza subire attentati. Lo studio rileva effetti nelle aree circostanti, spesso pari a circa metà dell’entità di base a distanze comprese tra 25 e 75 chilometri, che si attenuano intorno agli 80 chilometri. Queste risposte costituiscono esiti informativi di per sé e mettono anche in guardia dall’assumere che ogni comune vicino sia un controllo non influenzato.
Affluenza, quote di voto e problema dell’inferenza ecologica
Un partito può guadagnare voti grazie a elettori appena mobilitati, a passaggi da altri partiti o a entrambi. La distinzione dipende dai denominatori. L’affluenza è il rapporto tra voti espressi e aventi diritto; la quota di voti di un partito è il rapporto tra i suoi voti e tutti i voti validi espressi. Una misura di partecipazione specifica del partito divide invece i voti di quel partito per gli aventi diritto. Queste grandezze non possono essere utilizzate in modo intercambiabile.
La stima pubblicata per l’affluenza complessiva alle elezioni dei Länder è 0.1469, ossia 14.69 punti percentuali. La corrispondente stima dei voti all’AfD per avente diritto è 0.0537, ossia 5.37 punti. Il loro rapporto è circa il 36.6 percento. Descriverlo come la quota di elettori appena mobilitati che scelgono l’AfD richiederebbe di assumere l’assenza di passaggi tra partiti. I dati mostrano evidenza di tali passaggi, quindi il rapporto non rappresenta un’allocazione identificata a livello individuale dei nuovi elettori. Non implica neppure che l’AfD abbia intercettato la maggioranza dell’aumento dell’affluenza.
La maggior parte dei principali partiti riceve alcuni voti aggiuntivi per avente diritto, ma la distribuzione è diseguale. L’AfD ottiene una quota del sostegno aggiuntivo sufficientemente elevata da aumentare la propria quota di voti. Anche l’SPD registra un effetto positivo più piccolo sulla quota di voti alle elezioni dei Länder, mentre gli altri principali partiti non mostrano un aumento chiaro comparabile. I soli risultati aggregati non possono rivelare precisamente quali individui siano passati dall’astensione o da un altro partito all’AfD. Questo è il problema dell’inferenza ecologica: le variazioni nei totali di gruppo non identificano univocamente i cambiamenti nei comportamenti individuali.
Utilizzare dati panel individuali per indagare i meccanismi
Il German Socio-Economic Panel segue le stesse persone nel tempo e consente di collegare i dati sugli attentati al loro comune di residenza. Per un individuo , lo studio stima:
Gli effetti fissi individuali eliminano le differenze stabili tra gli intervistati, mentre gli effetti annuali assorbono i cambiamenti comuni. L’esito è un indicatore di un atteggiamento o di una preferenza, e gli errori standard rimangono raggruppati in cluster per comune perché il trattamento avviene a quel livello. La regressione combina quindi variazioni dell’esito a livello individuale con un disegno del trattamento a livello di gruppo. Le stime selezionate seguenti sono variazioni in punti percentuali; l’ultima colonna riporta il numero di individui utilizzati per ciascun esito.
| Esito individuale | Effetto, punti percentuali | Errore standard con cluster | Individui |
|---|---|---|---|
| Si identifica come di destra | 6.52 | 2.06 | 2,286 |
| Si identifica come di destra radicale | 4.38 | 1.79 | 2,286 |
| Preferisce l’AfD | 2.34 | 1.04 | 2,401 |
| Partecipa alla politica locale | 2.05 | 0.693 | 3,715 |
| È preoccupato per l’immigrazione | 3.61 | 1.74 | 4,102 |
| È preoccupato per il terrorismo | 0.204 | 2.61 | 2,682 |
I risultati sono coerenti con cambiamenti nelle preferenze e nella partecipazione politica, non semplicemente con variazioni nella composizione dell’elettorato. Tuttavia, una preferenza partitica dichiarata non è un voto segreto osservato, e i diversi esiti hanno campioni e frequenze di osservazione differenti. La piccola stima relativa alla preoccupazione per il terrorismo è particolarmente imprecisa. Un livello iniziale di preoccupazione già elevato, intorno all’84 percento, lascia meno spazio a un ulteriore incremento e può contribuire a spiegare il risultato senza dimostrare un particolare meccanismo psicologico.
Ulteriori analisi distinguono il precedente legame partitico dalla precedente attività politica. La preferenza per l’AfD aumenta tra alcuni intervistati precedentemente legati alla CDU, al partito della Sinistra e ai partiti di estrema destra, oltre che tra gli intervistati meno legati a un partito. Anche le persone precedentemente inattive diventano più propense a preferire l’AfD. Questi risultati sostengono sia il cambiamento di preferenze sia l’attivazione politica; non forniscono una scomposizione completa ed esatta dell’effetto aggregato sulla quota di voti. Gli effetti variano anche con il livello di istruzione: lo spostamento verso la preferenza per l’AfD è più forte tra gli intervistati privi di un titolo di istruzione terziaria, mentre la risposta relativa all’SPD è diversa. Un’affermazione fondata di eterogeneità richiede di verificare la differenza tra gli effetti dei gruppi, non semplicemente di contare quale gruppo abbia un coefficiente significativo.
Motivazioni degli attentati, messaggi politici e salienza mediatica
Gli effetti si concentrano negli attentati di destra e in quelli diretti contro stranieri. Le stime puntuali pubblicate sono circa 5.6 punti percentuali per gli attentati di destra e 6.1 per quelli che prendono di mira gli stranieri, rispetto a stime più piccole e meno precise per le categorie alternative. Queste categorie possono sovrapporsi, quindi non sono componenti additive dell’effetto complessivo. Il quadro non dimostra neppure che l’AfD abbia organizzato o diretto gli attentati: il vantaggio elettorale e la responsabilità della violenza sono affermazioni diverse.
I programmi politici offrono una prospettiva complementare su come vengono interpretati gli eventi. I ricercatori contano determinate radici lessicali ogni 10,000 parole, sottraggono un riferimento comune costituito dal programma della CDU del 2009 e mettono in relazione queste differenze linguistiche con gli attentati riusciti precedenti a livello di Land. L’AfD utilizza più linguaggio collegato a criminalità, naturalizzazione e integrazione nei Länder più esposti, mentre le risposte degli altri partiti differiscono. La normalizzazione evita di attribuire meccanicamente più occorrenze ai documenti più lunghi, anche se i conteggi delle parole rimangono misure imperfette del significato, dell’enfasi o della persuasione.
Questa analisi ha un disegno causale più debole del confronto tra comuni. L’aggregazione a 16 Länder riduce la variazione indipendente e fa perdere il confronto netto tra attentati riusciti e falliti. Fornisce quindi evidenza coerente con un canale di comunicazione politica, non una stima separatamente randomizzata dell’effetto persuasivo di quelle parole. Analogamente, l’analisi dei media rileva una copertura locale e regionale più intensa degli attentati riusciti, con tono e vocabolario differenti. Gli attentati con maggiore copertura hanno associazioni elettorali più forti, compresi effetti sulle elezioni federali, ma la copertura è essa stessa una risposta endogena agli eventi. La selezione degli eventi che ricevono ampia copertura impedisce di interpretare quel contrasto come un esperimento che assegna casualmente l’esposizione alle notizie.
Che cosa insegna il caso sull’evidenza causale
Questa applicazione riunisce diversi principi fondamentali. Un confronto credibile viene scelto sulla base di una fonte plausibile di variazione, anziché per comodità. Il parametro oggetto di stima è definito come attentati riusciti rispetto ad attentati falliti, mentre il confronto tra attentati e assenza di attentati richiede evidenza separata. Gli effetti fissi assorbono forme specifiche di eterogeneità, mentre gli esercizi di bilanciamento, analisi temporale e sensibilità esaminano le minacce rimanenti. L’inferenza con cluster rispetta il livello del trattamento. L’evidenza sui meccanismi combina esiti elettorali aggregati con osservazioni ripetute di individui e comunicazioni politiche, senza presumere che queste analisi separate identifichino completamente un’unica catena di mediazione.
Il risultato è specifico sul piano storico e istituzionale: attentati locali in Germania durante il periodo studiato, un particolare insieme di comuni presi di mira e una specifica struttura partitica ed elettorale. Non dimostra che ogni evento terroristico in ogni Paese favorisca la destra politica. La lettura più utile dello studio è quindi sia sostanziale sia metodologica: la violenza politica può modificare partecipazione e preferenze, mentre la forza di ciascuna affermazione causale dipende dal gruppo di confronto, dalle ipotesi identificanti, dall’incertezza e dalla misurazione.
Fonte della ricerca: Navid Sabet, Marius Liebald e Guido Friebel (2025), Terrorism and Voting: The Rise of Right-Wing Populism in Germany, American Economic Journal: Economic Policy, 17(3), 407–440, DOI: 10.1257/pol.20230615. I risultati elettorali di base utilizzano la Tabella 2; i risultati dei confronti con matching utilizzano la Tabella 3; le risposte individuali utilizzano la Tabella 4; l’analisi del legame partitico e dell’attività politica utilizza la Tabella 5. Gli intervalli e le conversioni in punti percentuali in questo capitolo sono calcolati a partire dalle stime e dagli errori standard riportati.