
1. Domande economiche, dati e causalità
Questo manuale sviluppa teoria, inferenza e applicazioni econometriche, dalla probabilità e dai minimi quadrati ai moderni metodi causali, alle serie storiche, ai dati panel e alla previsione regolarizzata. Esempi numerici e figure sono illustrazioni didattiche sintetiche o schematiche; non sono stime ricavate da uno studio empirico esterno.
Che cosa identifica l'econometria e che cosa una correlazione non può dimostrare
Modelli economici ed evidenza statistica
L'econometria collega il ragionamento economico alla misurazione empirica. Un modello economico propone meccanismi: la domanda può rispondere ai prezzi e al reddito, la produttività può rispondere all'istruzione e gli investimenti possono reagire ai tassi di interesse. Un modello econometrico traduce queste relazioni in variabili osservabili, parametri incogniti e un termine di disturbo stocastico che rappresenta le influenze non incorporate esplicitamente. Lo scopo della stima non consiste semplicemente nel tracciare una retta attraverso i dati. Consiste nel comprendere quali affermazioni quantitative possano essere sostenute dalla variazione disponibile, esplicitando l'incertezza e i limiti dell'interpretazione.
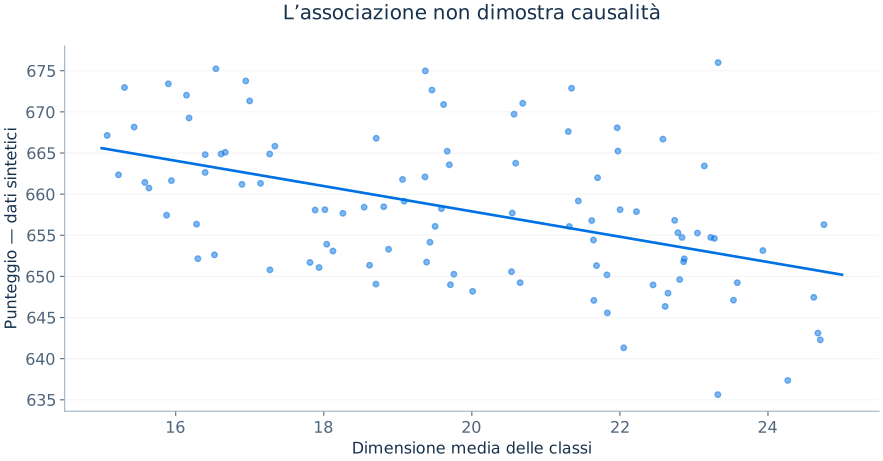
Consideriamo una domanda di politica scolastica relativa alla numerosità delle classi. Indichiamo con Yi il punteggio medio nei test del distretto i, con Di la numerosità media delle sue classi e con Wi caratteristiche osservate come il reddito familiare. Un'utile specificazione iniziale è
La variabile di risultato Yi e la variabile esplicativa Di sono misurate, β1 è il parametro di interesse principale, Wi′γ riassume i controlli misurati e ui contiene le determinanti omesse e la variazione idiosincratica. Il coefficiente angolare β1 rappresenta un'associazione condizionata nell'ambito del modello, a meno che le ipotesi identificative non ne giustifichino l'interpretazione come effetto causale. Se i distretti più avvantaggiati scelgono classi meno numerose, una regressione semplice può confondere i vantaggi familiari con le risorse scolastiche. Un campione ampio riduce l'errore campionario, non il confondimento sistematico.
La stessa distinzione vale quando un analista si chiede se la formazione aumenti i salari, se imposte più elevate sulle sigarette riducano il fumo, se le istituzioni determinino il reddito o se uno spread della curva dei rendimenti preveda la crescita del PIL. La previsione richiede informazioni utili sui risultati futuri; l'identificazione di un parametro causale richiede confronti credibili tra risultati controfattuali. Una variabile può essere un ottimo predittore senza causare il risultato che prevede.
Strutture dei dati e disegni di ricerca
I dati trasversali osservano numerose unità in un unico momento, per esempio reddito e istruzione delle famiglie tra diversi individui. Il pedice i identifica individui, imprese, distretti o paesi. Un campione trasversale casuale rende le medie campionarie e i coefficienti di regressione stime naturali delle caratteristiche della popolazione, anche se la mancata risposta, il raggruppamento delle osservazioni, la selezione e i dati mancanti possono invalidare un modello ingenuo di campionamento casuale.
Le serie storiche osservano una o più variabili nel tempo. L'ordine cronologico conta perché Yt può dipendere da Yt₋1. Tendenze, volatilità variabile, andamenti stagionali e risposte dinamiche impongono di riconsiderare le ipotesi appropriate per osservazioni indipendenti. Le serie storiche consentono inoltre vere previsioni, che devono essere valutate mediante osservazioni non utilizzate per stimare il modello previsivo.
I dati panel, o longitudinali, osservano le stesse unità economiche in più periodi e ne indicano i risultati con Yit. Un panel può distinguere le differenze persistenti tra individui dai cambiamenti che avvengono all'interno di ciascun individuo. Per esempio, le differenze di capacità manageriale tra imprese possono contaminare una correlazione trasversale tra capitale e profitti, mentre osservazioni ripetute possono permettere di controllare per capacità invarianti nel tempo.
Le sezioni trasversali ripetute o aggregate differiscono dai veri dati panel: i campioni relativi a periodi diversi non devono necessariamente contenere le stesse persone. Ogni disegno implica un diverso modello di campionamento e influisce sull'insieme delle domande empiriche a cui è possibile rispondere in modo credibile.
| Struttura dei dati | Indice tipico | Esempio | Problema principale |
|---|---|---|---|
| Sezione trasversale | i | Imprese nel 2026 | Selezione e confondimento |
| Serie storica | t | PIL trimestrale | Dipendenza seriale e tendenze |
| Panel | i,t | Stesse imprese nel 2020–2026 | Eterogeneità non osservata |
| Sezioni trasversali aggregate | i,t | Lavoratori diversi nel 2020 e nel 2026 | Cambiamenti nella composizione |
Risultati potenziali e problema della selezione
Per formalizzare una domanda causale, immaginiamo che ogni unità abbia due risultati potenziali: Yi(1) se riceve un trattamento e Yi(0) se non lo riceve. Sia Di ∈ {0,1} l'indicatore del trattamento effettivamente ricevuto. Si osserva un solo risultato potenziale:
L'effetto causale individuale è Yi(1) − Yi(0), ma non possiamo osservare direttamente entrambi i risultati per una stessa unità. Spesso ci interessa l'effetto medio del trattamento ATE = E[Y(1) − Y(0)] oppure l'effetto medio del trattamento sui trattati ATT = E[Y(1) − Y(0) | D=1]. Si tratta di quantità diverse quando gli effetti del trattamento sono eterogenei e la selezione dipende dai benefici del trattamento.
Una differenza osservata tra medie di gruppo può essere scomposta esattamente:
L'espressione tra parentesi graffe è la distorsione da selezione: la differenza che esisterebbe tra il gruppo trattato e quello non trattato anche se nessuno ricevesse il trattamento. Se i pazienti intrinsecamente più malati hanno maggiore probabilità di ricevere cure ospedaliere, un semplice confronto degli esiti di salute può suggerire che gli ospedali peggiorino la salute anche quando il trattamento è benefico. Questo mostra perché associazioni ampie e statisticamente precise possano risultare fuorvianti dal punto di vista causale.
In un esperimento controllato randomizzato condotto correttamente, l'assegnazione del trattamento è indipendente da entrambi i risultati potenziali e il gruppo trattato e quello di controllo hanno gli stessi risultati controfattuali attesi. Di conseguenza, la differenza tra i risultati osservati attesi identifica l'ATE. L'assegnazione casuale non garantisce che i campioni finiti siano perfettamente bilanciati; inoltre, la mancata adesione al trattamento assegnato, l'abbandono dello studio, le interferenze e i problemi di misurazione richiedono comunque attenzione.
Quantità oggetto di stima, stimatore e stima
La quantità oggetto di stima, o estimando, è la grandezza di interesse nella popolazione definita in modo preciso, per esempio l'effetto causale della riduzione della numerosità di una classe di uno studente. Uno stimatore è la regola casuale applicata ai dati, come il coefficiente OLS calcolato su un campione; la stima è il valore numerico ottenuto quando tale regola viene applicata ai dati osservati. Confondere questi concetti conduce a interpretazioni eccessivamente sicure: una stima calcolata con precisione non mira necessariamente all'effetto causale descritto nella domanda di ricerca.
Un buon lavoro empirico specifica l'unità di osservazione, la popolazione, la convenzione di misurazione, il parametro di interesse, la fonte di variazione identificativa, i meccanismi alternativi plausibili e la procedura inferenziale. Un errore standard misura la variabilità campionaria nell'ambito di un modello, non la credibilità delle ipotesi identificative. L'identificazione è concettuale; l'inferenza è statistica; nessuna delle due può sostituire l'altra.
Domande per un progetto empirico
Prima di calcolare qualsiasi regressione, occorre chiedersi quale intervento o cambiamento di politica si voglia comprendere, quale confronto approssimi l'esperimento ideale, se la variazione della variabile esplicativa sia plausibilmente equivalente a una variazione casuale condizionatamente ai controlli e quale popolazione sia rappresentata dal parametro stimato. Un secondo insieme di domande riguarda l'adeguamento degli errori standard al raggruppamento delle osservazioni o alla dipendenza seriale, la presenza di un numero sufficiente di unità indipendenti e la rilevanza pratica del risultato.
Dalla domanda alla specificazione della ricerca
Immaginiamo che a un economista venga chiesto di stimare come un aumento delle tasse universitarie influenzi le iscrizioni. Un'analisi poco attenta regredisce le iscrizioni sulle tasse e definisce il coefficiente angolare come elasticità della domanda. Un'analisi rigorosa si chiede prima se le tasse varino tra istituzioni, persone o periodi; se le borse di studio modifichino i prezzi netti; se gli studenti scelgano le università in base alla qualità; e se le università adeguino le tasse in risposta alla domanda. Un'elasticità della domanda valida descrive i cambiamenti nelle scelte quando il prezzo varia per ragioni che non siano a loro volta causate da spostamenti della domanda. I prezzi osservati in equilibrio possono quindi essere endogeni.
L'oggetto dell'analisi potrebbe essere un aumento delle tasse dell'uno per cento, un aumento in valore assoluto di €1,000 oppure un cambiamento discreto di politica da un sistema di tasse a un altro. Ogni intervento ha conseguenze diverse e potrebbe non essere identificabile a partire dagli stessi dati. Per esempio, se alcune istituzioni ammettono soltanto candidati benestanti, potrebbe esserci scarsa sovrapposizione tra gli studenti che affrontano prezzi diversi. Gli estimandi devono essere definiti rispetto al margine rilevante e alla popolazione direttamente esposta a quel margine.
L'interpretazione economica richiede inoltre di considerare l'equilibrio generale e gli effetti di ricaduta. Un programma che aumenta la formazione di alcuni lavoratori può modificare i salari o le opportunità occupazionali dei lavoratori non trattati; in questo caso, i loro risultati osservati non costituiscono controlli non influenzati dall'intervento. L'ipotesi di stabilità del valore del trattamento per unità (SUTVA) combina restrizioni sulle interferenze e sulla definizione delle versioni del trattamento. In molte applicazioni economiche queste restrizioni sono ipotesi sostanziali, non semplici convenzioni statistiche prive di conseguenze.
Esempi rappresentativi di previsione e inferenza causale
Supponiamo che un analista utilizzi le vendite dell'anno precedente, le visite al sito web e indicatori stagionali per prevedere le vendite del mese successivo. Questo problema previsivo riguarda l'accuratezza e la stabilità in condizioni future. Non implica necessariamente che aumentare le visite mediante traffico artificiale incrementi le vendite. Un secondo analista studia se un sussidio alla pubblicità causi una crescita delle vendite. Questo problema causale richiede che l'assegnazione del trattamento sia indipendente dai risultati potenziali delle vendite nell'ambito di un disegno appropriato. Entrambi gli analisti possono usare la regressione, ma rispondono a domande diverse e potrebbero aver bisogno di covariate e procedure di validazione differenti.
Un'ulteriore complicazione è la risposta delle politiche. Se le amministrazioni locali aumentano la spesa quando la disoccupazione comincia a crescere, un coefficiente della spesa stimato su dati trasversali o serie storiche può mostrare un'associazione positiva con la disoccupazione anche se la spesa pubblica aggiuntiva compensa in parte le perdite di posti di lavoro. Un effetto causale può avere segno diverso dall'associazione osservativa perché la politica viene indirizzata dove si prevede un peggioramento dei risultati. Occorre dichiarare che cosa avrebbe fatto il governo in assenza della politica e come sia possibile approssimare tale controfattuale.
2. Probabilità per i dati economici
Variabili casuali, distribuzioni congiunte, aspettative condizionate e campionamento
Variabili casuali e distribuzioni
Una variabile casuale assegna un valore numerico a ogni possibile esito di un processo incerto. Le variabili casuali discrete possiedono una funzione di massa di probabilità p(x) = P(X=x) e le loro probabilità sommano a uno. Le variabili casuali continue sono rappresentate da una densità f(x): le probabilità corrispondono ad aree sotto la densità, non al suo valore in un singolo punto. La funzione di distribuzione cumulata F(x)=P(X≤x) esiste per entrambi i tipi ed è non decrescente.
Una variabile economica presenta spesso una distribuzione asimmetrica: redditi da lavoro, ricchezza e dimensioni delle imprese possono avere una lunga coda destra. La media campionaria descrive il reddito medio, mentre la mediana può rappresentare più efficacemente l'esperienza di un'osservazione tipica. Nessuna delle due statistiche, da sola, caratterizza la dispersione o le differenze tra sottogruppi della popolazione.
Valori attesi, varianza e covarianza
Il valore atteso è la media dei possibili risultati ponderata per le rispettive probabilità. Per una variabile discreta è E[X] = Σx x p(x); nel caso continuo è E[X] = ∫x f(x)dx, purché l'integrale esista. La linearità rende i valori attesi particolarmente utili:
A differenza della linearità dei valori attesi, alcune utili semplificazioni della varianza richiedono l'indipendenza. La varianza della popolazione è Var(X)=E[(X−μx)2]=E[X2]−μx2, con deviazione standard σx = √Var(X). La varianza è misurata in unità al quadrato; la deviazione standard torna alla scala di X. Per costanti a e b, Var(a+bX)=b2Var(X).
La covarianza misura la variazione congiunta tenendo conto del segno:
Il coefficiente di correlazione ρx𝓏=Cov(X,Z)/(σxσ𝓏) è adimensionale ed è compreso tra −1 e 1. Una correlazione nulla esclude un'associazione lineare, ma non ogni dipendenza non lineare. L'indipendenza implica covarianza nulla quando i momenti esistono, ma una covarianza nulla non implica generalmente indipendenza. Per esempio, una variabile casuale X simmetrica attorno a zero e il suo quadrato X2 possono essere incorrelati, quando i momenti necessari esistono, anche se X2 è completamente determinato da X.
La varianza di una somma è
Se la covarianza è negativa, combinare variabili può ridurre il rischio. Questo è il fondamento statistico della diversificazione di portafoglio; variabili indipendenti hanno covarianza nulla, ma la formula utile della varianza non richiede di per sé l'indipendenza.
Aspettative condizionate e legge delle aspettative iterate
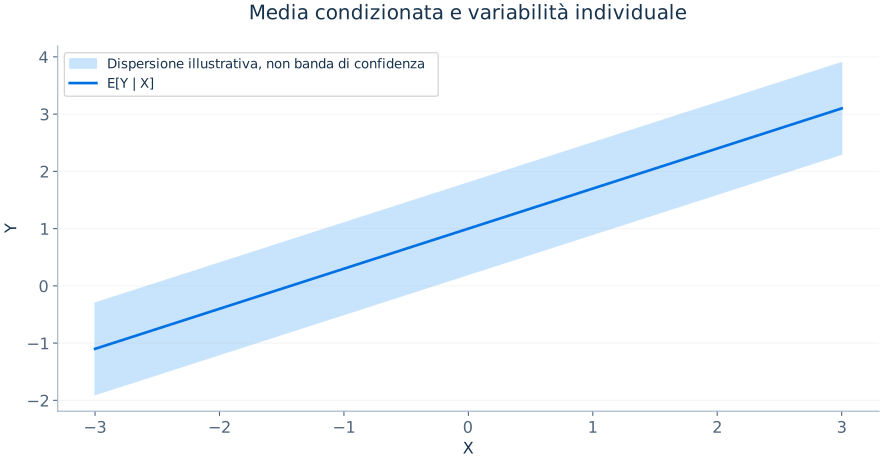
L'aspettativa condizionata E[Y|X=x] è il valore medio di Y tra le osservazioni con X=x nella distribuzione della popolazione. È una funzione di x, non una costante. Nella relazione tra reddito e consumo, descrive il consumo medio a diversi livelli di reddito. La funzione di aspettativa condizionata (CEF) è la relazione media non vincolata, mentre una regressione lineare approssima tale relazione mediante una combinazione lineare di regressori.
La legge delle aspettative iterate stabilisce che
La media complessiva può essere ottenuta calcolando dapprima la media di Y nei gruppi definiti da X e poi la media di tali medie di gruppo usando le probabilità dei gruppi nella popolazione. Definiamo ε=Y−E[Y|X]. Per costruzione E[ε|X]=0 ed ε è incorrelato con ogni funzione integrabile di X. Questa scomposizione esatta non richiede che la CEF sia lineare.
La legge della varianza totale precisa ulteriormente questa scomposizione:
La prima componente misura la variazione delle medie condizionate al variare di X e la seconda misura la variazione media all'interno dei gruppi definiti da X. Ciò aiuta a spiegare l'adattamento della regressione come ripartizione tra variazione prevista e variazione non spiegata.
Indipendenza condizionata
Se Y e D sono condizionatamente indipendenti dato X, conoscere D non aggiunge informazioni sulla distribuzione di Y una volta noto X. Per l'inferenza causale, spesso si richiede la condizione più forte che il vettore dei risultati potenziali (Y(0),Y(1)) sia indipendente dal trattamento D condizionatamente ai controlli precedenti al trattamento X. Questa condizione è talvolta chiamata assenza di confondimento o selezione sulle variabili osservabili. È un'ipotesi relativa a controfattuali non osservati, non qualcosa che un elevato R2 della regressione possa dimostrare.
L'indipendenza condizionata non significa che X non abbia alcuna relazione con il trattamento o con il risultato. Il suo scopo è garantire che i confronti a parità di X siano credibili. Per confrontare unità trattate e non trattate con caratteristiche simili serve anche la sovrapposizione, ossia 0<P(D=1|X=x)<1 per i valori studiati. Se un certo sottogruppo è sempre trattato, i suoi risultati controfattuali in assenza di trattamento non possono essere ricostruiti in modo non parametrico dal campione osservato.
Campionamento casuale e statistiche descrittive
Con un campionamento indipendente e identicamente distribuito, ogni osservazione segue la stessa distribuzione della popolazione ed è indipendente dalle altre. La media campionaria e la consueta varianza campionaria non distorta sono
L'errore standard della media campionaria è σ/√n quando σ è noto e il campionamento è indipendente; s/√n ne fornisce una stima nelle applicazioni ordinarie. Il fattore √n è centrale: quadruplicare un campione indipendente di norma dimezza l'errore standard. La distorsione sistematica, invece, generalmente non scompare per il solo aumento di n.
Distribuzioni di probabilità utilizzate nell'inferenza
Una variabile distribuita normalmente è simmetrica ed è completamente descritta dalla sua media e dalla sua varianza. Se Z è normale standard, P(|Z|≤1.96)≈0.95. La distribuzione χ2 deriva da somme di quadrati di variabili normali standard. La distribuzione t di Student deriva dalla divisione di una quantità normale per una deviazione standard stimata indipendente, e i gradi di libertà influenzano lo spessore delle code. La distribuzione F è il rapporto tra variabili χ2 indipendenti opportunamente scalate e compare nei test di più restrizioni lineari.
Queste distribuzioni sono importanti perché le procedure di verifica delle ipotesi richiedono affermazioni sul comportamento campionario degli stimatori. La validità di una distribuzione t o F esatta dipende da ipotesi più forti di quelle necessarie per un'approssimazione normale in grandi campioni.
Legge dei grandi numeri e teorema del limite centrale
La legge debole dei grandi numeri (LLN) stabilisce la convergenza della media campionaria verso la media della popolazione in presenza di opportune condizioni di campionamento e sui momenti. Il teorema del limite centrale (CLT) caratterizza la distribuzione campionaria dei suoi scostamenti. Per osservazioni indipendenti con varianza finita,
La freccia indica la convergenza in distribuzione. La LLN spiega perché la stima diventi accurata al crescere di n; il CLT spiega come si possa quantificare la sua incertezza. Una distribuzione campionaria di forma normale non significa che salari, redditi individuali o profitti delle imprese seguano distribuzioni normali.
Regola di Bayes e condizionamento rispetto a eventi
La regola di Bayes è un metodo sistematico per aggiornare una probabilità dopo aver ricevuto nuove informazioni. Per eventi A e B con P(B)>0,
Supponiamo che il 4% delle imprese di un settore risulti insolvente nel corso dell'anno. Un indicatore di valutazione preliminare è positivo per l'80% delle imprese che diventeranno insolventi e per il 15% delle imprese che non lo diventeranno. La probabilità di un segnale positivo è 0.80×0.04+0.15×0.96=0.176. La probabilità di insolvenza dato un segnale positivo è 0.032/0.176≈0.182, ossia 18.2%. Il segnale identifica un rischio più elevato, ma non implica una probabilità di insolvenza dell'80%. Questa distinzione mostra l'importanza economica delle frequenze di base per l'analisi del rischio di credito e per i modelli di classificazione.
Le probabilità condizionate si estendono alle variabili continue mediante le densità condizionate. Per Y e X continue dotate di densità congiunta, f(y|x)=f(x,y)/fx(x) dove fx(x)>0. La media condizionata E[Y|X=x] integra y rispetto a questa densità condizionata. Una regressione modella alcuni aspetti di tale distribuzione condizionata, non l'intera distribuzione congiunta, a meno che non vengano imposte ulteriori ipotesi statistiche.
Disuguaglianza di Jensen, utilità attesa e trasformazioni logaritmiche
Per una funzione concava h, la disuguaglianza di Jensen implica E[h(X)]≤h(E[X]) in condizioni appropriate; la disuguaglianza si inverte per funzioni convesse. Poiché ln è concava, E[ln Y]≤ln(E[Y]) per Y positivo. Questo spiega perché la media del logaritmo del reddito non sia il logaritmo del reddito medio. La distinzione è rilevante anche per interpretare le regressioni logaritmiche stimate e per distinguere tra variazioni proporzionali medie e variazioni di una media aritmetica.
Nella teoria economica delle decisioni, la concavità dell'utilità genera avversione al rischio: l'utilità della ricchezza attesa può superare l'utilità attesa di una ricchezza rischiosa. Dal punto di vista econometrico, applicare trasformazioni alla variabile di risultato modifica la funzione di perdita e la quantità la cui aspettativa condizionata viene approssimata dalla regressione. Un modello del logaritmo dei salari non è semplicemente un espediente numerico equivalente a un modello dei salari.
La covarianza delle medie campionarie in presenza di dipendenza
Per osservazioni indipendenti e identicamente distribuite, Var(Ȳ)=σ2/n. In assenza di indipendenza, la varianza della media è
I termini di covarianza incrociata si annullano in presenza di indipendenza, ma non necessariamente per studenti della stessa classe o per osservazioni ripetute di una stessa impresa. Questa identità è la ragione elementare per cui il raggruppamento delle osservazioni e la correlazione seriale influenzano gli errori standard. Se l'errore di ogni studente include lo stesso shock di classe, la quantità effettiva di informazione può essere molto più vicina al numero di classi che al numero totale di studenti.
3. Stima e inferenza statistica
Distribuzioni campionarie, distorsione, consistenza, efficienza e incertezza
Parametri e stimatori
Un parametro è una caratteristica fissa della distribuzione di una popolazione; uno stimatore è una variabile casuale perché cambia da un campione all'altro. La distorsione di θ̂ è E[θ̂]−θ e la non distorsione significa che il suo valore atteso coincide con il parametro. La consistenza significa che lo stimatore si avvicina in probabilità al parametro al crescere del campione; queste proprietà non sono equivalenti. Uno stimatore può essere distorto nei piccoli campioni e tuttavia consistente, oppure non distorto in determinate condizioni e avere comunque una varianza inaccettabilmente elevata.
L'errore quadratico medio (MSE) combina distorsione e varianza campionaria:
Uno stimatore lievemente distorto può avere un MSE inferiore rispetto a un'alternativa non distorta. Questa è una delle ragioni principali per utilizzare metodi di shrinkage nella previsione. Per la stima causale, tuttavia, occorre distinguere attentamente l'MSE campionario dalla distorsione dovuta all'identificazione: ridurre un coefficiente verso un valore di riferimento non può correggere uno strumento non valido o il confondimento causato da variabili non osservate.
Distribuzione campionaria della media
Per un campione indipendente con varianza finita σ2, E[Ȳ]=μ e Var(Ȳ)=σ2/n. Se le osservazioni sottostanti sono distribuite normalmente, la media campionaria è esattamente normale per qualsiasi n. Altrimenti è spesso approssimativamente normale in campioni sufficientemente grandi, grazie al CLT. Una distribuzione campionaria è una distribuzione concettuale riferita a insiemi di dati ripetutamente estratti attraverso lo stesso meccanismo; normalmente si osserva un solo insieme di dati e si stima l'incertezza che ne deriva.
L'errore standard stimato SE(Ȳ)=s/√n è esso stesso casuale. Quando gli errori sono distribuiti normalmente e σ2 è sconosciuto, (Ȳ−μ)/(s/√n) segue una distribuzione t di Student con n−1 gradi di libertà. Le code si avvicinano a quelle della normale standard all'aumentare dei gradi di libertà. Quando l'ipotesi di normalità non è plausibile, un'approssimazione normale per grandi campioni può rimanere utile, purché valgano il CLT e l'affidabilità dello stimatore della varianza.
Intervalli di confidenza
Un intervallo di confidenza al 95% è una procedura che genera un intervallo casuale con probabilità di copertura del 95% nel modello ipotizzato e in un campionamento ripetuto. Nella terminologia frequentista classica, non afferma che vi sia una probabilità del 95% che un intervallo realizzato e fisso contenga il parametro fisso. Un intervallo approssimato è
Per un piccolo campione normale con varianza sconosciuta, il moltiplicatore è generalmente il valore critico t appropriato anziché 1.96. Gli intervalli devono utilizzare uno stimatore della varianza coerente con il disegno dei dati. Limiti di confidenza basati sull'indipendenza risultano spesso troppo stretti in presenza di osservazioni positivamente correlate.
Verifica delle ipotesi
Un test statistico utilizza la distribuzione campionaria di uno stimatore per valutare se l'evidenza osservata sia compatibile con un'ipotesi nulla. Per H0: θ=θ0, la consueta statistica è
Il p-value è la probabilità, sotto l'ipotesi nulla, di ottenere una statistica del test almeno altrettanto estrema di quella osservata, secondo la definizione fornita dall'ipotesi alternativa. Non è né la probabilità che H0 sia vera né la probabilità che l'alternativa sia corretta. Un test bilaterale al 5% rifiuta per valori t positivi o negativi sufficientemente estremi; un test unilaterale assegna preventivamente la regione di rifiuto a una sola coda.
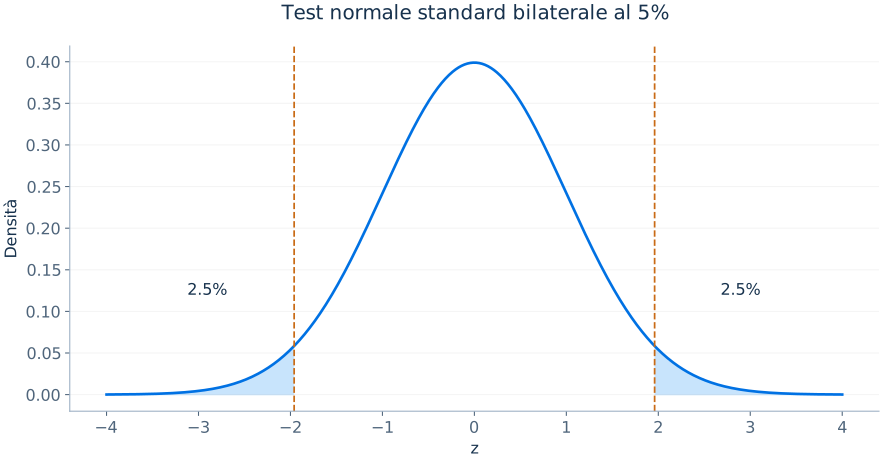
Esistono almeno tre criteri distinti per discutere una stima: significatività statistica, entità economica e qualità dell'identificazione. Un coefficiente può essere statisticamente distinguibile da zero e tuttavia troppo piccolo per avere rilevanza economica. Viceversa, un effetto stimato di una politica può essere elevato ma avere un ampio intervallo di confidenza perché il campione indipendente è piccolo. Nessuna delle due situazioni dimostra, da sola, la causalità.
Confrontare due medie di popolazione
Per campioni indipendenti dei gruppi A e B, la differenza tra medie campionarie Δ̂=Ȳa−Ȳᵦ stima la corrispondente differenza tra medie di popolazione. Se i gruppi sono indipendenti, un errore standard stimato che ammette varianze diverse è
Non è necessario aggregare le varianze dei gruppi, salvo che il modello con varianze uguali sia esplicitamente giustificato. Se le osservazioni costituiscono invece coppie abbinate o misurazioni ripetute sulle stesse unità, la covarianza tra osservazioni modifica la formula della varianza; trattare come indipendenti le osservazioni appaiate spreca informazione o sottostima l'incertezza.
Fonti di errore che gli intervalli di confidenza non correggono
L'errore standard tiene conto della variabilità campionaria nell'ambito del modello di campionamento scelto. Non considera automaticamente errori di codifica, misurazioni distorte, pubblicazione selettiva, dinamiche specificate erroneamente, fattori confondenti omessi o strumenti non validi. Gli intervalli di confidenza quantificano una parte dell'incertezza: non certificano la validità dell'interpretazione economica. Questa distinzione diventa essenziale quando i metodi diventano più sofisticati.
Il bootstrap e il suo corretto ambito di applicazione
Un bootstrap non parametrico campiona ripetutamente con reinserimento le osservazioni dalla distribuzione empirica osservata, ricalcolando lo stimatore per ogni pseudocampione. In condizioni appropriate, la distribuzione risultante delle stime bootstrap approssima la distribuzione campionaria dello stimatore. Gli intervalli bootstrap percentili, di base e studentizzati possono differire, soprattutto quando le distribuzioni sono asimmetriche. Il bootstrap deve seguire la struttura del processo generatore dei dati: occorre ricampionare i gruppi anziché i singoli studenti se le unità statistiche sono le classi, e utilizzare schemi a blocchi appropriati per le serie storiche quando le osservazioni presentano dipendenza seriale.
Il bootstrap non è una soluzione universale ai problemi di identificazione o di strumenti deboli. Ricampionare dati osservativi affetti da confondimento ne riproduce l'associazione confusa; non ricrea un esperimento ideale. Le procedure bootstrap standard possono inoltre non funzionare per stimatori non regolari o non differenziabili e per parametri non regolari. Un metodo di ricampionamento deve essere validato per lo stimatore e per lo schema di campionamento utilizzati.
Errori di I e di II tipo
Un errore di I tipo consiste nel rifiutare un'ipotesi nulla vera. Per un test al 5% correttamente calibrato, la sua probabilità sotto l'ipotesi nulla è il 5%. Un errore di II tipo consiste nel non rifiutare un'ipotesi nulla falsa; la potenza è uno meno la probabilità di errore di II tipo per un'alternativa specificata. Queste probabilità variano con la numerosità campionaria, la varianza della popolazione, l'entità dell'effetto reale e il disegno del test. Una soglia di significatività del 5% non costituisce una garanzia sostanziale che un'affermazione pubblicata sia probabilmente vera.
4. Il modello di regressione lineare semplice
Derivazione dell'OLS e interpretazione di coefficiente angolare, intercetta, previsioni e residui
Modello della popolazione e criterio dei minimi quadrati
Il modello di regressione lineare semplice esprime la variabile di risultato come funzione lineare di una variabile esplicativa e di un disturbo non osservato:
L'intercetta β0 è la media condizionata per X=0 se E[u|X]=0 e X=0 rientra nell'intervallo economicamente significativo dei dati. Il coefficiente angolare β1 misura la variazione della media condizionata di Y per un aumento unitario di X, nell'ambito del modello. Il termine di errore raccoglie le determinanti non osservate; non è semplicemente sinonimo di errori commessi dal ricercatore, anche se gli errori di misurazione possono costituirne una componente.
Lo stimatore dei minimi quadrati ordinari seleziona b0 e b1 in modo da minimizzare i quadrati dei residui stimati:
L'elevamento al quadrato rende positivi i contributi dei residui negativi e positivi e attribuisce maggiore peso agli errori più grandi in valore assoluto. Questo criterio è un'operazione campionaria ben definita, indipendente dal fatto che il regressore sia stato assegnato casualmente. La sua interpretazione causale è una questione distinta.
Derivare il coefficiente angolare e l'intercetta
Deriviamo la somma dei quadrati dei residui rispetto a b0 e b1 e poniamo le derivate uguali a zero. La prima equazione normale stabilisce che i residui campionari sommano a zero; ciò implica che la retta stimata passi per le medie campionarie (X̄,Ȳ). Sostituendo b0=Ȳ−b1X̄ nella seconda equazione normale si ottiene
La pendenza è quindi il rapporto tra la covarianza campionaria e la varianza campionaria di X, usando la stessa normalizzazione al numeratore e al denominatore; equivalentemente, è il rapporto tra la somma dei prodotti degli scarti dalle medie e la somma dei quadrati degli scarti di X dalla propria media. Se X non varia, il denominatore è zero e la pendenza non è stimabile. Il numeratore è positivo quando valori elevati di X si accompagnano sistematicamente a valori elevati di Y, e negativo nel caso opposto.
Residui, valori stimati e identità dell'OLS
Il valore stimato è Ŷi=β̂0+β̂1Xi e il residuo è ûi=Yi−Ŷi. In presenza di intercetta, le equazioni normali dell'OLS garantiscono Σûi=0 e ΣXiûi=0. Di conseguenza, la covarianza campionaria tra valori stimati e residui è nulla e la media dei valori stimati di Y coincide con la media osservata di Y. Si tratta di proprietà algebriche del campione su cui si stima il modello, non della prova che il disturbo non osservato della popolazione sia indipendente da X.
La scomposizione esatta della variabilità campionaria è
I tre termini sono rispettivamente la somma totale dei quadrati (TSS), la somma dei quadrati spiegata (ESS) e la somma dei quadrati dei residui (RSS, denominata anche SSR secondo alcune convenzioni). Ne consegue che 0≤R2≤1 in una regressione OLS contenente un'intercetta, assumendo che la variabile di risultato non sia costante.
Regressori binari: confrontare le medie mediante regressione
Supponiamo che D assuma valori zero e uno e che Yi=β0+β1Di+ui. L'OLS pone β̂0 uguale alla media osservata del risultato tra le unità con D=0 e β̂0+β̂1 uguale alla media tra le unità con D=1, quindi
Una regressione con una variabile dummy di trattamento e un'intercetta riproduce esattamente la differenza tra medie campionarie. Se il trattamento è stato assegnato casualmente e non vi sono abbandoni o interferenze problematici, può stimare un effetto causale medio del trattamento. Se la dummy indica la frequenza universitaria scelta autonomamente, il coefficiente può riflettere differenze preesistenti nelle capacità o nel contesto familiare.
Cambiamenti di scala e forme funzionali
Un coefficiente dipende dalle unità di misura. Se X è misurato in migliaia di euro anziché in singoli euro, il suo coefficiente aumenta di un fattore mille, mentre i valori stimati e le implicazioni sostanziali rimangono invariati. Modificare la scala di Y moltiplica il coefficiente e i residui stimati per lo stesso fattore. Le trasformazioni devono sempre essere interpretate nelle unità economiche originarie.
Un modello livello–livello Y=β0+β1X+u ha β1 unità di Y per unità di X. Un modello log–livello log(Y)=β0+β1X+u comporta una variazione approssimata di Y del 100β1 per cento per un aumento unitario di X; l'effetto proporzionale esatto di una variazione unitaria è exp(β1)−1, secondo l'appropriata interpretazione sulla scala logaritmica. Nei modelli livello–log, il risultato cambia di circa β1/100 unità per una variazione dell'1% di X. Nei modelli log–log, β1 è l'elasticità di Y rispetto a X.
Perché una retta stimata non è il processo generatore dei dati
La regressione stima la relazione che meglio si adatta al campione. Anche se la media condizionata della popolazione è non lineare, la retta dei minimi quadrati della popolazione mantiene significato come migliore previsione lineare con perdita quadratica. Se Y è determinato da X2, un coefficiente angolare stimato può variare notevolmente al cambiare dell'intervallo osservato di X, nonostante il calcolo OLS sia tecnicamente corretto. La retta stimata è un'approssimazione; il ricercatore economico deve argomentare quando tale approssimazione sia utile e se abbia un significato causale accettabile.
La proiezione lineare della popolazione
Per comprendere l'OLS senza assumere un meccanismo economico effettivamente lineare, definiamo la proiezione lineare della popolazione come la scelta di α e β che minimizza E[(Y−α−βX)2]. Il suo coefficiente angolare è β=Cov(X,Y)/Var(X) quando tali momenti esistono e Var(X)>0. L'errore di proiezione e=Y−α−βX è ortogonale alla costante e a X: E[e]=0 ed E[Xe]=0. Tuttavia E[e|X]=0 può non valere se la vera aspettativa condizionata è non lineare. La differenza conta: l'ortogonalità campionaria è un risultato algebrico, mentre l'indipendenza in media condizionata è una proprietà più forte della distribuzione della popolazione.
Per un'aspettativa condizionata non lineare, la proiezione lineare è un compromesso ponderato tra i valori osservati di X. Il coefficiente angolare può essere un'utile sintesi dell'associazione lineare media e offrire un buon riferimento previsivo nell'intervallo delle covariate del campione, anche quando non dovrebbe essere interpretato come una derivata strutturale invariabile. Il ricercatore deve identificare il significato del coefficiente prima di attribuirgli un'interpretazione di politica economica.
Leverage, valori anomali e osservazioni influenti
Un'osservazione con un valore insolito del regressore può avere un leverage elevato, ossia un notevole potenziale di influenzare la retta stimata. Nell'OLS matriciale, il leverage hi è il corrispondente elemento diagonale di Px=X(X′X)-1X′. Residui grandi e leverage elevato sono proprietà distinte: un'osservazione può essere lontana dal centro delle variabili predittive ma trovarsi quasi esattamente sulla retta stimata; un'altra può avere un valore ordinario di X ma un Y inaspettatamente alto o basso.
Le misure di influenza combinano leverage e dimensione dei residui per valutare l'effetto della rimozione di osservazioni. Un dato sospetto potrebbe indicare un errore di codifica o misurazione, ma osservazioni rare e autentiche possono contenere informazioni economiche essenziali. Eliminare un punto soltanto perché indebolisce la significatività statistica compromette la credibilità empirica. Occorre riportare i cambiamenti rilevanti emersi dalle analisi di sensibilità e giustificare le esclusioni mediante regole difendibili sulla qualità dei dati.
5. Regressione multipla ed effetti parziali
Interpretazione ceteris paribus, struttura della regressione e multicollinearità
Perché è necessaria la regressione multipla
I risultati economici raramente rispondono a una sola determinante osservata. I lavoratori con maggiore istruzione tendono a differire anche per esperienza, settore, localizzazione e condizioni familiari. Una regressione dei salari sulla sola istruzione incorpora nello stesso coefficiente angolare tutte le dimensioni correlate con l'istruzione. La regressione multipla cerca di descrivere l'associazione tra salari e istruzione mantenendo costanti alcune altre caratteristiche selezionate. Scriviamo
Qui ogni βj descrive il cambiamento nel predittore lineare condizionato di Y associato a un aumento unitario di Xj, mantenendo costanti gli altri regressori. Questa espressione interpreta un confronto matematico condizionato; non garantisce che tale confronto sia realizzabile nella popolazione osservata o che βj rappresenti un effetto causale.
Per esempio, supponiamo che il reddito annuo da lavoro sia legato a istruzione, esperienza e settore. Il coefficiente dell'istruzione in questo modello si riferisce a lavoratori con uguale esperienza inclusa nel modello e uguale settore. Se le capacità non sono misurate e influenzano sia l'istruzione sia il reddito, il coefficiente dell'istruzione può comunque essere distorto. Aggiungere variabili non è sempre meglio: condizionare sui mediatori di un effetto o sui collider può creare nuove distorsioni anziché eliminare il confondimento.
Come l'OLS risolve il problema della regressione multipla
Lo stimatore OLS minimizza la somma dei quadrati dei residui rispetto a tutti i k+1 coefficienti. Con una matrice dei regressori X di dimensione n×(k+1), un vettore y di n elementi e un vettore dei coefficienti β, il modello e la funzione obiettivo dei minimi quadrati possono essere scritti come
Derivando si ottengono le equazioni normali X′Xβ̂=X′y. Se X ha rango pieno per colonne, la soluzione unica è
La matrice X′X rappresenta la variabilità e le correlazioni tra i regressori; X′y rappresenta la loro covariazione con Y. Il rango pieno per colonne esclude dipendenze lineari esatte e richiede un numero di righe almeno pari a quello dei parametri. Per avere gradi di libertà residui positivi occorre inoltre n>k+1; l’indipendenza statistica è un’ipotesi distinta sul campionamento. Il rango pieno non richiede che le variabili esplicative siano tra loro incorrelate: i coefficienti di regressori fortemente correlati sono stimabili, sebbene con minore precisione.
La matrice di proiezione Px = X(X′X)-1X′ soddisfa ŷ=Pxy, mentre i residui sono û=(I−Px)y. La proiezione rende il vettore dei residui ortogonale a ogni regressore incluso, X′û=0. Queste espressioni mostrano l'interpretazione geometrica dell'OLS come proiezione sullo spazio generato dalle colonne di X.
Il teorema di Frisch–Waugh–Lovell
Il teorema di Frisch–Waugh–Lovell (FWL) offre una procedura intuitiva per comprendere β̂1. Prima si regredisce X1 su tutte le altre variabili esplicative incluse e si conserva il residuo r1. Poi si regredisce Y sulle stesse altre variabili e si conserva il residuo rᵧ. Infine si regredisce rᵧ su r1 senza aggiungere un'intercetta. Il coefficiente angolare coincide con β̂1 della regressione multipla completa:
Il coefficiente utilizza la variazione di X1 che non può essere prevista linearmente dagli altri regressori. Se l'istruzione è prevista quasi perfettamente dall'età e dai controlli occupazionali, resta poca variazione indipendente per identificarne il coefficiente angolare. Il FWL spiega anche perché aggiungere controlli possa modificare una stima: viene ridefinita la variazione rilevante di X1, non soltanto il numero di gradi di libertà residui.
Per eliminare l'influenza lineare degli altri controlli, è matematicamente corretto ottenere i residui di Y e X1 rispetto a tali controlli. In generale non basta ottenere i residui della sola Y, perché il denominatore e la covarianza devono corrispondere alla variazione depurata di X1. La procedura che utilizza entrambi i residui offre uno strumento diagnostico pratico ed è particolarmente utile nei metodi che correggono per molte componenti accessorie ad alta dimensionalità.
La formula della distorsione da variabile omessa
Supponiamo che il vero modello condizionato includa sia X sia Z:
Se Z viene omessa, il coefficiente angolare della regressione semplice di Y su X nella popolazione soddisfa
Questa formula esatta della popolazione isola due elementi: la variabile omessa deve influenzare il risultato (β2≠0) ed essere correlata con il regressore incluso (Cov(X,Z)≠0). Il segno della distorsione è il prodotto di questi due segni. Se le capacità aumentano il reddito da lavoro e sono positivamente associate all'istruzione, ometterle tende a distorcere verso l'alto l'associazione osservata con l'istruzione, anche se il segno e la dimensione della distorsione effettiva dovuta alle capacità sono questioni empiriche.
La formula si generalizza alla regressione multipla: si sostituisce X con il suo residuo dopo la proiezione sugli altri controlli inclusi e si misura la covarianza tra questo residuo e la variabile omessa. Una variabile non correlata con il regressore una volta considerati i controlli appropriati non può generare la consueta distorsione da variabile omessa nel suo coefficiente, anche se quella variabile omessa è importante per spiegare Y.
La trappola delle variabili dummy e i regressori qualitativi
Le variabili dummy codificano una caratteristica categoriale. Un modello con intercetta e tre categorie settoriali mutuamente esclusive include normalmente soltanto due dummy, lasciando la terza come categoria di riferimento. Includerle tutte e tre crea multicollinearità esatta perché l'intercetta è la somma dei tre indicatori. La categoria di riferimento omessa non viene ignorata: è rappresentata dall'intercetta e i coefficienti delle dummy incluse confrontano i gruppi con quel gruppo di riferimento, condizionatamente agli altri regressori.
Cambiare la categoria di riferimento modifica i coefficienti delle dummy riportati, ma non i valori stimati. Per una variabile categoriale con più livelli, riportare i risultati medi stimati o confronti espliciti tra coppie di gruppi può essere più informativo che interpretare singolarmente coefficienti riferiti a una categoria base arbitraria.
Multicollinearità e precisione
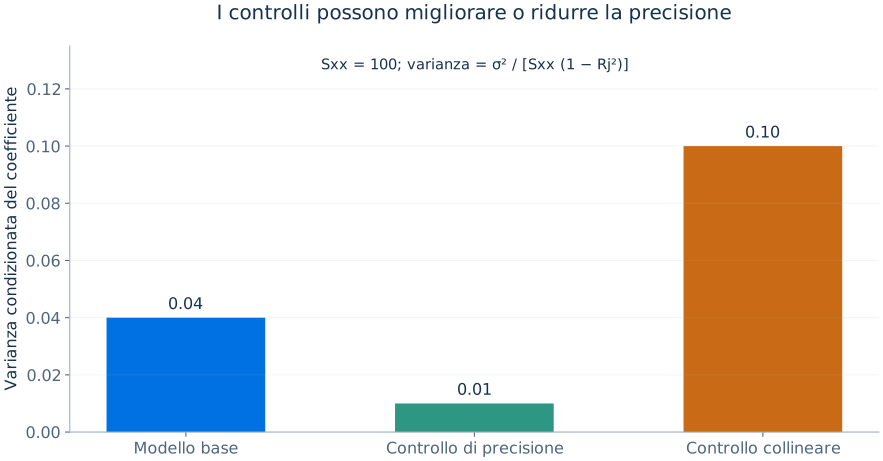
La multicollinearità imperfetta significa che i regressori sono fortemente, ma non perfettamente, legati tra loro. I coefficienti OLS restano calcolabili, ma la loro varianza aumenta perché la variazione residua di uno specifico regressore è limitata. In presenza di omoschedasticità,
dove Rj2 si ottiene regredendo Xj sugli altri regressori. Il fattore di inflazione della varianza VIFj=1/(1−Rj2) riassume l'aumento rispetto al caso di regressori ortogonali. Un VIF elevato segnala minore precisione, non automaticamente distorsione o necessità di eliminare controlli economicamente indispensabili. L'appropriatezza di una variabile deve essere valutata sulla base del disegno di ricerca.
Scala, standardizzazione e interpretazione
La standardizzazione sostituisce un regressore osservato con il suo scarto dalla media campionaria diviso per la propria deviazione standard campionaria. Se sono standardizzati sia Y sia Xj, la pendenza esprime la variazione dell’esito in deviazioni standard associata a un aumento di una deviazione standard di Xj, mantenendo fissi gli altri regressori. Standardizzando soltanto Xj, il coefficiente rimane espresso nelle unità originali di Y per una deviazione standard di Xj. Questi coefficienti possono facilitare il confronto delle associazioni, ma non devono sostituire gli effetti espressi in unità economicamente significative. Il cambiamento di scala e il centramento modificano le intercette e, in presenza di interazioni, alcuni coefficienti di pendenza; non creano identificazione.
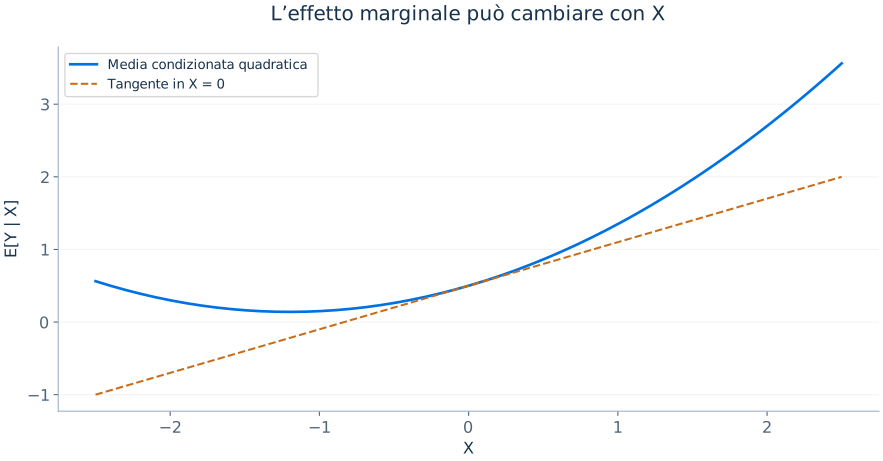
Consideriamo il modello stimato log(wage)=β0+β1educ+β2exper+β3exper2+u. L'effetto percentuale previsto di un ulteriore anno di istruzione è approssimativamente 100β1%, mentre la variazione marginale del logaritmo dei salari rispetto all'esperienza è β2+2β3exper e varia con l'esperienza. Riportare il solo β2 come effetto marginale costante è scorretto.
Confondimento, controlli per la precisione e controlli inappropriati
Una distinzione utile separa i controlli che proteggono l'identificazione causale dalle variabili che migliorano principalmente la precisione. Una variabile precedente al trattamento e legata sia al trattamento sia al risultato può ridurre il confondimento quando l'ipotesi di indipendenza condizionata è plausibile. Una variabile iniziale fortemente predittiva del risultato, ma non legata al trattamento casuale, può ridurre la varianza residua e quindi migliorare la precisione. Una variabile successiva al trattamento può invece eliminare parte dell'effetto stesso di interesse e non deve essere inclusa automaticamente. Una buona modellizzazione sceglie i controlli in base alla sequenza temporale economica, alle istituzioni e alla logica causale, anziché applicare una regola universale di inclusione di tutte le variabili.
Per esempio, supponiamo che l'istruzione influenzi l'occupazione, che a sua volta influenza i salari. Quando si cerca l'effetto totale dell'istruzione, controllare per l'occupazione può bloccare un importante percorso causale e produrre un estimando diverso. Se l'occupazione è influenzata anche da fattori non misurati che incidono sui salari, il condizionamento può creare ulteriore distorsione. Un ricercatore interessato all'effetto diretto dell'istruzione non mediato dall'occupazione necessita di un estimando alternativo e di ipotesi più forti, non di una reinterpretazione disinvolta dello stesso coefficiente di regressione.
Interpretare una tabella completa di regressione
Una tabella di regressione interpretata con attenzione riporta le unità dei coefficienti, le variabili esplicative, la numerosità campionaria, R2 o una misura comparabile dell'adattamento, gli eventuali effetti fissi e un'indicazione chiara del metodo per gli errori standard. Quando un coefficiente cambia dopo l'aggiunta di controlli, rimangono possibili diverse spiegazioni: confondimento omesso nella specificazione precedente, cambiamenti nel campione analizzato dovuti a valori mancanti nelle variabili di controllo, modifica della ponderazione implicita nella regressione, interazioni o specificazione funzionale errata. Per isolare l'effetto dei controlli, è opportuno confrontare le specificazioni sullo stesso campione di stima ogni volta che sia possibile.
Il coefficiente di una politica può rimanere quasi costante quando si aggiungono controlli, ma la sola stabilità del coefficiente non verifica l'esogeneità: tutti i modelli potrebbero omettere lo stesso fattore confondente non osservato. Viceversa, i cambiamenti tra specificazioni ben giustificate dovrebbero indurre un approfondimento sostanziale, anziché la selezione meccanica del coefficiente con il p-value più basso.
6. Non linearità, logaritmi e interazioni
Medie condizionate flessibili con coefficienti che restano interpretabili
Linearità nei parametri e linearità nei regressori
La formula classica dei minimi quadrati stima modelli lineari nei coefficienti incogniti, non necessariamente lineari nelle variabili originarie dei dati. Un modello con X2, log(X), un'interazione del trattamento o indicatori annuali rimane lineare nei parametri se questi regressori trasformati entrano in modo additivo con coefficienti lineari. Viceversa, Y=exp(β0+β1X)+u è non lineare nei parametri e non può essere stimato nella forma scritta mediante i normali minimi quadrati lineari senza modificare il modello e le ipotesi sugli errori.
Le scelte di forma funzionale impongono affermazioni sostanziali sugli effetti marginali. Aggiungere un polinomio non è un espediente puramente estetico: significa ammettere che la relazione possa curvarsi in modo sistematico. Utilizzare i logaritmi può creare un'interpretazione in termini di effetti proporzionali, gestire una forte asimmetria ed esprimere elasticità economiche. Il modello deve comunque essere verificato rispetto alla plausibilità delle previsioni, alle osservazioni influenti e alle nuove restrizioni imposte dalla trasformazione scelta.
I principali modelli logaritmici
Per Y e X positive, sono utili quattro forme comuni. Livello–livello: Y=β0+β1X+u presenta una variazione marginale costante di Y pari a β1 unità. Log–livello: ln(Y)=β0+β1X+u presenta una variazione approssimata di Y del 100β1 per cento per unità di X. Livello–log: Y=β0+β1ln(X)+u presenta una variazione approssimata di Y pari a β1/100 unità per un aumento dell'1% di X. Log–log: ln(Y)=β0+β1ln(X)+u ha elasticità costante β1, per cui un aumento dell'1% di X corrisponde a una differenza di Y approssimativamente pari a β1%.
| Forma | Specificazione | Significato del coefficiente |
|---|---|---|
| Livello–livello | Y = β0 + β1X + u | Unità di Y per unità di X |
| Log–livello | ln Y = β0 + β1X + u | ≈ 100β1 % di Y per unità di X |
| Livello–log | Y = β0 + β1ln X + u | ≈ β1/100 unità di Y per 1% di X |
| Log–log | ln Y = β0 + β1ln X + u | Elasticità esatta del predittore logaritmico esponenziato: β1 |
Quando la variabile dipendente è espressa in logaritmi, esponenziare la media condizionata stimata di ln(Y) non riproduce generalmente E[Y|X]. La disuguaglianza di Jensen implica che E[exp(log Y)|X] non sia semplicemente exp(E[log Y|X]). Le previsioni nelle unità originarie possono richiedere una correzione di ritrasformazione o di smearing, soprattutto in presenza di residui logaritmici eteroschedastici.
Termini quadratici e di ordine superiore
Una specificazione quadratica è
Il suo effetto marginale è β1+2β2X. Se β2<0, la funzione è concava e un β1 positivo può infine tradursi in un effetto marginale negativo. Il punto di inversione è X*=−β1/(2β2), se β2≠0. Prima di interpretarlo economicamente, occorre indicare se questo punto ricade nell'intervallo dei dati osservati. Polinomi di grado arbitrariamente elevato possono adattarsi eccessivamente al campione, oscillare bruscamente vicino ai limiti e offrire estrapolazioni poco attendibili.
Interazioni tra due regressori continui
Sia E[Y|X,Z]=β0+β1X+β2Z+β3XZ. Mantenendo Z costante, l'effetto marginale di X è
Il coefficiente di X descrive il suo effetto per Z=0, che potrebbe trovarsi fuori dall'intervallo di interesse sostanziale. Centrare Z attorno alla sua media fa sì che β1 si riferisca al livello medio osservato di Z, migliorandone l'interpretabilità. Il coefficiente dell'interazione misura come cambia l'effetto marginale di X per un aumento unitario di Z; la sua incertezza campionaria e la covarianza tra le stime contano nel calcolo degli errori standard di uno specifico effetto marginale.
Interazioni binaria × continua e binaria × binaria
Il modello E[Y|D,X]=β0+β1D+β2X+β3(DX) permette coefficienti angolari diversi nel gruppo trattato e in quello non trattato. Per D=0 il coefficiente angolare rispetto a X è β2; per D=1 è β2+β3. Il confronto tra trattamento e controllo per X=x è β1+β3x, non semplicemente β1. L'errore standard di questo confronto utilizza Var(β̂1)+x2Var(β̂3)+2xCov(β̂1,β̂3).
Con due variabili binarie A e B, aggiungere A×B permette al gruppo che possiede entrambe le caratteristiche di differire dalla somma dei loro effetti principali separati. In un modello con due indicatori binari e tutte le interazioni, le medie stimate coincidono con le quattro medie specifiche dei gruppi. Questo è un esempio di modello lineare saturo. La stessa algebra è alla base della più semplice specificazione delle differenze nelle differenze discussa nel capitolo sui dati panel.
Regressione flessibile e interpretazione parziale
Un modello statistico può approssimare in modo flessibile la media condizionata senza identificare un meccanismo causale. Aggiungere molte trasformazioni non elimina i fattori confondenti omessi o l'endogeneità. Una regressione non lineare stimata richiede inoltre di valutare l'effetto marginale rilevante in corrispondenza di valori economicamente appropriati, accompagnandolo con intervalli di incertezza, anziché dichiarare che il coefficiente del termine originario rappresenti l'intero effetto.
La formula multivariata dell'effetto marginale
Per una media condizionata regolare m(x)=E[Y|X=x], l'effetto marginale di Xj è ∂m(x)/∂xj. Per un trattamento discreto o binario, le derivate possono essere inappropriate; è invece opportuno calcolare la variazione del risultato previsto tra gli stati del trattamento, mantenendo costanti le altre covariate. Gli effetti marginali medi sono la media degli effetti parziali specifici delle singole unità nel campione osservato; gli effetti marginali in corrispondenza della media valutano una funzione non lineare in un particolare vettore artificiale di covariate. Queste quantità differiscono perché, in generale, applicare una funzione non lineare e calcolare una media non sono operazioni intercambiabili.
Se m(X)=β0+β1X+β2X2, la derivata β1+2β2X è specifica dell'individuo. In questo caso quadratico l'effetto marginale medio è β1+2β2X̄, ma funzioni più complesse possono richiedere di calcolare gli effetti per tutte le osservazioni e poi farne la media. Quando i modelli contengono più covariate interagite, occorre indicare esattamente quali vengano mantenute costanti e in quale punto sia valutata la derivata.
Inferenza per punti di inversione ed elasticità
Il punto di inversione di una funzione quadratica, X*=−β1/(2β2), è un rapporto tra coefficienti stimati. Se β2 è stimato con scarsa precisione vicino a zero, questo rapporto può avere una distribuzione fortemente asimmetrica; il metodo delta standard può risultare inaffidabile. Un grafico della funzione stimata con bande di confidenza spesso comunica l'incertezza in modo più responsabile rispetto a un singolo valore del punto di inversione. Per un effetto previsto L(β̂) che coinvolge più coefficienti, occorre incorporare l'intera matrice di covarianza stimata.
Consideriamo un modello log–log con coefficiente angolare stimato pari a 0.75 ed errore standard robusto 0.12. Un semplice intervallo al 95% per l'elasticità è approssimativamente 0.75±1.96(0.12), ossia (0.515,0.985). Questo intervallo caratterizza l'incertezza campionaria del coefficiente nell'ambito del modello, non stabilisce se una variazione di prezzo indotta da una politica abbia lo stesso effetto di un'associazione storica di mercato.
Dalle previsioni logaritmiche agli esiti nelle unità originali
Un modello stimato in logaritmi descrive m(x)=E[ln(Y)|X=x]. Il suo esponenziale exp(m(x)) è una media geometrica condizionale ed è una mediana condizionale quando il disturbo logaritmico ha mediana condizionale zero. Per ottenere la media aritmetica condizionale, si scrive Y=exp(m(X))exp(u) e si calcola la media del secondo fattore condizionatamente a X. La correzione risultante può variare con i valori delle covariate; la sola esponenziazione generalmente sottostima la media condizionale.
Se u condizionatamente a X è normale con varianza costante σ2, la correzione è exp(σ2/2). Con una distribuzione dell’errore costante, ma senza normalità, una stima mediante smearing usa la media campionaria di exp(ûi). Un unico fattore globale di smearing è generalmente insufficiente quando la distribuzione di u varia con X. Per esempio, se m(x)=2 e σ2=0,25, exp(2) è circa 7,39, mentre la media condizionale è exp(2,125), circa 8,37. Nei confronti moltiplicativi tra due valori delle covariate, la correzione si semplifica soltanto se è identica nei due casi.
Esiti binari: probabilità lineare, logit e probit
Per un esito binario, la media condizionale è una probabilità. Un modello di probabilità lineare usa p(x)=x′β e interpreta un coefficiente di 0,04 come una variazione di quattro punti percentuali, mantenendo fissi gli altri regressori. Il modello è semplice, ma può prevedere valori inferiori a zero o superiori a uno e la sua varianza dell’errore p(x)[1−p(x)] è generalmente eterogenea.
Il logit usa la funzione di distribuzione logistica Λ e il probit usa la funzione di distribuzione normale standard Φ. Entrambi mantengono le probabilità stimate tra zero e uno. Con osservazioni indipendenti, la massima verosimiglianza sceglie i coefficienti che massimizzano la log-verosimiglianza di Bernoulli riportata sotto, dove pi è la probabilità stimata e yi è zero oppure uno. Un coefficiente logit descrive una variazione del logaritmo degli odds, non una variazione in punti percentuali. Per un regressore continuo non trasformato e privo di interazioni, l’effetto marginale sulla probabilità è βjpi(1−pi); l’analogo probit è βjφ(xi′β), dove φ è la densità normale standard. Per i regressori binari, si confrontano le probabilità previste impostando il regressore a zero e a uno, calcolando la media delle differenze se l’oggetto della stima è un effetto medio. Anche questi modelli richiedono un’argomentazione credibile di identificazione per sostenere conclusioni causali.
| Modello | Funzione di probabilità | Interpretazione principale |
|---|---|---|
| Probabilità lineare | x′β | Pendenza in unità di probabilità; usare una matrice di covarianza robusta appropriata |
| Logit | Λ(x′β) | Pendenza nel logaritmo degli odds; calcolare differenze di probabilità |
| Probit | Φ(x′β) | Pendenza nell’indice normale; calcolare differenze di probabilità |
7. Teoria OLS nei campioni finiti
Non distorsione, varianze condizionate, Gauss–Markov e inferenza sotto normalità
Le domande della teoria dei campioni finiti
La teoria dei campioni finiti caratterizza gli stimatori per un dato n, sotto ipotesi formulate con precisione. Si distingue dalla teoria asintotica, che studia successioni di campioni di dimensione crescente. Nel consueto modello di regressione multipla y=Xβ+u, le affermazioni esatte sono spesso condizionate alla matrice osservata X. Questo consente di separare le proprietà stocastiche del termine di disturbo dalla variazione effettivamente osservata nei regressori.
Le ipotesi fondamentali sono un modello lineare nei coefficienti, un meccanismo di campionamento con adeguate condizioni di indipendenza, l'assenza di multicollinearità perfetta e una media condizionata nulla E[u|X]=0. Quest'ultima ipotesi è decisiva per la non distorsione di OLS; né l'omoschedasticità né la distribuzione normale dei disturbi sono necessarie per questa proprietà. Tuttavia, la sola media non condizionata nulla E[u]=0 non è sufficiente, perché l'errore potrebbe variare sistematicamente con i regressori.
Derivazione della non distorsione condizionata
Sostituendo y=Xβ+u nella formula OLS si ottiene
Se X ha rango pieno per colonne ed E[u|X]=0, l'aspettativa condizionata fornisce immediatamente E[β̂|X]=β. Applicando nuovamente l'aspettativa si dimostra E[β̂]=β. Questa dimostrazione è utile perché mostra esattamente dove interviene l'esogeneità: se E[u|X]≠0, OLS contiene generalmente una componente sistematica dipendente dai regressori. Il semplice fatto di stimare una regressione non dimostra l'ipotesi utilizzata per giustificarne il risultato.
L'ipotesi sull'aspettativa condizionata può non essere soddisfatta quando variabili omesse sono correlate con le variabili esplicative, quando gli agenti economici determinano congiuntamente le variabili esplicative e la variabile risultato oppure quando un regressore è misurato con errore sistematico. La regressione può comunque calcolare il coefficiente, ma il suo valore atteso non deve necessariamente coincidere con il parametro strutturale di interesse.
Matrice di covarianza condizionata di OLS
Indichiamo con Ω=Var(u|X) la matrice di covarianza condizionata del vettore dei disturbi. La sostituzione diretta fornisce
In presenza di omoschedasticità condizionata e assenza di correlazione tra unità, Ω=σ2I; l'espressione diventa
La consueta stima della varianza dell'errore è s2=RSS/(n−k−1), quando il modello contiene k regressori esplicativi e un'intercetta. Il denominatore tiene conto del numero di parametri stimati. Sotto le ipotesi condizionate classiche, questo è uno stimatore non distorto di σ2. I consueti errori standard sono le radici quadrate degli elementi sulla diagonale di s2(X′X)-1.
Se la varianza dell'errore differisce tra osservazioni, questi errori standard convenzionali possono essere inconsistenti anche quando la media condizionata nulla garantisce la non distorsione di OLS. Gli stimatori robusti vengono trattati separatamente, perché modificare il calcolo della varianza non modifica il coefficiente angolare stimato.
Il teorema di Gauss–Markov
Sotto le ipotesi di modello lineare, rango pieno, esogeneità ed errori sferici (disturbi omoschedastici e incorrelati), OLS è il miglior stimatore lineare non distorto (BLUE). «Migliore» significa che ha la matrice di covarianza condizionata più piccola tra gli stimatori lineari non distorti per ogni valore di β previsto dal modello; non significa che OLS abbia la varianza minima tra tutti gli immaginabili stimatori non lineari o distorti, né richiede che i disturbi abbiano distribuzione normale.
Per comprenderne l'intuizione, consideriamo un qualsiasi altro stimatore non distorto e lineare in y: β̃=Ay. Poiché la non distorsione richiede AX=I, scriviamo A=(X′X)-1X′+C con CX=0. Sotto Ω=σ2I, la differenza tra le matrici di covarianza dei due stimatori è
Poiché CC′ è semidefinita positiva, nessuno stimatore concorrente lineare e non distorto migliora OLS nell'ordinamento basato sulla semidefinitezza positiva. La dimostrazione individua esattamente le ipotesi che garantiscono l'efficienza e chiarisce perché questa possa venir meno in presenza di eteroschedasticità o autocorrelazione.
Distribuzioni campionarie con disturbi normali
Se u|X ha distribuzione normale congiunta N(0,σ2I), allora β̂|X è normale con media β e covarianza σ2(X′X)-1. In questo modello normale classico, ciascuna statistica t basata su una varianza opportunamente stimata ha una distribuzione t di Student esatta con n−k−1 gradi di libertà. Per q restrizioni lineari, un rapporto opportunamente costruito tra le somme dei quadrati del modello vincolato e di quello non vincolato segue una distribuzione F esatta con q e n−k−1 gradi di libertà.
In assenza dell'ipotesi di normalità, OLS può rimanere non distorto e BLUE, mentre le distribuzioni di riferimento convenzionali t e F per i campioni finiti non sono più esatte. I ricercatori si affidano allora comunemente a risultati asintotici ed errori standard robusti oppure a procedure di ricampionamento accuratamente giustificate.
Eteroschedasticità e conseguenze nei campioni finiti
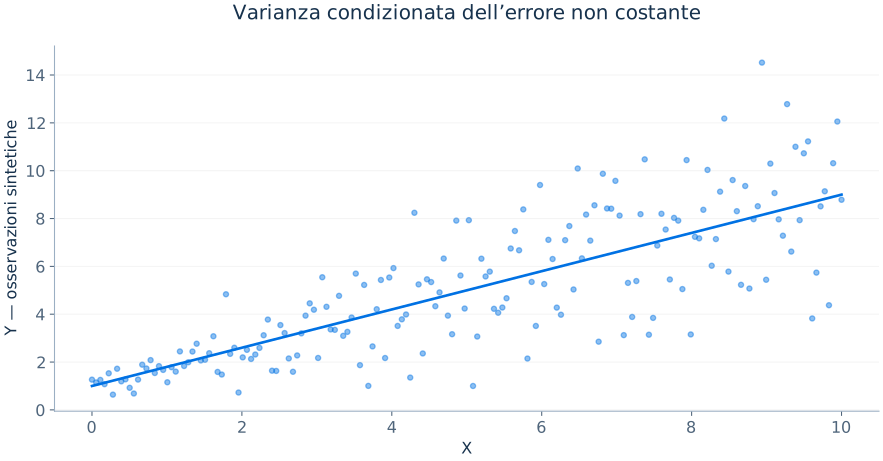
L'eteroschedasticità significa che Var(ui|Xi) cambia al variare dei regressori o di altre informazioni. Se E[ui|Xi]=0 rimane valida, la non distorsione dei coefficienti può conservarsi; la semplificazione convenzionale della varianza generalmente no. I test di omoschedasticità possono talvolta descrivere l'andamento della varianza, ma non sono necessari per giustificare l'impiego di stime della covarianza robuste all'eteroschedasticità. Gli errori standard robusti devono comunque fondarsi su una corretta struttura di indipendenza, raggruppamento o dipendenza.
Le ipotesi di Gauss–Markov in un linguaggio economico semplice
L'ipotesi di linearità riguarda la parametrizzazione della media condizionata del risultato, non l'assenza di trasformazioni non lineari delle variabili osservate. Il campionamento casuale descrive il modo in cui le unità economiche entrano nel dataset. L'assenza di collinearità perfetta richiede una variazione nei regressori che non possa essere rappresentata esattamente dagli altri regressori inclusi. La media condizionata nulla afferma che le determinanti escluse non cambiano sistematicamente con i regressori inclusi. L'omoschedasticità afferma che, condizionatamente ai regressori, la varianza non spiegata del risultato è costante; l'assenza di correlazione seriale richiede che disturbi distinti siano incorrelati. Ciascuna ipotesi deve essere valutata nel contesto del processo che ha generato i dati.
L'affermazione di Gauss–Markov riguarda una specifica classe di riferimento di stimatori; non è un'affermazione universale secondo cui OLS semplice domina ogni alternativa. Con una matrice di covarianza non sferica Ω nota, lo stimatore dei minimi quadrati generalizzati β̂ᴳᴸˢ=(X′Ω-1X)-1X′Ω-1y può essere più efficiente quando modello e covarianza sono specificati correttamente. I GLS fattibili stimano Ω dai dati e introducono quindi ulteriori ipotesi campionarie e una potenziale sensibilità agli errori di specificazione del modello della covarianza.
L'omoschedasticità come caso particolare
Per una variabile risultato binaria Y che assume valori zero e uno, E[Y|X]=p(X) e Var(Y|X)=p(X)(1−p(X)). A meno che p(X) sia costante o assuma valori particolari, questa varianza condizionata cambia con X. Un modello lineare di probabilità presenta quindi naturalmente eteroschedasticità anche quando la relazione media è approssimata correttamente. È un chiaro esempio del motivo per cui gli errori standard robusti non costituiscono un rimedio oscuro a rare patologie statistiche: l'eteroschedasticità deriva spesso direttamente dalla struttura dei dati economici.
Minimi quadrati ponderati e significato dei pesi
Quando la varianza condizionale è nota essere proporzionale a una funzione positiva hi, dividere l’intera equazione di ciascuna osservazione, intercetta compresa, per √hi rende omoschedastico il disturbo trasformato. I minimi quadrati ponderati minimizzano quindi i residui quadratici con pesi wi=1/hi. Un’osservazione più rumorosa riceve un peso minore perché fornisce meno informazione su un coefficiente comune della media condizionale. W è la matrice diagonale di questi pesi positivi.
Pesi di varianza corretti possono migliorare l’efficienza sotto l’ipotesi mantenuta di media condizionale nulla. Pesi stimati danno luogo a WLS fattibili e richiedono di verificare la specificazione della varianza; quando questa può essere errata, si usa uno stimatore di covarianza adeguato alle equazioni di stima trasformate. I pesi di precisione sono diversi dai pesi di campionamento delle indagini o dai pesi inversi della propensione, che riguardano la rappresentatività della popolazione o i confronti causali. In R, lm(y ~ x, weights = w, data = dat) richiede pesi inversamente proporzionali alla varianza per questa interpretazione di precisione. Quando la media lineare è soltanto un’approssimazione, la ponderazione può cambiare la proiezione nella popolazione che si sta stimando: una variazione dei coefficienti non dimostra automaticamente un miglioramento dell’identificazione causale.
8. Analisi della varianza e adattamento del modello
ANOVA, R-quadrato, diagnostica dei residui e accuratezza predittiva
Ortogonalità e scomposizione delle somme dei quadrati
OLS separa i risultati osservati in valori stimati e residui: Yi=Ŷi+ûi. In presenza di un'intercetta, l'ortogonalità campionaria implica che la somma totale degli scarti quadratici da Ȳ sia uguale alla somma degli scarti quadratici dei valori stimati e dei residui quadratici:
Dividendo per TSS si ottiene R2=ESS/TSS=1−RSS/TSS. Un valore vicino a uno significa che i predittori lineari spiegano gran parte della variazione campionaria di Y intorno alla sua media campionaria. Non dimostra l'esistenza di un effetto causale stimato senza distorsione; trend temporali, shock comuni e variabili legate meccanicamente possono generare valori molto elevati di R2 senza un'interpretazione strutturale credibile.
Il significato dell'R-quadrato corretto
L'aggiunta di un regressore non può aumentare la RSS nel campione quando si ricalcola OLS, perciò l'R2 ordinario non diminuisce mai nei modelli annidati. L'R2 corretto penalizza il numero di parametri stimati:
Il valore corretto può diminuire quando la variabile aggiunta migliora solo lievemente l'adattamento. Non è una stima non distorta della qualità predittiva fuori campione e non è una regola di selezione causale delle variabili. Il confronto tra modelli che usano trasformazioni diverse della variabile dipendente richiede particolare cautela: i valori di R2 per Y e ln(Y) non sono misure di adattamento direttamente confrontabili sulla medesima scala del risultato.
Errore standard della regressione ed errori di previsione
L'errore standard dei residui è SER=√(RSS/(n−k−1)). Sotto le ipotesi pertinenti, stima l'ampiezza degli errori nelle unità di Y. Un'applicazione predittiva si interessa all'errore su dati non utilizzati per stimare il modello. Se il modello stimato viene valutato su un campione di validazione indipendente, una misura comune della performance è l'errore quadratico medio di previsione:
La radice del MSPE ha le unità della variabile prevista ed è più interpretabile degli errori quadratici grezzi. Nelle previsioni temporali, le osservazioni di validazione devono essere successive a quelle di addestramento; rimescolare casualmente una serie temporale può introdurre informazioni future nel processo di costruzione del modello.
Grafici dei residui e controlli di specificazione
I grafici dei residui rispetto ai valori stimati, a ciascun regressore, al tempo e agli indicatori di gruppo possono rivelare valori anomali, eteroschedasticità, non linearità e andamenti seriali. Una nuvola di residui che si allarga a ventaglio suggerisce un modello della varianza dipendente da X. Un andamento curvilineo dei residui suggerisce l'omissione di termini non lineari. Sequenze di residui positivi e negativi nei dati di serie storiche suggeriscono una specificazione dinamica errata o disturbi correlati.
Tuttavia, i residui OLS sono ortogonali ai regressori inclusi per costruzione. Una covarianza campionaria nulla tra residui e regressori non convalida quindi l'ipotesi di media condizionata nulla. I test di specificazione sono strumenti diagnostici utili, ma non possono da soli identificare controfattuali non osservati o dimostrare l'esogeneità.
Sovraadattamento e validazione fuori campione
Quando il numero di regressori diventa elevato rispetto al numero di osservazioni, l'adattamento nel campione può migliorare anche se il modello perde affidabilità predittiva. Con n parametri e n osservazioni, può essere possibile interpolare perfettamente il dataset senza offrire alcuna garanzia attendibile fuori campione. La validazione incrociata, i campioni di test indipendenti e la regolarizzazione mirano alla performance predittiva, anziché alla sola RSS sui dati utilizzati per la stima.
| Statistica | Che cosa misura | Che cosa non dimostra |
|---|---|---|
| R2 | Variazione nel campione spiegata dalla proiezione | Identificazione causale |
| R2 corretto | Adattamento penalizzato per la dimensione del modello | Migliore previsione su nuovi dati |
| SER | Ampiezza dei residui nelle unità del risultato | Assenza di distorsione da specificazione |
| RMSE fuori campione | Errore di previsione tipico nelle unità del risultato | Effetto strutturale |
| Statistica t | Segnale in rapporto a un determinato errore standard | Rilevanza economica |
La varianza nell'output di regressione
I software statistici riportano spesso una tabella di analisi della varianza con la somma dei quadrati del modello, la somma dei quadrati dei residui, i rispettivi gradi di libertà e le corrispondenti medie quadratiche. Quando tutte le ipotesi convenzionali di omoschedasticità sono soddisfatte, il rapporto tra la media quadratica del modello e quella dei residui può fornire un test F complessivo. In presenza di eteroschedasticità, un test di Wald robusto dovrebbe sostituire il confronto convenzionale delle somme dei quadrati per le ipotesi congiunte generali.
Adattamento campionario, validità causale e precisione spuria
Tre modelli possono riportare valori identici di R2 pur offrendo informazioni molto diverse. Una regressione con trattamento randomizzato e R2 basso può identificare un effetto credibile di una politica, perché il trattamento può spiegare soltanto una piccola parte della variazione individuale del risultato. Un modello predittivo ad alta dimensionalità con elevata accuratezza in validazione incrociata può fornire previsioni eccellenti senza identificare alcun intervento causale. Una regressione di serie storiche con trend tra variabili integrate non correlate può avere un R2 estremamente alto mentre l'inferenza standard basata sulla t è invalida. Valutare questi modelli con un'unica statistica di adattamento significa confondere categorie concettualmente diverse.
Scomposizione dei contributi esplicativi
Nella regressione multipla, i contributi esplicativi di regressori correlati non possono sempre essere separati in modo univoco. Se istruzione e reddito dei genitori sono correlati, l'attribuzione della variazione salariale spiegata a ciascuna variabile dipende dalla procedura di scomposizione o dall'ordine di inclusione. Un R2 parziale per un gruppo selezionato di regressori ne misura il miglioramento incrementale dell'adattamento condizionatamente ai regressori rimanenti; non va interpretato come una quota causale univoca del risultato.
L'R2 parziale può essere definito attraverso le somme dei quadrati dei residui dei modelli vincolato e non vincolato: R2partial=(RSSrestricted−RSSunrestricted)/RSSrestricted. Il numeratore misura il miglioramento dell'adattamento dovuto all'aggiunta dei regressori selezionati, mentre il denominatore è la variazione non spiegata nel modello vincolato. Può essere utile per valutare una relazione condizionata o un primo stadio, ma non convalida la restrizione di esclusione di uno strumento.
Intervalli di confidenza per una media e intervalli di previsione per un individuo
Un intervallo per la media condizionale indica con quale precisione è stata stimata la media di Y in x0. Un intervallo di previsione riguarda invece i valori plausibili di un nuovo esito individuale Y0. Il secondo include sia l’incertezza sulla media stimata sia il disturbo irriducibile della nuova osservazione, risultando quindi più ampio a parità di modello. Qui x0 comprende l’intercetta, s2 è la stima convenzionale della varianza residua, p è il numero totale dei coefficienti stimati e h0=x0′(X′X)-1x0.
Sotto un modello lineare normale omoschedastico correttamente specificato e con una nuova osservazione indipendente, i due intervalli usano le formule riportate sotto. L’1 aggiuntivo nella radice quadrata dell’intervallo di previsione rappresenta la varianza del nuovo disturbo in unità di s2. Anche con un campione di stima enorme, questa incertezza non scompare. La leva statistica amplia entrambi gli intervalli quando ci si allontana dai valori delle covariate ben supportati dai dati. In R, predict.lm distingue interval="confidence" da interval="prediction". I soli errori standard robusti dei coefficienti non costruiscono un intervallo di previsione valido in presenza di eteroschedasticità: occorre considerare anche la distribuzione condizionale del nuovo esito.
9. Test di ipotesi nella regressione
Test t, intervalli di confidenza, test F, test di Wald e restrizioni congiunte
Un approccio generale ai test di ipotesi
Il test parte da un'ipotesi riferita alla popolazione. L'ipotesi nulla può affermare che l'istruzione non abbia alcuna associazione condizionata con i salari, che una politica non influenzi né l'occupazione né gli investimenti oppure che due gruppi abbiano lo stesso coefficiente angolare di regressione. L'ipotesi deve essere formulata prima di interpretare i risultati, così da scegliere adeguatamente il numero di restrizioni, gli stimatori pertinenti e la distribuzione di riferimento.
Per un singolo coefficiente lineare, H0: βj=βj,0, la consueta statistica test è
Quando l'errore standard stima in modo consistente l'incertezza campionaria, nei grandi campioni t è spesso approssimativamente N(0,1) sotto l'ipotesi nulla. L'inferenza t di Student esatta richiede inoltre le pertinenti ipotesi di normalità e del modello lineare classico. Il p-value misura quanto sarebbe sorprendente la statistica osservata se l'ipotesi nulla e le sue ipotesi campionarie fossero vere.
Intervalli di confidenza e legame con i test bilaterali
Un intervallo approssimato al 100(1−α)% per βj è β̂j ± z1₋α/2 SE(β̂j). Al livello del 5%, il test bilaterale H0:βj=0 rifiuta esattamente quando lo zero è esterno al corrispondente intervallo bilaterale al 95%, purché entrambi utilizzino lo stesso errore standard e la stessa distribuzione per i valori critici. L'intervallo mostra l'insieme dei valori del parametro non rifiutati dalla procedura corrispondente e fornisce più informazioni sulle possibili dimensioni economiche dell'effetto rispetto a una semplice distinzione significativo/non significativo.
Restrizioni congiunte e insufficienza di test t separati
Un modello può contenere un polinomio quadratico o un insieme di indicatori settoriali il cui effetto congiunto è di interesse. Testare ciascun coefficiente singolarmente al 5% non equivale a testare l'insieme delle restrizioni nulle con un livello del 5% per l'intera famiglia. L'appropriata ipotesi nulla congiunta può essere scritta come
dove R è una matrice q×(k+1) che identifica le q restrizioni e r è un vettore di q valori ipotizzati. Una statistica di Wald generale misura quanto Rβ̂ sia distante da r rispetto alla covarianza congiunta delle stime:
Per i test asintotici, W converge a una distribuzione χ2 con q gradi di libertà quando vale l'ipotesi nulla e sono soddisfatte adeguate condizioni di regolarità. Molti pacchetti riportano F=W/q e utilizzano una distribuzione di riferimento appropriata. Quando non è giustificata una varianza costante dell'errore, si dovrebbe usare una V̂ robusta all'eteroschedasticità.
Il test F tra modello vincolato e non vincolato
Nel modello classico normale e omoschedastico, si può confrontare una regressione vincolata che soddisfa l'ipotesi nulla con una regressione non vincolata che include tutti i parametri. La statistica F parziale standard è
I vincoli non possono ridurre il valore minimo di RSS, quindi RSSr≥RSSu. Il numeratore misura il peggioramento dell’adattamento per ciascun vincolo imposto; il denominatore stima la varianza del disturbo a partire dal modello non vincolato. Sotto l’ipotesi nulla e le ipotesi classiche di normalità ed errori sferici, F segue una distribuzione F centrale con q e n−k−1 gradi di libertà. Se un vincolo è falso, la distribuzione è generalmente F non centrale. Questa comoda formula basata su RSS non è in generale robusta all’eteroschedasticità; quando necessario, si usa la formulazione robusta di Wald.
Un test F congiunto su due coefficienti può rifiutare anche quando nessuno dei singoli test t rifiuta, perché conta la covarianza tra le stime. Viceversa, diversi test t significativi presi isolatamente non costituiscono automaticamente evidenza contro una restrizione congiunta definita con attenzione, dopo avere tenuto conto dei confronti multipli.
Test di combinazioni lineari e interazioni
Supponiamo Y=β0+β1D+β2X+β3DX+u. Il contrasto di trattamento in corrispondenza di X=x è L=β1+xβ3. La sua stima è L̂=β̂1+xβ̂3 e la sua varianza è
Ignorare il termine di covarianza può alterare sensibilmente l'errore standard. Lo stesso principio vale per le somme di coefficienti che rappresentano effetti dinamici totali, effetti successivi a una politica e rendimenti in corrispondenza di uno specifico valore di una variabile moderatrice.
Test multipli e interpretazione sostanziale
Quando i ricercatori esaminano molti risultati, insiemi di controlli o sottogruppi e riportano soltanto i risultati più significativi, i p-value nominali possono sovrastimare gravemente l'evidenza. Per test esplorativi multipli può essere opportuno correggere il tasso di errore dell'intera famiglia mediante Bonferroni oppure usare procedure di controllo del tasso di false scoperte. Più in generale, un disegno di ricerca trasparente, la presentazione delle specificazioni complete e la distinzione tra analisi confermativa preregistrata e analisi esplorativa riducono le affermazioni fuorvianti.
Potenza, significatività statistica e dimensione dell'effetto
La potenza statistica è la probabilità di rifiutare l'ipotesi nulla per una specifica alternativa. Campioni indipendenti più grandi e minore rumore aumentano la potenza per un dato effetto, mentre elevata collinearità tra regressori, variazione limitata del trattamento ed errori correlati possono ridurla. Una stima non significativa non dimostra che l'effetto sia esattamente zero; può indicare informazioni limitate. Un intervallo molto stretto intorno a un effetto piccolo può mostrare che effetti grandi sono poco plausibili, il che può essere più utile di una decisione binaria del test.
Derivazione sistematica della statistica F parziale
Si consideri un modello non vincolato che stima k coefficienti di pendenza e un’intercetta, con somma dei quadrati dei residui RSSu. Imponendo q vincoli lineari indipendenti si ottiene RSSr, con RSSr≥RSSu perché l’insieme delle soluzioni ammissibili è più ristretto. Sotto i vincoli dell’ipotesi nulla e il modello normale con errori sferici, l’incremento della somma dei quadrati diviso per σ2 segue una distribuzione χ2 centrale con q gradi di libertà, indipendente da RSSu/σ2, che segue una χ2 con n−k−1 gradi di libertà. Il rapporto tra queste medie quadratiche segue quindi una distribuzione F(q,n−k−1). La normalità e gli errori sferici giustificano la distribuzione esatta di riferimento e l’indipendenza di queste forme quadratiche. L’identità campionaria TSS=ESS+RSS deriva invece dall’ortogonalità OLS in presenza di intercetta e non richiede né omoschedasticità né indipendenza stocastica.
Il test di Wald robusto utilizza invece la covarianza stimata di Rβ̂. Questo generalizza il risultato oltre la formula classica della covarianza e consente test le cui restrizioni combinano diversi coefficienti. Un confronto pratico tra modelli in R può riportare sia l'ANOVA classica sia i risultati di Wald robusti, ma la scelta scientificamente appropriata dipende dalla difendibilità delle ipotesi convenzionali sulla varianza.
Interpretare erroneamente un coefficiente non significativo
Supponiamo che l'effetto del salario minimo sull'occupazione sia stimato a −0.5%, con un intervallo approssimato al 95% da −7% a +6%. Definire il risultato «nessun effetto» non è giustificato: i dati possono essere compatibili sia con riduzioni sia con aumenti dell'occupazione economicamente rilevanti. Se l'intervallo corrispondente fosse (−0.7%,−0.3%), l'effetto sarebbe stimato con maggiore precisione, ma potrebbe essere economicamente piccolo. L'ampiezza e l'intervallo di valori sostanziali di un intervallo di confidenza forniscono spesso più informazioni utili alle politiche pubbliche del suo rapporto con una soglia arbitraria pari a zero.
10. Doppia selezione e controlli ad alta dimensionalità
Inferenza post-Lasso per un coefficiente di trattamento con molti controlli candidati
Il problema che motiva la doppia selezione
La regressione standard a bassa dimensionalità funziona quando l'insieme dei controlli significativi è contenuto rispetto alla dimensione campionaria e il ricercatore può specificare in anticipo un insieme credibile di variabili di aggiustamento. I dataset economici contemporanei possono contenere centinaia o migliaia di controlli candidati, trasformazioni e interazioni. Se il numero di regressori è elevato rispetto a n, i minimi quadrati ordinari possono essere instabili o impossibili da stimare con una soluzione unica. La selezione delle variabili esclusivamente predittiva può apparire allettante, ma scegliere i controlli soltanto perché prevedono il risultato può compromettere l'inferenza sull'effetto del trattamento.
Il modello centrale è una relazione parzialmente lineare
dove D è un trattamento o il regressore di principale interesse, X contiene potenzialmente molti controlli precedenti al trattamento e g0 è una funzione ausiliaria ad alta dimensionalità. Il parametro α0 è l'obiettivo della stima. Un'equazione ausiliaria del trattamento mette in relazione D con i controlli:
La seconda relazione è importante perché alcuni controlli possono essere predittori deboli di Y ma forti di D. Omettere queste variabili dal modello del risultato può distorcere il coefficiente del trattamento quando le variabili omesse influenzano anche Y.
Perché la selezione basata solo sul risultato può essere fuorviante
Immaginiamo che Xj abbia un'associazione modesta con i punteggi dei test ma un'associazione molto forte con la dimensione delle classi del distretto. Selezionare le variabili esclusivamente in base alla loro capacità di prevedere i punteggi può eliminare Xj, sebbene sia un fattore di confondimento rilevante per il processo di assegnazione del trattamento. Viceversa, selezionare soltanto i predittori di D può ignorare importanti determinanti di Y che contribuiscono a migliorare la precisione. Una procedura ad alta dimensionalità dovrebbe proteggere da entrambi i problemi, anziché considerare sufficiente l'accuratezza predittiva in una sola equazione.
In un modello a bassa dimensionalità, la formula classica della distorsione da variabile omessa ricorda che il confondimento dovuto all'omissione richiede sia un legame con D sia un legame con Y. La doppia selezione affronta sistematicamente questo duplice requisito selezionando i controlli da entrambe le relazioni.
Il Lasso come strumento di selezione preliminare
Il Lasso minimizza la somma degli errori quadratici più una penalizzazione L1 sui coefficienti di regressione:
Il parametro di regolazione λ controlla il grado di contrazione dei coefficienti. Poiché la penalizzazione basata sul valore assoluto crea punti angolosi, i coefficienti di alcuni predittori possono essere posti esattamente uguali a zero, generando un insieme selezionato di controlli. Standardizzare i predittori prima della penalizzazione è di solito necessario affinché le penalizzazioni sui coefficienti siano confrontabili. Il trattamento D non viene penalizzato nella regressione finale del parametro causale: è la variabile di cui vogliamo stimare l'effetto.
L'algoritmo della doppia selezione
In un'implementazione parzialmente lineare standard, si esegue anzitutto il Lasso di Y sui controlli X e si raccolgono i controlli selezionati per prevedere il risultato, Sᵧ. Poi si esegue il Lasso di D su X e si raccolgono i controlli selezionati per prevedere il trattamento, Sᴅ. Si forma la loro unione, S=Sᵧ∪Sᴅ, e si stima una regressione lineare ordinaria di Y su D e su tutti i controlli in S. Il coefficiente di D è lo stimatore post-doppia-selezione di α0.
L'unione è essenziale: selezionare sulla base di una sola equazione omette una classe di potenziali fattori di confondimento. Il metodo è particolarmente significativo quando esiste una rappresentazione approssimativamente sparsa delle relazioni ausiliarie, valgono appropriate condizioni di regolarità e la dimensione campionaria effettiva è sufficiente. Non supera l'endogeneità di D causata da fattori di confondimento realmente non osservati; può aggiustare soltanto per le informazioni rappresentate tra i controlli candidati.
Ortogonalizzazione e collegamento con il double machine learning
Una tecnica collegata rimuove dal risultato e dal trattamento la componente spiegata da X e regredisce un residuo sull'altro. Siano mᵧ(X)=E[Y|X] e mᴅ(X)=E[D|X]. Definiamo i residui Ỹ=Y−mᵧ(X) e D̃=D−mᴅ(X). Nel modello parzialmente lineare, α0 può essere stimato utilizzando l'equazione dei momenti
Questo momento è ortogonale nel senso di Neyman rispetto a perturbazioni delle funzioni ausiliarie opportunamente definite: piccoli errori nella stima di tali funzioni non hanno effetti del primo ordine sul momento di interesse in corrispondenza del vero valore. Il cross-fitting, che stima le funzioni ausiliarie su partizioni del campione non utilizzate per la corrispondente regressione del parametro di interesse basata sui residui, riduce la distorsione da sovraadattamento ed è particolarmente importante con metodi di apprendimento flessibili. La doppia selezione e il double machine learning tramite rimozione delle componenti spiegate condividono un quadro di identificazione, ma i loro algoritmi e le loro condizioni di regolarità non vanno confusi superficialmente.
Condizioni, inferenza e limiti
Gli intervalli di confidenza dopo la selezione non possono generalmente essere costruiti fingendo che una semplice fase di selezione delle variabili su una sola equazione non sia avvenuta. Risultati validi di doppia selezione richiedono ipotesi su sparsità approssimata, scelta della penalizzazione, momenti dei regressori, autovalori ristretti o condizioni analoghe sul disegno e velocità adeguate per la stima delle funzioni ausiliarie. Il teorema esatto dipende dallo stimatore e dal disegno campionario. L'inferenza robusta o per cluster deve tenere conto dell'effettiva struttura di dipendenza.
Se X contiene variabili causate da D, condizionare su di esse può eliminare parte dell'effetto causale o indurre una distorsione da collider. Pertanto, neppure un algoritmo di selezione matematicamente sofisticato sceglie il grafo causale al posto del ricercatore. Il significato economico e temporale dei controlli rimane indispensabile.
Implementazione pratica in R
Il codice seguente è un’implementazione schematica per un insieme di dati privo di valori mancanti nelle variabili y, d e nei controlli numerici da x1 a x5. Tutte le variabili devono riferirsi alle stesse righe selezionate prima di chiamare model.matrix e cv.glmnet. A scopo illustrativo, la penalizzazione viene scelta mediante validazione incrociata; il riepilogo mostrato serve a controllare il funzionamento del software e non costituisce una procedura convalidata di inferenza dopo la selezione. Le implementazioni inferenziali della letteratura possono utilizzare pesi di penalizzazione fondati teoricamente, cross-fitting o pacchetti dedicati alla doppia selezione.
library(glmnet)
X <- model.matrix(~ x1 + x2 + x3 + x4 + x5 - 1, data = dat)
fit_y <- cv.glmnet(X, dat$y, alpha = 1)
fit_d <- cv.glmnet(X, dat$d, alpha = 1)
sel_y <- which(as.vector(coef(fit_y, s = "lambda.min"))[-1] != 0)
sel_d <- which(as.vector(coef(fit_d, s = "lambda.min"))[-1] != 0)
keep <- sort(unique(c(sel_y, sel_d)))
final <- if (length(keep) == 0L) lm(dat$y ~ dat$d) else lm(dat$y ~ dat$d + X[, keep, drop = FALSE])
summary(final)
Per applicazioni operative, verifica la corrispondenza delle variabili e la gestione dell'intercetta, esamina la stabilità della selezione del modello, usa errori standard appropriati robusti all'eteroschedasticità o per cluster e consulta un'implementazione validata sul piano inferenziale, anziché supporre che il codice illustrativo costituisca una prova della copertura asintotica.
Doppia selezione e regressione stepwise ordinaria a confronto
La regressione stepwise tradizionale seleziona le variabili attraverso test di significatività sequenziali o criteri di adattamento. La procedura trascura spesso il ruolo inferenziale specifico del coefficiente di trattamento di interesse e può produrre modelli selezionati instabili con p-value ingenui successivi alla selezione non validi. La doppia selezione si basa invece sulla logica del fattore di confondimento omesso: include controlli che prevedono il risultato o il trattamento e stima poi il parametro di interesse dopo avere formato l'unione delle variabili di aggiustamento selezionate.
Da ciò non deriva che ogni variabile scelta da un algoritmo di apprendimento automatico sia un controllo valido precedente al trattamento. La teoria economica e l'ordine temporale degli eventi determinano quali caratteristiche possano essere candidate. Se un'impresa risponde a un sussidio aumentando occupazione e salari, l'occupazione successiva al sussidio non dovrebbe essere controllata automaticamente nel misurare l'effetto totale del sussidio sui salari, anche se un algoritmo la considera un potente predittore.
Quando è utile suddividere il campione
Nel double machine learning, dividere il campione in partizioni impedisce che le previsioni ausiliarie per l'osservazione i siano stimate utilizzando il risultato di quella stessa osservazione. I residui del trattamento e del risultato di ciascuna partizione vengono costruiti con modelli ausiliari addestrati sulle altre partizioni. Il momento ortogonale che ne risulta riduce la sensibilità del primo ordine alla distorsione da regolarizzazione, sotto velocità di convergenza adeguate. Il cross-fitting può migliorare la robustezza al sovraadattamento, ma non può superare il mancato soddisfacimento dell'ignorabilità condizionata o l'assenza di sovrapposizione.
Se il trattamento è continuo, l'aspettativa condizionata mᴅ(X) è una funzione di regressione; per un trattamento binario è il propensity score, cioè la probabilità condizionata di trattamento. La stessa logica di rimozione delle componenti spiegate conduce a uno stimatore basato sui residui, ma la strategia di modellizzazione e l'inferenza devono essere coerenti con il tipo di trattamento e il disegno statistico.
11. OLS nei grandi campioni e inferenza robusta
Consistenza, normalità asintotica e covarianza consistente in presenza di eteroschedasticità
Perché conta la teoria dei grandi campioni
La non distorsione nei campioni finiti è desiderabile, ma può richiedere ipotesi forti o risultare difficile da dimostrare nei modelli complessi. La teoria asintotica si chiede invece come si comporti la distribuzione di uno stimatore al crescere del numero di osservazioni campionate in modo appropriato. La consistenza significa convergenza in probabilità al parametro; la normalità asintotica caratterizza le fluttuazioni intorno a quel limite sulla scala √n. Queste proprietà sono logicamente distinte: uno stimatore può convergere a un parametro pseudo-vero errato e avere comunque una distribuzione limite normale intorno a esso.
Nella regressione multipla, l'identità OLS è β̂=β+(X′X)-1X′u. Riordinando si ottiene
Se (1/n)X′X converge in probabilità a una matrice finita e non singolare Q=E[XiXi′] e (1/n)X′u converge a zero, allora β̂ converge a β. La condizione decisiva è un momento di ortogonalità, E[Xiui]=0; nei modelli standard, l'indipendenza in media condizionata è un requisito sufficiente ma più forte.
Derivazione della consistenza
La legge dei grandi numeri (LLN) fa sì che le medie campionarie si avvicinino alle corrispondenti grandezze della popolazione. Per osservazioni indipendenti e identicamente distribuite, adeguati momenti finiti e non singolarità implicano
Pertanto E[Xu]=0 garantisce la consistenza, mentre E[Xu]≠0 produce tipicamente una distorsione asintotica non nulla. Questa espressione collega direttamente la stima nei grandi campioni ai problemi di variabili omesse ed endogeneità introdotti in precedenza. Un campione di un milione di osservazioni può stimare con precisione eccezionale il coefficiente angolare sbagliato della popolazione se E[Xu] non è zero.
La distribuzione asintotica e la varianza sandwich
Sia Ω=E[XiXi′ui2]. Con osservazioni indipendenti, adeguate condizioni sui momenti e un teorema del limite centrale (CLT),
Questa è la formula generale della covarianza asintotica robusta all'eteroschedasticità per uno stimatore lineare dei momenti correttamente riferito al parametro di interesse. La corrispondente covarianza approssimata per un campione finito è (1/n)Q-1ΩQ-1. Nella pratica, si sostituiscono Q e Ω con gli analoghi campionari e ui con i residui stimati:
L'apice HC0 indica la forma di base di Eicker–Huber–White. HC1 la moltiplica per un opportuno fattore di correzione dei gradi di libertà, mentre HC2 e HC3 applicano correzioni per la leva statistica osservazione per osservazione. La scelta può essere rilevante in presenza di osservazioni influenti e dataset più piccoli.
Perché gli errori standard robusti non correggono coefficienti distorti
OLS ordinario e OLS robusto all'eteroschedasticità usano gli stessi coefficienti stimati. La procedura robusta modifica la varianza stimata dello stimatore, non la strategia di identificazione. Se l'istruzione è correlata con l'abilità omessa, calcolare errori standard HC3 non trasforma l'associazione con gli anni di istruzione in un rendimento causale. L'inferenza può essere robusta all'eteroschedasticità mentre la stima puntuale rimane inconsistente a causa dell'endogeneità.
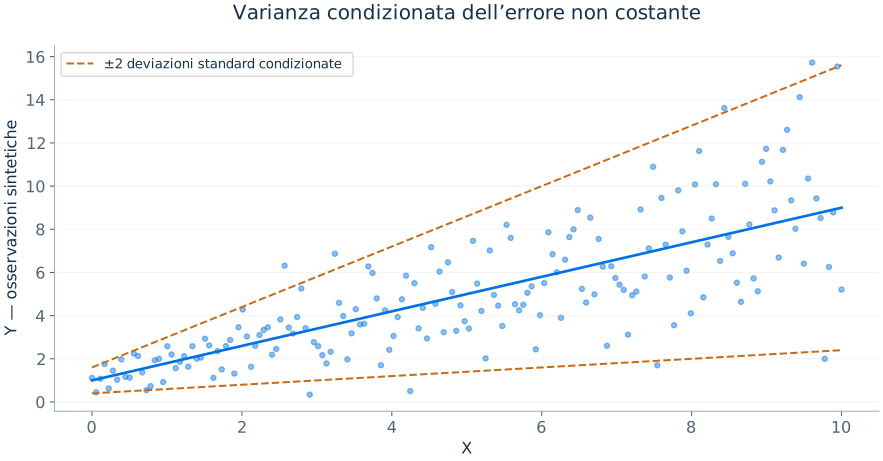
Osservazioni raggruppate e dipendenti nel tempo
Se gli studenti condividono le classi, i lavoratori condividono le imprese o le osservazioni si ripetono all'interno degli stessi paesi, gli errori possono essere correlati entro i cluster. Trattare osservazioni raggruppate come indipendenti può produrre un'eccessiva fiducia molto marcata. Gli stimatori della covarianza robusti per cluster aggregano i contributi allo score all'interno di ciascun cluster indipendente; la quantità effettiva di informazioni dipende spesso più dal numero di cluster indipendenti che dal conteggio grezzo delle osservazioni.
Siano Xg e ûg le osservazioni appartenenti al cluster g. Uno stimatore sandwich per cluster senza correzioni ha la forma
Le procedure pratiche applicano correzioni per piccoli campioni e usano distribuzioni di riferimento che tengono conto dei cluster. Con pochissimi cluster, l'asintotica standard può essere inaffidabile; possono essere necessari metodi bootstrap appropriati per cluster o disegni di ricerca alternativi. Per i dati di serie storiche, la stima della covarianza consistente in presenza di eteroschedasticità e autocorrelazione (HAC) considera esplicitamente la correlazione tra ritardi.
Il metodo delta per grandezze non lineari
Gli economisti riportano spesso una funzione g(β̂), come un'elasticità, un rapporto di coefficienti, un punto di svolta o un effetto dinamico cumulato. Se β̂ è asintoticamente normale e g è differenziabile nel parametro di interesse, il metodo delta fornisce
Per un rapporto g(a,b)=a/b, il gradiente è (1/b, −a/b2). I rapporti diventano instabili quando il denominatore è vicino a zero, perciò le approssimazioni delta del primo ordine possono funzionare male: un'avvertenza importante per gli stimatori a variabili strumentali con primi stadi deboli.
Test robusti nella pratica
Usa uno stimatore robusto della covarianza coerente con il disegno osservazionale, non semplicemente un'opzione predefinita. Gli errori standard HC presuppongono indipendenza tra osservazioni, pur consentendo varianze dell'errore diverse, mentre gli stimatori per cluster e HAC si rivolgono a strutture di dipendenza differenti. L'output di regressione pertinente dovrebbe dichiarare il numero di osservazioni, i controlli, le unità di raggruppamento e lo stimatore degli errori standard.
fit <- lm(y ~ x1 + x2 + x3, data = dat)
library(sandwich)
library(lmtest)
coeftest(fit, vcov. = vcovHC(fit, type = "HC3"))
# Cluster-robust inference when 'firm_id' identifies independent firms:
coeftest(fit, vcov. = vcovCL(fit, cluster = ~ firm_id))Varianza robusta e matrice hat
La leva statistica dell'osservazione i nella regressione lineare è hi=xi′(X′X)-1xi. Nei piccoli campioni, i residui stimati possono sottostimare sistematicamente i disturbi delle osservazioni ad alta leva. HC2 sostituisce ûi2 con ûi2/(1−hi), mentre HC3 usa ûi2/(1−hi)2 nella parte centrale dello stimatore sandwich. Queste correzioni possono produrre errori standard sensibilmente diversi quando il disegno contiene valori insoliti di X.
Nessuno stimatore HC corregge la dipendenza tra osservazioni. Ad esempio, se 500 studenti provengono da 10 classi, un calcolo HC3 continua a trattare le righe come indipendenti. In presenza di shock comuni alla classe, il raggruppamento a livello di classe è più pertinente. Dieci cluster possono essere troppo pochi per le convenzionali approssimazioni della distribuzione t basate sull'asintotica per cluster, perciò possono essere necessarie procedure per un numero finito di cluster o evidenze più forti fondate sul disegno di ricerca.
Il significato della normalità asintotica
L'affermazione √n(β̂−β)→ᵈN(0,V) implica che gli scostamenti campionari si riducano alla velocità 1/√n e si avvicinino a una forma normale dopo la standardizzazione. Non implica che β̂ sia non distorto per ogni n finito, né che sia universale la soglia di dimensione campionaria oltre la quale l'approssimazione diventa buona. Regressori quasi singolari, code pesanti e strumenti deboli sono esempi in cui il comportamento nei campioni finiti può discostarsi nettamente da una formula asintotica apparentemente attraente.
Una cautela particolarmente importante riguarda i rapporti. Uno stimatore 2SLS divide un momento campionario casuale per un altro. Se la rilevanza dello strumento è debole, il denominatore può essere vicino a zero con probabilità non trascurabile, rendendo la distribuzione del rapporto fortemente asimmetrica o a code pesanti. Trattare questo stimatore come approssimativamente normale può produrre intervalli di confidenza invalidi anche con molte osservazioni.
Covarianza HAC e scelta della finestra dei ritardi
Con osservazioni di serie storiche, la covarianza dello score della regressione st=xtut comprende prodotti tra date diverse. Uno stimatore consistente in presenza di eteroschedasticità e autocorrelazione, abbreviato HAC, ne stima la covarianza di lungo periodo invece di mantenere soltanto i prodotti relativi alla stessa data. Newey–West combina le autocovarianze campionarie degli score fino a una finestra di ritardi L, assegnando un peso minore ai ritardi più lontani; il peso di Bartlett al ritardo ℓ è 1−ℓ/(L+1).
Una finestra troppo breve può trascurare una dipendenza persistente, mentre una finestra lunga stima molte autocovarianze rumorose. Vanno indicati l’ordinamento delle osservazioni, la larghezza della finestra o la regola dei ritardi, l’eventuale prewhitening e una verifica di sensibilità significativa. HAC non corregge regressori endogeni, radici unitarie o un meccanismo causale omesso. Per una regressione stazionaria opportunamente specificata in R, sandwich::NeweyWest(fit, lag = 4, prewhite = FALSE) richiede un calcolo di Bartlett con quattro ritardi; quattro è un esempio, non una scelta universale. I panel con raggruppamenti e una singola serie temporale ordinata hanno strutture informative diverse, quindi un’opzione HAC non deve sostituire meccanicamente il clustering.
12. Endogeneità e minacce all'identificazione
Confondimento, errore di misura, simultaneità e selezione campionaria
Regressori endogeni
Rispetto alla condizione di ortogonalità lineare, endogeneità significa E[Xu]≠0 tra un regressore e il disturbo strutturale. La violazione di E[u|X]=0 è una violazione più ampia dell’esogeneità in media condizionale: non implica necessariamente E[Xu]≠0, perché una relazione condizionale non lineare può comunque avere covarianza nulla. Il problema centrale riguarda l’interpretazione: OLS combina l’effetto strutturale con le fonti di variazione della variabile esplicativa generate da fattori non osservati. L’endogeneità può derivare da variabili omesse, causalità inversa, determinazione simultanea, errori di misurazione, selezione del campione o scelte inappropriate delle variabili su cui condizionare.
Consideriamo un'equazione del mercato del lavoro che descrive il rendimento causale di un anno di istruzione. Abilità, risorse dei genitori e reti di relazioni possono influenzare sia i salari sia la decisione di acquisire istruzione. L'omissione di questi fattori può rendere endogena l'istruzione. Analogamente, un prezzo di mercato più alto potrebbe essere correlato con shock di domanda, perché domanda e offerta determinano congiuntamente prezzo e quantità di equilibrio; una regressione della quantità sul prezzo non può isolare direttamente una curva di domanda.
Un'interpretazione generale della distorsione da variabile omessa
La formula semplice della distorsione da variabile omessa offre una prima diagnosi. Si supponga Y=β0+β1X+β2Z+u, con Cov(X,u)=0 e Var(X)>0. Una regressione nella popolazione di Y su un’intercetta e X, che omette Z, ha pendenza β1+β2 Cov(X,Z)/Var(X). Il problema non scompare aggiungendo un numero arbitrario di variabili: i controlli scelti devono includere i fattori confondenti pertinenti e, quando l’obiettivo è l’effetto causale totale, dovrebbero generalmente essere misurati prima del trattamento.
I controlli inappropriati meritano particolare attenzione. Un mediatore successivo al trattamento può assorbire una parte dell'effetto causale che si intende stimare. Condizionare su una variabile influenzata sia dal trattamento sia da determinanti non osservate del risultato può aprire un percorso statistico spurio. Una specificazione corretta della regressione richiede una teoria dell'ordine temporale e delle relazioni causali tra le variabili, non soltanto un algoritmo che massimizzi R2.
Errore di misura
Se una variabile dipendente è misurata con un errore classico indipendente, l’esito diventa più rumoroso e, sotto le ipotesi standard, i coefficienti OLS spesso rimangono consistenti, sebbene l’inferenza diventi meno precisa. Se il regressore osservato X è uguale al valore vero X* più un errore classico additivo di misurazione, X=X*+w, dove w ha media zero ed è indipendente da X* e dal disturbo strutturale u, la regressione OLS di Y su X in un modello semplice ha limite in probabilità
Il termine è il rapporto di affidabilità, compreso tra zero e uno sotto queste ipotesi, che produce attenuazione verso zero. Un errore di misura più complesso, correlato con i valori veri, altri regressori o il risultato, può distorcere i coefficienti in qualsiasi direzione. L'affermazione generica secondo cui l'errore di misura attenua sempre le stime è errata, specialmente nella regressione multivariata.
Equazioni simultanee ed equilibrio
Immaginiamo domanda e offerta di mercato lineari:
Le transazioni osservate soddisfano Qᵈ=Qˢ, quindi il prezzo di equilibrio risponde sia agli shock di domanda sia a quelli di offerta. Una regressione di Q su P tra diversi equilibri non recupera necessariamente né a1 né b1. Per identificare la pendenza della domanda, il ricercatore cerca una fonte di variazione del prezzo che sposti l'offerta senza spostare direttamente la domanda, ad esempio una variazione dei costi di offerta plausibilmente esogena, sottoponendo la sua restrizione di esclusione a un'attenta valutazione economica.
Dati mancanti, selezione e validità esterna
Un campione può escludere le persone che non rispondono, le imprese che escono dal mercato, i lavoratori che non partecipano all'occupazione o le famiglie che rifiutano di dichiarare la propria ricchezza. Se l'inclusione nel campione è collegata a determinanti non osservate di Y dopo aver condizionato su X, la regressione osservata può non essere rappresentativa. Inoltre, un effetto di popolazione stimato correttamente per il gruppo campionato può non trasferirsi a una popolazione obiettivo economicamente diversa.
I modelli di selezione campionaria possono talvolta recuperare il parametro di interesse sotto ipotesi distributive o di esclusione, ma non esiste una correzione universale. Occorre individuare chi è stato incluso, perché e in quale fase, e verificare se siano state registrate le variabili che determinano l'inclusione.
Validità interna ed esterna
La validità interna riguarda la capacità del confronto empirico di identificare l'effetto di interesse nella popolazione studiata. Confondimento omesso, simultaneità ed errore di misura la minacciano. La validità esterna riguarda invece la possibilità di generalizzare una stima internamente valida a popolazioni, istituzioni, periodi o intensità di trattamento diversi. L'effetto di classi scolastiche più piccole in una regione può differire da quello in un'altra regione con una diversa offerta di insegnanti o dimensioni iniziali delle classi differenti.
Uno studio credibile distingue esplicitamente validità interna ed esterna e spiega la fonte di identificazione, anziché presumere che un coefficiente statisticamente significativo risolva entrambe le questioni.
Analisi di sensibilità
Controlli di robustezza utili includono modifiche della forma funzionale, insiemi di controlli motivati economicamente, analisi di sottocampioni, diagnostica delle osservazioni influenti, misure alternative, risultati placebo ed esame delle plausibili violazioni dell'ipotesi di identificazione. La robustezza rispetto a diverse specificazioni arbitrarie non sostituisce una fonte credibile di variazione esogena. È evidenza sulla sensibilità alla specificazione, non una garanzia formale di identificazione causale.
Endogeneità, controlli inappropriati e distorsione da collider
Un collider è una variabile causata da due o più variabili che, altrimenti, potrebbero essere non correlate. Condizionare su un collider può creare dipendenza statistica tra le sue cause. Ad esempio, tra i candidati ammessi a un programma di borse di studio molto selettivo, motivazione e relazioni familiari potrebbero essere associate negativamente anche se fossero indipendenti nella popolazione dei candidati, perché ciascuna delle due caratteristiche può aumentare la probabilità di ammissione. Una regressione limitata ai beneficiari selezionati può quindi generare relazioni non presenti nell'intera popolazione.
La distinzione tra fattori di confondimento, mediatori e collider è concettualmente importante. Un fattore di confondimento è una causa comune del trattamento e del risultato; aggiustare per esso può ridurre la distorsione. Un mediatore è in parte causato dal trattamento e influenza poi il risultato; aggiustare per esso cambia l'effetto causale oggetto di stima. Un collider è una conseguenza comune di altre variabili; condizionare su di esso può indurre distorsione. L'ordine temporale e le istituzioni economiche dovrebbero guidare l'identificazione di queste categorie, anziché le correlazioni osservate a posteriori.
Come costruire un'argomentazione di sensibilità
Supponiamo che un coefficiente OLS dell'istruzione diminuisca da 0.10 a 0.07 quando si includono il contesto familiare e i punteggi dei test. Questa variazione suggerisce che i fattori misurati contribuiscano a spiegare l'associazione originaria, ma non quantifica direttamente il confondimento residuo dovuto all'abilità non misurata. Un'argomentazione di sensibilità può chiedersi quanto forte dovrebbe essere il legame di una variabile non osservata sia con l'istruzione sia con i salari per spiegare il restante 0.07, rispetto all'intensità dei legami dei controlli osservati. Questi confronti devono dichiarare le ipotesi e non vanno mai trattati come prova di esogeneità.
13. Variabili strumentali e minimi quadrati a due stadi
Identificazione attraverso variazione esclusa, strumenti deboli e inferenza IV
Motivazione e idea della variabile strumentale
Quando un regressore è endogeno, una variabile strumentale valida Z fornisce variazione in X non collegata all'errore strutturale che influenza Y. Consideriamo il modello strutturale Y=β0+β1D+u. Uno strumento valido deve soddisfare la rilevanza — prevede D dopo aver considerato i controlli inclusi — e l'esogeneità o esclusione — è incorrelato con u e non influenza Y attraverso un altro canale causale nel modello strutturale di interesse. Queste restrizioni hanno un contenuto economico sostanziale. Un'elevata correlazione tra Z e D non dimostra né la restrizione di esclusione né l'assenza di effetti diretti.
In un modello lineare esattamente identificato con un solo strumento e un'intercetta, il coefficiente angolare IV risolve il momento campionario ΣZi(Yi−β0−β1Di)=0 insieme al momento dell'intercetta. La sua forma semplice è
Nella popolazione, se Cov(Z,u)=0 e Cov(Z,D)≠0, il rapporto identifica β1. Se lo strumento prevede D solo debolmente, il denominatore è vicino a zero e la stima IV può essere estremamente instabile: è il problema degli strumenti deboli.
Lo stimatore di Wald con uno strumento binario
Quando Z è binaria, il rapporto tra covarianze diventa un rapporto tra differenze di gruppo:
Il numeratore è l'effetto in forma ridotta dello strumento sul risultato. Il denominatore è l'effetto di primo stadio dello strumento sull'adesione al trattamento. IV rapporta l'effetto dell'assegnazione sul risultato alla variazione indotta nel trattamento. Non richiede quindi che tutti i partecipanti aderiscano perfettamente, ma il suo significato causale in presenza di effetti del trattamento eterogenei dipende da ipotesi aggiuntive.
Minimi quadrati a due stadi (2SLS)
Con più controlli W ed eventualmente più strumenti esclusi Z, si regredisce prima ciascuna variabile esplicativa endogena sugli strumenti esclusi e su tutti i controlli esogeni inclusi. I valori stimati isolano la proiezione lineare dei regressori endogeni sulla variazione degli strumenti. Si regredisce poi il risultato sui regressori proiettati e sui controlli inclusi. Per un singolo regressore endogeno D,
Il coefficiente è lo stimatore 2SLS. Nella pratica, occorre usare una procedura IV dedicata per ottenere errori standard 2SLS corretti. Gli errori standard OLS ordinari di una regressione che sostituisce D̂ come se fosse osservato senza errore sono generalmente errati, perché non usano i residui strutturali appropriati e la struttura della covarianza IV.
Lo stimatore matriciale 2SLS nel modello strumentale completo è
dove X contiene i regressori endogeni e quelli esogeni inclusi, mentre Z contiene tutti gli strumenti validi, compresi i regressori esogeni inclusi. La condizione di rango richiede un numero sufficiente di strumenti esclusi rilevanti e linearmente indipendenti per identificare tutti i regressori endogeni.
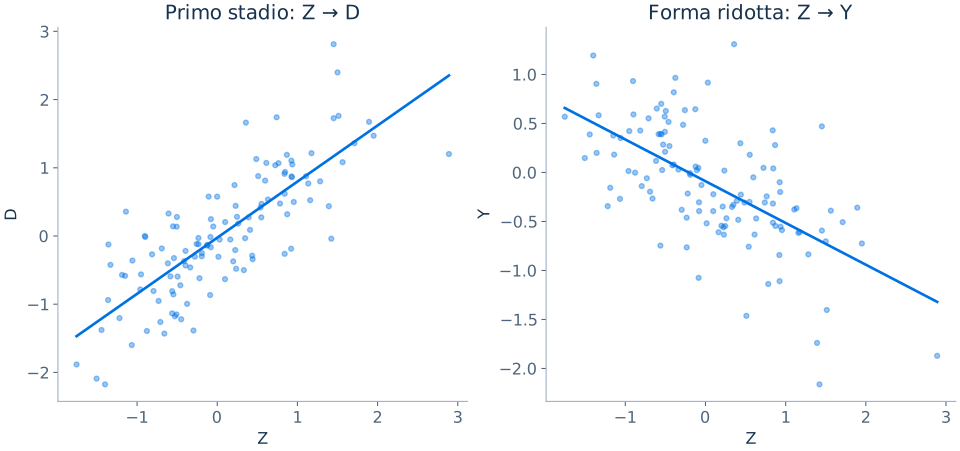
Identificazione ed esclusione
La rilevanza può spesso essere valutata mediante i dati, ma l'esclusione è raramente verificabile in modo completo e richiede un ragionamento sul contesto istituzionale. Gli strumenti possono essere deboli nonostante associazioni bivariate statisticamente significative quando il primo stadio viene valutato condizionatamente a molti controlli. Anche la direzione e l'ampiezza dei coefficienti di primo stadio meritano un esame economico. Uno strumento che sposta sia la domanda sia l'offerta, ad esempio, non isola una delle due curve per il solo fatto di essere correlato con il prezzo.
Esistono tre categorie comuni di identificazione: sottoidentificazione quando la variazione indipendente degli strumenti è insufficiente, identificazione esatta quando il numero di restrizioni strumentali valide corrisponde ai parametri endogeni e sovraidentificazione quando gli strumenti sono più numerosi dei parametri endogeni. La sovraidentificazione può consentire controlli di specificazione, ma non rende automaticamente validi gli strumenti.
Strumenti deboli e diagnostica del primo stadio
Gli strumenti deboli generano distorsione nei campioni finiti, non normalità potenzialmente grave e inferenza convenzionale t e di Wald inaffidabile. Le statistiche F di primo stadio o le corrispondenti misure diagnostiche robuste condizionate valutano la rilevanza, ma una soglia universale non è valida in ogni contesto. La nota regola F>10 è un criterio orientativo storico e approssimato per specificazioni circoscritte, non un teorema che garantisca una copertura corretta in presenza di eteroschedasticità, raggruppamento o più regressori endogeni.
Quando è plausibile un'identificazione debole, occorre riportare test o insiemi di confidenza appropriati robusti agli strumenti deboli, come procedure di tipo Anderson–Rubin sotto ipotesi adeguate, e chiedersi se il disegno empirico sia effettivamente informativo. Aggiungere molti strumenti solo marginalmente rilevanti può peggiorare, anziché migliorare, la performance nei campioni finiti.
Test di sovraidentificazione
Con più restrizioni sui momenti strumentali che coefficienti strutturali, il test J di Hansen può valutare se l'insieme delle restrizioni sia reciprocamente compatibile con il modello specificato e con le ipotesi sulla covarianza. Un rifiuto segnala che almeno una condizione sui momenti mantenuta non è coerente con le altre o con la specificazione del modello. Il mancato rifiuto non dimostra la validità: strumenti invalidi potrebbero condividere la stessa violazione oppure il test potrebbe avere bassa potenza.
Per un singolo regressore endogeno esattamente identificato con un solo strumento escluso non esiste alcuna restrizione di sovraidentificazione da testare. Il compito empirico rilevante consiste nel difendere l'esclusione mediante la conoscenza della materia ed esaminare attentamente l'effetto di strumenti candidati alternativi.
Effetti del trattamento eterogenei e LATE
Quando l'effetto di D varia tra individui, IV non identifica necessariamente l'effetto medio del trattamento (ATE) nella popolazione. Con uno strumento e un trattamento binari, la monotonicità dei trattamenti potenziali e le altre ipotesi standard, il rapporto di Wald identifica l'effetto medio locale del trattamento (LATE): l'effetto medio tra i compliers, ossia coloro che ricevono il trattamento se incoraggiati e non lo ricevono altrimenti. Questa è una popolazione definita dall'effetto dello strumento sul comportamento, non un sottoinsieme casuale di tutti gli individui.
Uno strumento diverso può identificare una diversa popolazione di compliers e quindi un diverso effetto locale anche quando entrambe le stime IV sono internamente valide. Interpretare IV come un effetto universalmente applicabile richiede di considerare l'eterogeneità della popolazione e il significato economico dell'adesione al trattamento.
Applicare IV in R
La formula nell'esempio successivo indica y come risultato, d come regressore endogeno, x1+x2 come controlli esogeni inclusi e z come strumento escluso. L'inferenza robusta utilizza una funzione appropriata per la covarianza. In presenza di un disegno panel o per cluster credibile, occorre sostituire di conseguenza il metodo di stima della covarianza.
library(AER)
iv <- ivreg(y ~ d + x1 + x2 | z + x1 + x2, data = dat)
summary(iv, diagnostics = TRUE)
library(lmtest)
library(sandwich)
coeftest(iv, vcov. = vcovHC(iv, type = "HC1"))
# Explain and inspect the first stage:
first_stage <- lm(d ~ z + x1 + x2, data = dat)
summary(first_stage)La geometria della rilevanza di primo stadio
Dopo aver rimosso la componente spiegata dai controlli inclusi W, il primo stadio verifica se i residui degli strumenti prevedano la variazione residua endogena. Con uno strumento Z e un regressore endogeno D, la rilevanza è Cov(Z̃,D̃)≠0 dopo che da entrambi è stata rimossa la componente spiegata da W. Una correlazione non condizionata diversa da zero non basta se deriva interamente dalla dipendenza comune dai controlli inclusi. Una buona presentazione IV esamina il primo stadio condizionato e il meccanismo economico attraverso cui lo strumento modifica il trattamento.
In presenza di più strumenti, una regressione di primo stadio può avere un forte adattamento grazie a strumenti singolarmente correlati con D, ma l'identificazione richiede comunque condizioni di rango appropriate per tutti i regressori endogeni. Con più variabili endogene, la rilevanza è una condizione multivariata e non può essere ridotta a una singola correlazione bivariata.
Precisione IV e disegno di ricerca
Anche con uno strumento effettivamente valido, le stime IV possono essere meno precise di OLS perché usano soltanto la componente della variazione del trattamento prevista dallo strumento. È il prezzo pagato per isolare una variazione plausibilmente esogena. Riportare una stima imprecisa ma credibile può essere scientificamente più informativo che riportare un'associazione OLS molto precisa ma soggetta a confondimento. I confronti tra OLS e IV devono considerare non soltanto la distorsione, ma anche i diversi effetti ponderati in presenza di eterogeneità degli effetti del trattamento.
Un esempio numerico a due stadi
Consideriamo uno strumento che aumenti il tasso di partecipazione previsto da 0.20 a 0.50 e la media prevista del risultato da 100 a 112. La forma ridotta è 12 e la variazione di primo stadio è 0.30; il coefficiente angolare IV esattamente identificato è 40 unità del risultato per partecipazione indotta. Supponiamo ora che la variazione nella partecipazione sia soltanto 0.03, mentre la forma ridotta stimata rimane 12. Il rapporto diventa 400, illustrando la sensibilità esplosiva dello stimatore di Wald a un denominatore debole. Questo calcolo non significa che 400 sia un effetto plausibile: il primo stadio piccolo può rendere inaffidabili le approssimazioni convenzionali dell'incertezza.
Come si costruisce un insieme di confidenza di Anderson–Rubin
Si considerino un regressore endogeno D e un valore candidato b del suo coefficiente. Sotto l’ipotesi nulla che b sia il vero effetto strutturale, sottrarre bD da Y lascia una combinazione dei controlli esogeni e del disturbo strutturale. Gli strumenti esclusi validi dovrebbero quindi avere coefficienti nulli in una regressione di Y−bD su tali strumenti e su tutti i controlli esogeni inclusi. Il test di Anderson–Rubin verifica questo vincolo congiunto senza dividere per un coefficiente di primo stadio stimato.
Invertire il test significa mantenere ogni b che non viene rifiutato al livello di significatività scelto. L’insieme di confidenza risultante può essere ampio, disconnesso o illimitato quando i dati contengono poca informazione identificante. Queste forme hanno un significato e non devono essere troncate per ottenere un intervallo finito rassicurante. La versione F classica richiede le proprie ipotesi di normalità ed errori sferici; le varianti robuste usano stimatori di covarianza adeguati all’eteroschedasticità o al clustering e la corrispondente giustificazione asintotica. La protezione contro una rilevanza debole non protegge da una restrizione di esclusione invalida. Vanno esplicitate sia le ipotesi mantenute sugli strumenti sia la procedura inferenziale.
14. Serie storiche, modelli AR e previsione
Dipendenza nel tempo, stazionarietà, selezione dei ritardi e valutazione rigorosa delle previsioni
La natura della variabilità nelle serie storiche
Una serie storica è una sequenza ordinata di osservazioni indicizzate nel tempo, come il PIL trimestrale, l’inflazione mensile o i rendimenti giornalieri delle attività finanziarie. A differenza delle osservazioni trasversali indipendenti, le osservazioni vicine nel tempo contengono spesso informazioni sovrapposte: la produzione di oggi dipende da quella di ieri, i livelli dei prezzi incorporano le variazioni passate e la volatilità finanziaria può persistere per più periodi. L’inferenza statistica e la previsione devono tenere conto di questa struttura temporale, invece di applicare meccanicamente formule ricavate per osservazioni indipendenti.
Una trasformazione utile è la differenza prima ΔYt=Yt−Yt₋1. Per una serie positiva, Δln(Yt)=ln(Yt)−ln(Yt₋1) approssima il tasso di crescita tra t−1 e t. Se Y è un indice o il livello generale dei prezzi, una differenza può essere significativa nelle unità dei livelli, mentre una differenza logaritmica misura una variazione proporzionale. Le trasformazioni possono eliminare alcune forme di tendenza, ma possono anche modificare la domanda economica e introdurre una propria struttura di correlazione seriale.
Autocovarianza, autocorrelazione e stazionarietà
Per un processo debolmente stazionario, la media E[Yt]=μ è invariata nel tempo, la varianza è finita e costante e la covarianza tra Yt e Yt₋k dipende soltanto dal ritardo k, non dalla data t. Indichiamo questa autocovarianza con γ(k)=Cov(Yt,Yt₋k). L’autocorrelazione è ρ(k)=γ(k)/γ(0). Un’autocorrelazione positiva di primo ordine significa che le osservazioni superiori alla media tendono a essere seguite da ulteriori osservazioni superiori alla media.
Le serie storiche non stazionarie possono presentare medie variabili, varianza variabile o tendenze stocastiche persistenti. Una serie che mostra visivamente una tendenza non è automaticamente un processo con radice unitaria; distinguere le tendenze deterministiche da quelle stocastiche è importante per le trasformazioni, i test delle ipotesi e l’incertezza delle previsioni.
Il modello autoregressivo di ordine uno
Un processo AR(1) ha la forma
dove εt ha media condizionale nulla data l’informazione disponibile al tempo t−1. Con |φ|<1 e innovazioni di rumore bianco di varianza σ2, la soluzione stazionaria causale ha media μ=c/(1−φ) e varianza σ2/(1−φ2). Questi momenti stazionari valgono quando il processo è inizializzato nella propria distribuzione stazionaria; un valore iniziale arbitrario genera una fase transitoria. La media condizionale nulla, che è più forte della semplice assenza di correlazione con il passato, giustifica la previsione condizionale riportata di seguito. Per φ positivo e inferiore a uno, uno shock si attenua gradualmente anziché scomparire immediatamente.
La previsione condizionata a k passi, con parametri noti, è
Quando |φ|<1, le previsioni tendono alla media di lungo periodo all’aumentare di k. Se φ si avvicina a uno, gli shock si attenuano molto lentamente e l’incertezza su orizzonti lunghi diventa considerevole. Per φ=1, il processo è una passeggiata aleatoria con deriva: le formule standard dei modelli AR stazionari non sono più applicabili.
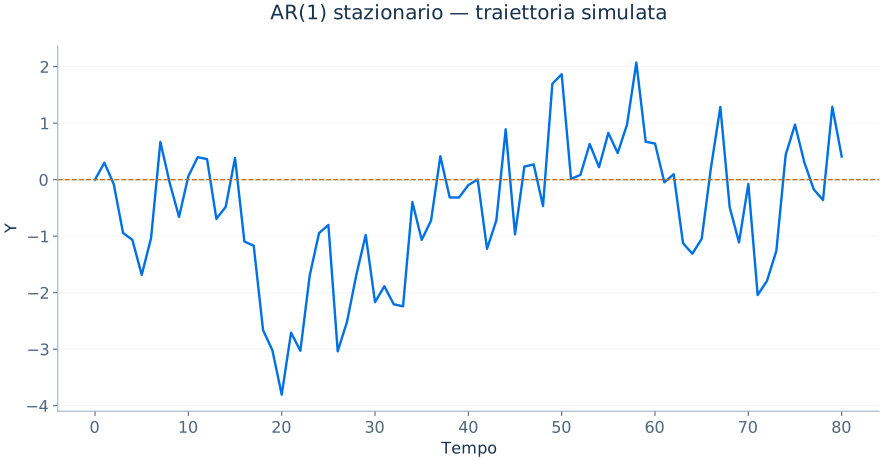
Autoregressioni di ordine superiore
Un modello AR(p) include p ritardi della variabile dipendente:
Ordini di ritardo più elevati consentono di rappresentare forme di persistenza più articolate, ma aggiungono parametri e richiedono un campione effettivo di stima più ampio. La condizione di stabilità pertinente per un AR(p) riguarda le radici del polinomio caratteristico, non semplicemente il fatto che ciascun coefficiente stimato abbia individualmente valore assoluto inferiore a uno. La regressione può essere stimata con OLS sotto opportune ipotesi di esogeneità dei predittori ritardati rispetto all’innovazione corrente e ulteriori ipotesi di stazionarietà o regolarità.
Selezione del modello: AIC, BIC e validazione
L’ordine dei ritardi p può essere scelto mediante criteri informativi che bilanciano adattamento ai dati e complessità del modello. Una forma comune di tipo gaussiano, basata su una stima della varianza residua, è
dove kp conta i parametri stimati e T è la numerosità campionaria effettiva. Nell’insieme dei modelli candidati, valori inferiori del criterio sono preferibili secondo la convenzione scelta. La penalizzazione del BIC cresce con ln T e favorisce maggiormente i modelli parsimoniosi quando il campione aumenta. Per effettuare confronti validi, i diversi ordini di ritardo devono essere valutati su campioni di stima comparabili e i criteri devono adottare normalizzazioni compatibili.
La validazione incrociata delle serie storiche deve preservare l’ordine cronologico. Una strategia è la valutazione con origine mobile: si stima il modello usando i dati disponibili fino alla data t, si prevede t+1, si avanza nel tempo e si ripete. In questo modo si ottiene una stima pratica delle prestazioni nella previsione di osservazioni realmente future. La validazione incrociata con suddivisioni casuali può introdurre informazioni future nella stima se le suddivisioni interrompono la struttura temporale.
MSFE, incertezza delle previsioni e modelli di riferimento
Per le previsioni a h passi Ŷt₊h|t, gli errori di previsione sono et₊h=Yt₊h−Ŷt₊h|t. L’errore quadratico medio di previsione è MSFE=(1/m)Σe2, calcolato su effettive date di valutazione. Un buon riferimento può essere una media storica, una passeggiata aleatoria o un semplice modello AR. I modelli sofisticati devono essere confrontati con alternative più semplici e credibili, utilizzando dati non impiegati nella stima.
Gli intervalli di previsione devono considerare l’incertezza delle innovazioni, quella dei parametri e la possibile instabilità del modello. In un AR(1) stazionario con φ noto e innovazioni di varianza condizionale costante σ2 e media condizionale nulla, la varianza dell’errore di previsione a k passi dovuta alle innovazioni è
Orizzonti più lunghi comportano normalmente un accumulo di incertezza. Se i parametri del modello sono stimati, occorre considerare l’incertezza aggiuntiva quando la dimensione campionaria la rende rilevante.
Radici unitarie e regressione spuria
Una passeggiata aleatoria Yt=Yt₋1+εt ha una radice unitaria e non è debolmente stazionaria. Regredire una serie con tendenza su un’altra serie con tendenza priva di legami con la prima può produrre statistiche t e valori di R2 apparentemente notevoli, anche se le innovazioni sottostanti sono indipendenti: è una regressione spuria. I test di radice unitaria hanno distribuzioni di riferimento non standard e non devono essere interpretati come normali test t di regressione. In alcuni casi la differenziazione permette di ottenere un processo stazionario, ma differenziare una relazione che è effettivamente stazionaria dopo aver eliminato la tendenza può far perdere informazioni preziose.
Quando due serie non stazionarie condividono una relazione di equilibrio stabile di lungo periodo, possono essere cointegrate. Un modello a correzione dell’errore può rappresentare sia le variazioni di breve periodo sia l’aggiustamento verso l’equilibrio di lungo periodo. Si tratta di un’estensione sostanziale; trovare semplicemente una regressione statisticamente significativa tra due livelli dei prezzi non costituisce una prova sufficiente di cointegrazione.
La previsione in pratica con R
L’esempio seguente illustra la stima di un modello AR, l’addestramento rispettoso dell’ordine temporale e alcuni principi diagnostici di base. Nella ricerca effettiva occorre verificare gli effetti stagionali, l’autocorrelazione dei residui, le rotture strutturali e la stabilità delle previsioni.
# Assume y is a numeric time-series vector ordered chronologically.
y_train <- head(y, length(y) - 12)
y_test  <- tail(y, 12)
fit_ar <- arima(y_train, order = c(1, 0, 0), include.mean = TRUE)
fc <- predict(fit_ar, n.ahead = 12)
rmse <- sqrt(mean((y_test - fc$pred)^2))
print(rmse)
acf(residuals(fit_ar))Effetti dinamici e modelli a ritardi distribuiti
Un’economia può non rispondere interamente a una politica nello stesso periodo in cui questa viene attuata. Un modello a ritardi distribuiti descrive l’esito come funzione delle variabili esplicative correnti e ritardate, per esempio
Qui δ0 è la risposta contemporanea, mantenendo fissi gli altri termini esplicativi, mentre δ1 e δ2 rappresentano ulteriori risposte su orizzonti successivi secondo l’interpretazione temporale del modello. Se un aumento permanente di un’unità di X persiste dal periodo t in avanti, la risposta cumulata, dopo che tutti i ritardi inclusi hanno prodotto i loro effetti, è δ0+δ1+δ2. L’errore standard di questa somma deve comprendere le covarianze tra le stime dei coefficienti dei ritardi.
Per un’interpretazione causale, la sequenza degli input X deve essere esogena in un senso sufficientemente forte rispetto agli shock non osservati. Ritardare un regressore non elimina automaticamente l’endogeneità: gli agenti possono anticipare gli shock, le politiche possono rispondere a perturbazioni passate e condizioni persistenti non osservate possono essere correlate con i valori presenti di X.
Confronto tra previsioni e rotture strutturali
Una rottura strutturale si verifica quando cambiano la media, la varianza o i coefficienti predittivi. Un modello AR stimato interamente prima di una riforma importante può produrre previsioni scadenti dopo la riforma, anche con un basso errore residuo storico. Le valutazioni mobili e i test di stabilità sono quindi fondamentali per l’affidabilità delle previsioni. Un modello può offrire ottime previsioni a un passo, ma peggiorare su orizzonti più lunghi perché piccoli errori dinamici si accumulano. Indica sempre l’orizzonte, la finestra di addestramento e il modello di riferimento; affermare che un modello di previsione è «accurato» senza questi dettagli è incompleto.
Verificare una radice unitaria: conta l’ipotesi nulla
La regressione di Dickey–Fuller aumentata spiega la differenza prima usando il livello ritardato, eventuali termini deterministici e ritardi della differenza prima. Nell’equazione seguente, l’ipotesi nulla di radice unitaria è γ=0. L’alternativa stazionaria presenta un coefficiente di aggiustamento negativo nell’appropriata specificazione stabile. La costante, il trend e l’ordine dei ritardi influenzano la distribuzione di riferimento e l’interpretazione; un valore critico ordinario della t di Student non è appropriato.
Non rifiutare una radice unitaria non ne dimostra la presenza, soprattutto in serie brevi o molto persistenti. Il test KPSS parte invece da un’ipotesi nulla di stazionarietà, quindi il suo p-value risponde a una domanda diversa. Risultati contrastanti dovrebbero indurre a esaminare rotture strutturali, trend deterministici e potenza nei campioni finiti, anziché a contare quale esito prevale tra i test. Una differenziazione eccessiva può introdurre correlazione seriale non necessaria ed eliminare relazioni in livelli economicamente significative. In R, tseries::adf.test include per impostazione predefinita una costante e un trend lineare; questa scelta va compresa e non scambiata per un test neutrale rispetto a qualsiasi possibile specificazione deterministica.
| Test | Ipotesi nulla | Significato del rifiuto |
|---|---|---|
| ADF | Radice unitaria con i termini deterministici specificati | Evidenza contraria a quel modello con radice unitaria |
| KPSS | Stazionarietà in livello o attorno a un trend, secondo la specificazione | Evidenza contraria a quel modello di stazionarietà |
15. Dati panel, differenze prime ed effetti fissi
Usare la variazione interna alle unità per controllare l’eterogeneità invariata nel tempo
Perché i panel modificano il problema di identificazione
Le regressioni trasversali confrontano individui, imprese o regioni differenti. Se le unità possiedono caratteristiche persistenti ma non osservate, come capacità manageriale, qualità istituzionale o preferenze consolidate, questi fattori possono confondere le associazioni trasversali. I dati panel osservano ripetutamente le stesse unità e permettono di rimuovere le caratteristiche non osservate fisse mediante confronti interni a ciascuna unità. Questo vantaggio comporta nuove ipotesi sui fattori confondenti variabili nel tempo e sulla dipendenza all’interno delle unità.
Il modello canonico a effetti fissi additivi è
Qui αi è un effetto dell’unità invariato nel tempo, λt è un effetto temporale comune alle unità e uit è la componente residua di disturbo variabile nel tempo. Il coefficiente β è identificato dalle variazioni di X interne a ciascuna unità, dopo aver corretto per gli shock temporali comuni, sotto le ipotesi di esogeneità pertinenti. Per una variabile che non cambia mai all’interno di un individuo non è possibile identificare separatamente un proprio coefficiente in un modello con effetti fissi individuali non vincolati.
Differenziazione prima con due periodi
Con due periodi, si parte da Yi1=αi+βXi1+ui1 e Yi2=αi+βXi2+ui2. Sottraendo la prima equazione dalla seconda:
La componente non osservata αi scompare esattamente. OLS sulle differenze stima β in modo consistente quando le variazioni di X sono opportunamente esogene rispetto alle variazioni del disturbo. Non è necessario che una caratteristica individuale non osservata costante sia incorrelata con X in livelli: questo è il principale vantaggio del metodo.
Tuttavia, la differenziazione prima non elimina i fattori non osservati che variano nel tempo. Se un’impresa modifica gli investimenti perché uno shock di domanda non registrato aumenta le vendite attese, quello shock può influenzare sia ΔX sia ΔY. Anche l’errore di misurazione può diventare più importante dopo la differenziazione, perché il segnale di una variabile persistente si riduce mentre il rumore di misurazione rimane.
Stima a effetti fissi mediante trasformazione within
Con più di due periodi, si calcola la media temporale di ciascun individuo. Il modello Yit=αi+βXit+uit implica Ȳi=αi+βX̄i+ūi. Si sottrae l’equazione delle medie da ciascun periodo:
OLS su questi dati depurati delle rispettive medie stima il coefficiente basato sulla variazione interna alle unità. Uno stimatore equivalente dei minimi quadrati con variabili dummy include un’intercetta per ciascuna unità, salvo una categoria di riferimento omessa, quando ciò è praticabile. Entrambi gli stimatori eliminano αi additivo e invariato nel tempo e producono lo stesso coefficiente a parità di specificazione.
L’ipotesi standard per il modello statico a effetti fissi è spesso l’esogeneità stretta: E[uit|Xi1,…,Xit,…,XiT,αi]=0 per ogni t. Richiede che ciascun disturbo uit abbia media zero condizionatamente all’intera storia dei regressori, compresi i valori futuri di X. In particolare, esclude meccanismi di retroazione in cui uno shock odierno modifica il regressore del periodo successivo; è più forte dell’esogeneità sequenziale talvolta impiegata nei modelli dinamici di serie storiche. La presenza di una variabile dipendente ritardata insieme agli effetti fissi crea ulteriori complicazioni nei panel brevi.
Effetti fissi delle unità e del tempo
L’aggiunta di λt corregge per shock o tendenze comuni che interessano tutte le unità. Una regressione a effetti fissi a due vie, con dummy delle unità e del tempo, è
In assenza di altri controlli, β confronta le variazioni interne alle unità con le corrispondenti variazioni nelle altre unità che contribuiscono all’identificazione della regressione. Gli effetti fissi a due vie possono essere un’utile strategia di controllo descrittivo, ma in presenza di adozione scaglionata delle politiche ed effetti dinamici eterogenei del trattamento, il coefficiente non coincide necessariamente con una media ponderata trasparente e convessa degli effetti del trattamento. Per questi disegni possono essere preferibili metodi moderni delle differenze nelle differenze.
Differenze nelle differenze
Con unità trattate e di controllo osservate prima e dopo una politica, lo stimatore DID di base è
L’ipotesi fondamentale delle tendenze parallele afferma che, in assenza di trattamento, le unità trattate e quelle di controllo avrebbero sperimentato la stessa variazione attesa dell’esito nel periodo di confronto. Questa ipotesi riguarda variazioni controfattuali non osservate; le tendenze precedenti alla politica possono fornire evidenze utili, ma non possono dimostrare logicamente l’ipotesi controfattuale per il periodo successivo alla politica.
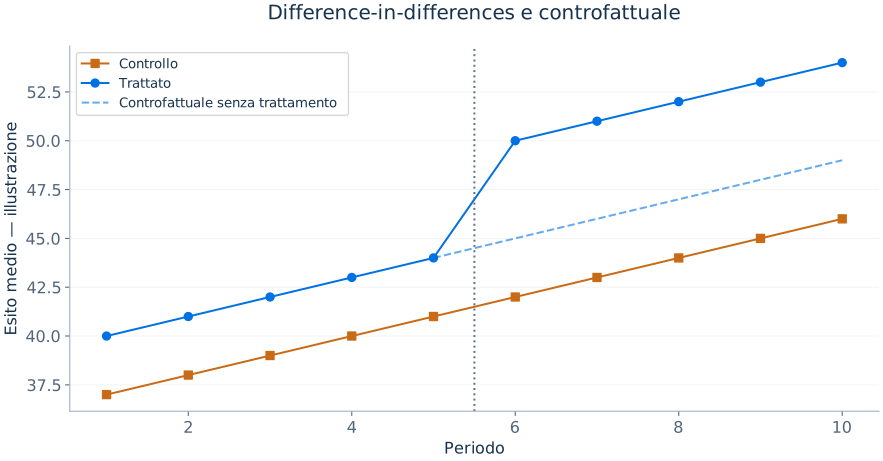
Effetti casuali ed effetti casuali correlati
Un modello convenzionale a effetti casuali considera l’effetto individuale incorrelato con le variabili esplicative, consentendo una combinazione ponderata delle informazioni interne alle unità e tra unità. Quando questa esogeneità è valida, RE può essere più efficiente di FE. Quando αi è correlato con X, il modello RE standard può essere inconsistente, mentre FE può restare consistente sotto le proprie ipotesi. Una specificazione a effetti casuali correlati, o di Mundlak, include le medie per unità dei regressori variabili nel tempo per modellare la dipendenza tra αi e X. Queste formulazioni possono collegare FE e RE e fornire parametri aggiuntivi significativi in determinati contesti.
La scelta del modello non si risolve esclusivamente mediante un test di Hausman applicato meccanicamente. Meritano attenzione le ipotesi, gli effetti di interesse, la rilevanza dei regressori invarianti nel tempo e la struttura dei raggruppamenti.
Correlazione seriale e inferenza per cluster
Le osservazioni della stessa unità nel tempo sono raramente indipendenti. Una regressione FE richiede normalmente errori standard raggruppati per unità, nell’ambito di un’approssimazione asintotica basata su un elevato numero di cluster e sotto ipotesi di indipendenza tra cluster. Se gli shock sono anche correlati tra unità nella stessa data, la dipendenza può richiedere ulteriori correzioni o una diversa strategia inferenziale. Spesso è possibile stimare modelli su panel non bilanciati, ma l’uscita dal campione collegata a esiti potenziali non osservati può influenzarne l’interpretazione.
library(fixest)
fe <- feols(y ~ x1 + x2 | firm_id + year, data = dat,
            vcov = ~ firm_id)
summary(fe)
# A DID specification when policy adopts at a common date:
did <- feols(y ~ treated:post | firm_id + year,
             data = dat, vcov = ~ firm_id)
summary(did)Un esempio della trasformazione a effetti fissi
Supponiamo di osservare due regioni per tre anni e che il ricercatore voglia stimare la relazione tra presenza della polizia e criminalità. La prima regione ha un livello di criminalità di base permanentemente più elevato a causa di condizioni storiche non misurate; la seconda ha un livello di base permanentemente più basso. Una regressione pooled può confondere queste differenze fisse con la presenza della polizia se anche le risorse delle forze dell’ordine sono sistematicamente maggiori nella prima regione. Gli effetti fissi regionali sottraggono dagli esiti e dai regressori la media di ciascuna regione, lasciando soltanto gli scostamenti interni a quella regione nel tempo.
Questa procedura non rende esogeno un aumento della presenza della polizia. Se una regione assume altri agenti in previsione di un’ondata di criminalità, la variazione interna alla regione può essere ancora correlata con lo shock imminente non osservato. Una fonte di identificazione più solida potrebbe essere una formula di finanziamento, uno shock predeterminato negli organici o un altro cambiamento di politica motivato dall’esterno. Gli effetti fissi rimuovono il confondimento fisso, non la risposta della politica alle condizioni economiche e sociali.
Raggruppamenti e informazione effettiva nei panel
Le osservazioni ripetute sulla stessa regione o impresa condividono influenze non osservate, perciò una regressione con migliaia di righe impresa-anno ma soltanto 20 imprese può contenere meno informazione indipendente di quanto suggerisca il numero grezzo di righe. Il livello di raggruppamento deve riflettere i meccanismi di assegnazione e degli shock. Se una riforma viene assegnata a livello regionale, raggruppare a livello del singolo lavoratore è normalmente inadeguato, perché la variazione del trattamento e gli shock condivisi si verificano a livello regionale. Se gli shock regionali e annuali presentano entrambi una dipendenza complessa, può essere necessaria un’inferenza più sofisticata.
Momento del trattamento, effetti per coorte e confronti nel tempo relativo
Sia Gi il primo periodo nel quale l’unità i riceve il trattamento. L’effetto gruppo-periodo ATT(g,t) confronta l’esito medio alla data t della coorte trattata per la prima volta in g con il suo esito controfattuale se fosse rimasta non trattata. Questo oggetto di stima permette all’effetto di variare tra coorti e con la durata dell’esposizione. L’identificazione richiede un’appropriata ipotesi di trend paralleli, assenza di anticipazione nella finestra specificata, adeguato supporto comune e un gruppo di confronto non trattato.
Per esempio, una coorte trattata nel 2023 può essere confrontata nel 2024 con unità ancora non trattate nel 2024, se queste forniscono un controfattuale credibile. Le unità trattate nel 2022 sono già esposte; usarle come controlli può sottrarre l’evoluzione dei loro effetti del trattamento. Gli stimatori per coorte e periodo rendono esplicito questo confronto prima dell’aggregazione. Il tempo relativo e=t−g misura la durata dall’adozione, mentre il tempo di calendario t colloca gli shock comuni. L’aggregazione deve dichiarare i pesi delle coorti e quali coorti restano osservate a ogni orizzonte. Il mancato rifiuto delle differenze anteriori al trattamento sostiene una verifica diagnostica limitata; non dimostra l’esistenza di trend controfattuali paralleli dopo il trattamento.
16. Contrazione dei coefficienti, Big Data e previsione regolarizzata
Ridge, Lasso, validazione incrociata e componenti principali
Previsione con numerosi regressori potenziali
Il numero dei predittori disponibili può diventare elevato rispetto al numero di osservazioni. Campagne pubblicitarie, acquisti dei consumatori e previsioni macroeconomiche possono essere descritti da centinaia di covariate e ritardi. Una regressione OLS non vincolata può adattarsi estremamente bene ai dati di addestramento e tuttavia produrre risultati scadenti fuori campione, perché i suoi coefficienti rispondono al rumore campionario. La regolarizzazione introduce deliberatamente una distorsione per ridurre la varianza e, potenzialmente, migliorare la previsione.
Un modello predittivo e un modello causale vengono giudicati con criteri differenti. Un predittore utile non deve necessariamente causare un esito: può essere semplicemente un segnale anticipatore o correlato. Per esempio, le ricerche sul web possono aiutare a prevedere le vendite senza essere una determinante del consumo su cui sia possibile intervenire. Una stima causale ben progettata richiede invece un confronto controfattuale difendibile, spesso con un insieme di variabili di controllo strutturato con attenzione.
Il compromesso tra distorsione e varianza
Per una nuova osservazione con covariate X0, una stima predittiva ŷ(X0) presenta, sotto un opportuno condizionamento, un errore quadratico medio composto dal quadrato della distorsione, dalla varianza e dal rumore irriducibile dell’esito. Aumentare la flessibilità del modello può ridurre la distorsione di approssimazione, ma accrescere la varianza di stima. Un modello molto complicato può catturare schemi specifici del campione di addestramento che non si ripresentano nelle nuove osservazioni. La contrazione dei coefficienti mira a controllare questo compromesso.
Regressione ridge
La regressione ridge minimizza la funzione di perdita OLS aggiungendo una penalizzazione basata sui coefficienti al quadrato:
L’intercetta viene normalmente lasciata senza penalizzazione e le variabili esplicative vengono standardizzate prima della stima. Il parametro di regolazione λ≥0 controlla l’intensità della contrazione: λ=0 restituisce OLS in presenza di rango pieno; valori più elevati di λ spostano i coefficienti verso zero. Per X e Y centrati, la forma matriciale è β̂ʳⁱᵈᵍᵉ=(X′X+λI)-1X′y. Ridge stabilizza specificazioni quasi collineari, ma normalmente non rende singoli coefficienti esattamente uguali a zero.
Lasso e modelli sparsi
Lasso sostituisce la penalizzazione quadratica con la penalizzazione dei valori assoluti Σ|βj|, permettendo di selezionare le variabili mediante coefficienti esattamente nulli. Quando un numero relativamente piccolo di predittori contiene la maggior parte del segnale utile, Lasso può fornire un modello di previsione compatto. Non è automaticamente superiore a ridge: blocchi di variabili predittive altamente correlate possono portare a una selezione instabile, mentre ridge può distribuire il peso dei coefficienti in modo più uniforme. Elastic net combina penalizzazioni L1 e L2 e può essere utile in presenza di numerosi predittori correlati.
Il parametro di regolazione non viene stimato a partire dalle normali statistiche t di OLS. Viene comunemente scelto per minimizzare la perdita predittiva nella validazione incrociata. Scegliere sia le trasformazioni delle variabili sia la penalizzazione controllando ripetutamente lo stesso campione di test contamina la valutazione. Un vero insieme di dati tenuto da parte deve rimanere inutilizzato fino alla valutazione finale.
Validazione incrociata a K gruppi
Si divide il campione di addestramento in K gruppi. Per ogni valore candidato di λ, si stima il modello su K−1 gruppi e si prevedono le osservazioni del gruppo escluso. Si calcola la media delle perdite sui gruppi esclusi e si sceglie una penalizzazione con prestazioni soddisfacenti nella validazione incrociata. Infine, si ristima il modello sull’intero campione di addestramento e lo si valuta una sola volta su un insieme di test mai utilizzato. Una validazione annidata o una fase separata di validazione può essere utile quando si confrontano molti iperparametri e famiglie di modelli.
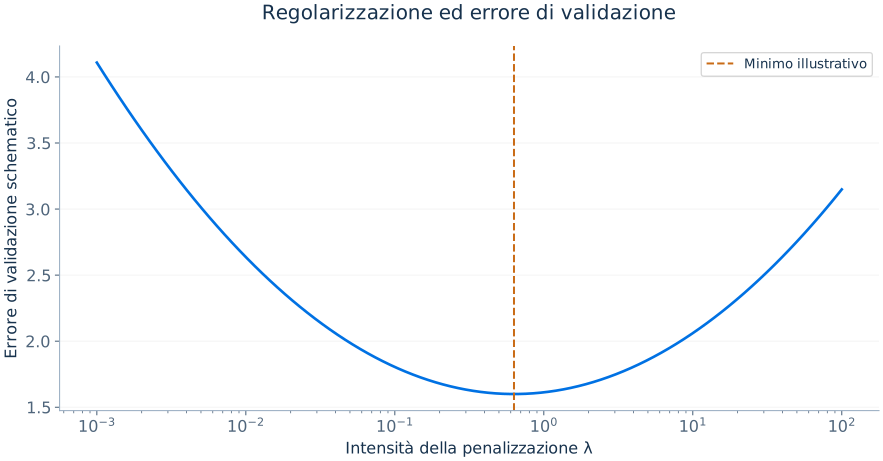
Componenti principali
L’analisi delle componenti principali trasforma un vettore di regressori correlati in combinazioni lineari ortogonali, ordinate in base alla quantità di varianza dei predittori che spiegano. Se la matrice dei dati standardizzati è X, le direzioni delle componenti principali risolvono un problema di autovettori per X′X o per la corrispondente matrice di covarianza. Un modello predittivo può regredire Y su un numero limitato delle prime componenti. Questo può ridurre la dimensionalità, ma le componenti che spiegano la maggior parte della variabilità di X non spiegano necessariamente la maggior parte di quella di Y: il numero di componenti va quindi scelto in funzione del compito predittivo.
Previsione di serie storiche con numerosi predittori
La previsione macroeconomica può impiegare molte serie correlate, come occupazione, fiducia, produzione, prezzi e indicatori finanziari. I modelli a fattori dinamici assumono che gran parte della loro variabilità congiunta rifletta un numero minore di fattori latenti. Le previsioni basate su fattori possono ridurre la complessità della stima sfruttando un insieme informativo più ampio, ma le revisioni dei dati, i cambiamenti delle relazioni e l’uso improprio di informazioni future complicano la valutazione.
Una semplice implementazione in R
Il seguente esempio schematico presuppone dati completi e predittori numerici con nomi e ordine identici in train e test. Per impostazione predefinita, glmnet standardizza internamente i predittori. In presenza di fattori, la matrice di test va costruita usando i termini, i livelli dei fattori e i contrasti definiti nel campione di addestramento, verificando poi che le colonne siano identiche; due chiamate separate a model.matrix non garantiscono da sole una codifica compatibile. Per confrontare ridge e Lasso si usano le stesse partizioni prestabilite, escludendo gli esiti del campione di test da qualsiasi decisione di taratura.
library(glmnet)
X <- model.matrix(y ~ . - 1, data = train)
y <- train$y
set.seed(2026)
fold_id <- sample(rep(seq_len(10), length.out = nrow(X)))
ridge <- cv.glmnet(X, y, alpha = 0, foldid = fold_id)
lasso <- cv.glmnet(X, y, alpha = 1, foldid = fold_id)
coef(lasso, s = "lambda.min")
newX <- model.matrix(y ~ . - 1, data = test)
stopifnot(identical(colnames(X), colnames(newX)))
pred <- as.numeric(predict(lasso, newx = newX, s = "lambda.min"))
sqrt(mean((test$y - pred)^2))Contrazione ridge e valori singolari
Sia X=UΣV′ la scomposizione ai valori singolari della matrice dei regressori centrata. I minimi quadrati ordinari, nelle sue direzioni principali, moltiplicano le componenti dell’esito per il reciproco dei valori singolari. Quando un valore singolare è molto piccolo, minime oscillazioni dell’esito possono generare grandi variazioni dei coefficienti. Ridge modifica il contributo sostituendo la ponderazione inversa instabile con i fattori σj/(σj2+λ), attenuando le direzioni con scarsa variabilità dei predittori. Questo spiega perché ridge funziona spesso bene con indicatori economici collineari.
La penalizzazione λ deve essere scelta sui dati di addestramento e la valutazione del modello deve utilizzare osservazioni realmente nuove. L’inferenza sui singoli coefficienti ridge o Lasso non si ottiene leggendo le normali statistiche t di OLS da un modello selezionato: la distorsione introdotta dalla regolarizzazione e la fase di selezione richiedono metodi specifici.
Scegliere gli strumenti di previsione per un compito specifico
Usa OLS semplice quando i predittori sono pochi, le relazioni sono approssimativamente lineari e l’estrapolazione o l’interpretazione sono importanti. Considera ridge quando molti predittori sono correlati e la previsione conta più della selezione delle variabili. Considera Lasso quando è plausibile una rappresentazione predittiva sparsa e una specificazione compatta è utile. Le componenti principali possono aiutare quando molti indicatori condividono pochi fattori latenti; i modelli a fattori dinamici estendono questa intuizione ai panel macroeconomici con dipendenza temporale.
17. Ragionamento sperimentale e quasi sperimentale
Identificazione controfattuale, LATE, abbinamento e discontinuità nella regressione
Ragionare a partire dal disegno di ricerca
La sfida centrale dell’econometria applicata non è calcolare un coefficiente di regressione, ma costruire un confronto credibile. In un esperimento controllato randomizzato ideale, l’assegnazione al trattamento è indipendente dagli esiti potenziali. Negli studi osservazionali, i ricercatori cercano circostanze in cui il trattamento cambia per ragioni plausibilmente estranee alle determinanti non osservate dell’esito. Individuare questa variazione può dipendere da una norma, una soglia istituzionale, un evento naturale o un calendario di attuazione di una politica; ogni fonte presenta proprie ipotesi e minacce alla validità.
Gli oggetti rilevanti devono essere denominati con precisione: l’effetto medio del trattamento nel campione (SATE) si riferisce al campione effettivamente osservato nello studio; l’ATE di popolazione è una media riferita alla popolazione; ATT riguarda i trattati; e IV può identificare LATE per i compliers, cioè coloro la cui partecipazione viene modificata dallo strumento. Questi parametri differiscono quando gli effetti variano tra persone, intensità del trattamento o condizioni iniziali. I ricercatori non devono considerare ogni stima come un effetto universale del trattamento.
Esperimenti randomizzati e intenzione al trattamento
Con assegnazione casuale Z a un programma, l’effetto dell’intenzione al trattamento è la differenza nelle medie degli esiti in base all’assegnazione:
Misura l’effetto dell’offerta o dell’assegnazione del trattamento, indipendentemente dall’effettiva partecipazione, assumendo che l’esperimento sia stato condotto correttamente e gli esiti siano misurati in modo appropriato. Se l’assegnazione modifica la partecipazione D ma non tutti aderiscono, il rapporto di Wald tra l’ITT di Y e l’ITT di D può identificare LATE sotto le consuete ipotesi aggiuntive: assegnazione casuale, esclusione, rilevanza e monotonicità. L’ITT e l’effetto di ricevere il trattamento rispondono a domande diverse e devono essere presentati di conseguenza.
Gli esperimenti possono essere distorti da abbandono selettivo del campione, contaminazione del trattamento, effetti su altre unità e deviazioni dal protocollo assegnato. La randomizzazione affronta il confondimento iniziale in media; non rende affidabili esiti successivi al trattamento misurati male e non garantisce che i risultati siano trasferibili a un altro paese.
Abbinamento, aggiustamento mediante regressione e sovrapposizione
Se il trattamento è condizionatamente indipendente dagli esiti potenziali date le X osservate prima del trattamento e vale la condizione di sovrapposizione, le unità trattate e non trattate possono essere confrontate all’interno di strati sufficientemente simili delle variabili di controllo. I metodi di abbinamento costruiscono confronti basati su caratteristiche osservate o su un punteggio di propensione e(X)=P(D=1|X). L’aggiustamento mediante regressione modella gli esiti attesi condizionatamente ai controlli e allo stato di trattamento. La ponderazione mediante probabilità inversa ripondera le osservazioni in base alla propensione al trattamento.
Abbinamento e regressione non producono da soli validità causale. Entrambi dipendono dall’ipotesi che i controlli osservati eliminino la distorsione da selezione e richiedono attenzione alla mancanza di sovrapposizione, alla specificazione errata del modello e alla misurazione imprecisa. La ponderazione può diventare instabile quando i punteggi di propensione si avvicinano a zero o a uno. Prima di stimare un modello, verifica quali combinazioni di covariate compaiono in entrambi i gruppi e se i confronti controfattuali impliciti sono credibili.
Disegni di discontinuità nella regressione
Un disegno di discontinuità nella regressione (RD) sfrutta una regola di assegnazione che cambia in corrispondenza di una soglia nota c di una variabile di assegnazione R. In una RD netta, o sharp RD, il trattamento cambia deterministicamente in c, perciò l’effetto causale alla soglia è identificato dalla discontinuità nell’aspettativa condizionata:
L’ipotesi cruciale è la continuità delle aspettative degli esiti potenziali rispetto alla variabile di assegnazione in corrispondenza della soglia, in assenza di trattamento. Le unità immediatamente ai due lati devono essere comparabili salvo che per il trattamento. La stima utilizza normalmente metodi polinomiali locali in un intorno di c, una scelta dell’ampiezza della finestra e procedure inferenziali adatte al disegno locale. Una regressione polinomiale globale di ordine elevato è generalmente un cattivo sostituto di un’analisi locale accurata.
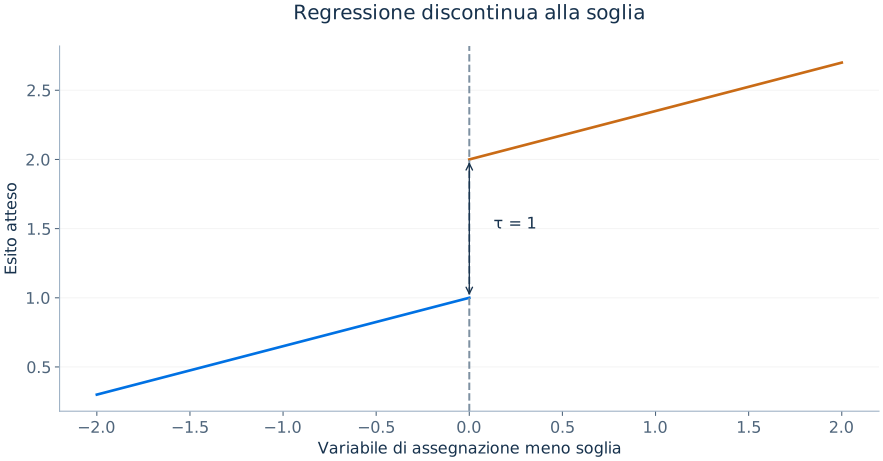
In una RD sfumata, o fuzzy RD, la probabilità di trattamento presenta un salto alla soglia senza passare perfettamente da zero a uno. Il salto negli esiti viene diviso per il corrispondente salto nella probabilità di trattamento, rendendo la fuzzy RD un disegno locale a variabili strumentali. La manipolazione o il posizionamento strategico attorno alla soglia, altre soglie di politiche concomitanti e covariate iniziali discontinue minacciano la validità del disegno.
Un nuovo sguardo alle differenze nelle differenze
Una politica adottata in una regione ma non in un’altra può creare un esperimento naturale se gli esiti potenziali in assenza di trattamento seguono tendenze comparabili. DID sottrae la variazione della regione di confronto da quella della regione trattata, eliminando, nell’impostazione di base, le differenze fisse tra gruppi e gli shock temporali comuni. Un modello di studio di evento può stimare effetti relativi prima e dopo il trattamento, ma la sua interpretazione richiede una gestione appropriata dell’eterogeneità degli effetti del trattamento e l’assenza di risposte anticipatorie differenziali.
Quando l’adozione del trattamento varia tra periodi e gruppi, i normali effetti fissi a due vie possono produrre medie ponderate fuorvianti in presenza di effetti eterogenei. Gli stimatori progettati per confrontare unità appena trattate con controlli appropriati non trattati o non ancora trattati possono fornire parametri di interesse più trasparenti.
Diagnostica del disegno e interpretazione rigorosa
Ogni strategia di identificazione attribuisce un ruolo distinto alla diagnostica empirica: bilanciamento e abbandono del campione negli esperimenti; sovrapposizione e bilanciamento delle covariate nell’abbinamento; evidenze sulle tendenze precedenti alla politica in DID; continuità della densità e delle covariate alla soglia in RD; forza del primo stadio e argomentazioni a sostegno dell’esclusione in IV. Nessuno di questi controlli dimostra tutte le ipotesi causali; il loro valore consiste nell’escludere specifiche violazioni plausibili e nel rendere trasparenti i limiti dello studio.
Un rapporto di ricerca utile collega: domanda di ricerca → parametro di interesse → confronto identificante → metodo di stima → errore standard → interpretazione economica → limiti. Stimatori sofisticati non possono sostituire questa sequenza.
18. Econometria applicata con R
Un flusso di lavoro riproducibile dai dati grezzi a tabelle di regressione difendibili
Riproducibilità e percorso di analisi
L’econometria applicata è una disciplina computazionale. Risultati affidabili richiedono più di un singolo comando di regressione eseguito correttamente: devono essere documentate le origini dei dati, le trasformazioni, le decisioni sui valori mancanti, la costruzione del campione, le formule dei modelli e lo stimatore degli errori standard scelto. Uno script riproducibile deve partire dagli stessi file di dati grezzi, eseguire esplicitamente tutte le trasformazioni di pulizia e ricreare stime, grafici diagnostici e tabelle finali senza modifiche manuali.
R è un ambiente di programmazione open source per l’analisi dei dati. Il flusso di lavoro consueto utilizza un editor di script come RStudio, importazioni di file CSV o di altri dati, oggetti contenenti data frame e modelli, e pacchetti per l’inferenza o la visualizzazione. Il comando di modellazione di base lm stima OLS. La formula y ~ x1 + x2 include un’intercetta per impostazione predefinita; y ~ x1 + x2 - 1 la rimuove. La sintassi non deve mai essere confusa con l’identificazione: la formula del modello codifica le variabili, non stabilisce se i loro coefficienti ammettano interpretazioni causali.
Un progetto riproducibile minimo
Lo script seguente utilizza un campione esplicitamente sintetico. Serve a mostrare il funzionamento del software, non a riprodurre i coefficienti di uno specifico insieme di dati empirici di un manuale. Poiché il seme casuale è fissato, l’esecuzione del codice su un’installazione compatibile dovrebbe riprodurre le stesse osservazioni generate.
set.seed(2026)
n <- 500
education <- round(pmin(20, pmax(8, rnorm(n, 13, 2))))
experience <- runif(n, 0, 30)
ability <- rnorm(n)
logwage <- 1.6 + 0.07 * education + 0.02 * experience +
           0.12 * ability + rnorm(n, sd = 0.30)
dat <- data.frame(education, experience, ability, logwage)
summary(dat)
plot(dat$education, dat$logwage, pch = 19, cex = .5,
     xlab = "Years of education", ylab = "Log wages")
In questo processo generatore dei dati, il coefficiente strutturale condizionato dell’istruzione è 0.07 quando si includono abilità ed esperienza. Modificare la simulazione in modo che l’abilità influenzi anche l’istruzione genererebbe una distorsione da variabile omessa in una regressione basata soltanto sull’istruzione. Gli esempi simulati sono utili perché il ricercatore conosce la verità e può valutare il comportamento della stima, invece di cercare di dedurlo dai risultati del modello stimato.
Regressione semplice e regressione multipla
m1 <- lm(logwage ~ education, data = dat)
m2 <- lm(logwage ~ education + experience + ability, data = dat)
summary(m1)
summary(m2)
confint(m2)
Confronta i coefficienti dell’istruzione, la scala stimata dei residui e gli intervalli di confidenza. La discrepanza tra i coefficienti semplici e multipli mostra come l’aggiustamento modifichi i confronti condizionati; non dimostra automaticamente la direzione o l’entità del confondimento omesso in un altro insieme di dati osservazionali. Modifica poi la simulazione in modo che l’istruzione dipenda dall’abilità e valuta come cambiano le stime su campioni ripetuti.
Trasformazioni e interazioni
m3 <- lm(logwage ~ education + experience + I(experience^2), data = dat)
m4 <- lm(logwage ~ education * ability + experience, data = dat)
summary(m3)
summary(m4)
# Marginal effect of experience at a selected experience level:
b <- coef(m3)
me_exp_10 <- b["experience"] + 2 * b["I(experience^2)"] * 10
print(me_exp_10)
L’operatore I() di R tratta un’espressione matematica come un unico predittore trasformato, mentre x1 * x2 si espande negli effetti principali e nell’interazione (x1 + x2 + x1:x2). Una stima dell’effetto marginale è una funzione di più coefficienti; calcolane l’incertezza con la matrice di covarianza del modello, anziché trattare le componenti come indipendenti.
Inferenza robusta e per cluster
library(lmtest)
library(sandwich)
coeftest(m2, vcov. = vcovHC(m2, type = "HC3"))
# For genuine clustered data with independent clusters:
# coeftest(m2, vcov. = vcovCL(m2, cluster = dat$cluster_id))
La stima HC3 modifica gli errori standard stimati e le statistiche dei test, non i coefficienti OLS. I metodi basati su cluster richiedono un identificativo di raggruppamento effettivo e una struttura campionaria che giustifichi l’inferenza asintotica per cluster. Inventare un identificativo di cluster soltanto per ottenere errori standard diversi non avrebbe alcuna giustificazione statistica.
Restrizioni lineari generali
Il pacchetto car offre comodi test di Wald basati sulla matrice di covarianza fornita. Quando si verificano congiuntamente più restrizioni in presenza di eteroschedasticità, è importante richiedere una matrice di covarianza robusta, anziché affidarsi implicitamente alla tabella ANOVA classica della regressione.
library(car)
linearHypothesis(m2, c("education = 0", "experience = 0"),
                 vcov. = vcovHC(m2, type = "HC3"))
Variabili strumentali
Per un’analisi IV effettiva, esplicita perché lo strumento escluso influenza il regressore endogeno e perché non può influenzare l’esito attraverso altri canali. La notazione delle formule R in ivreg() separa la regressione strutturale dall’insieme degli strumenti mediante |. L’insieme degli strumenti contiene gli strumenti esclusi e tutti i controlli esogeni inclusi.
library(AER)
# Illustrative schema: z is an externally justified instrument for d
iv_fit <- ivreg(y ~ d + income + age | z + income + age,
                data = empirical_data)
summary(iv_fit, diagnostics = TRUE)
coeftest(iv_fit, vcov. = vcovHC(iv_fit, type = "HC1"))
Questo secondo schema è intenzionalmente non eseguibile finché l’analista non fornisce un vero data frame con definizioni motivate delle variabili. Eseguire una regressione senza uno strumento credibile non produce una stima causale significativa.
Modelli panel
Il pacchetto fixest consente una stima concisa degli effetti fissi delle unità e del tempo. Una barra verticale all’interno di feols separa i regressori dalle dimensioni degli effetti fissi. Raggruppare per unità permette una dipendenza flessibile dei residui all’interno di ciascuna unità, sotto le corrispondenti ipotesi.
library(fixest)
model_fe <- feols(outcome ~ policy + control1 | region + year,
                  vcov = ~ region, data = panel_dat)
etable(model_fe)
Se il trattamento varia per regione e anno, interpreta il coefficiente alla luce del meccanismo di assegnazione e verifica se un normale parametro FE rappresenta il parametro causale desiderato. Quando la domanda di ricerca riguarda DID con trattamento scaglionato, possono servire stimatori dedicati, anziché aggiungere semplicemente altri effetti fissi.
Diagnostica dei modelli e grafici
par(mfrow = c(2, 2))
plot(m2)
par(mfrow = c(1, 1))
# Save a reproducible data summary:
capture.output(summary(dat), file = "descriptive_summary.txt")
La suite diagnostica di base di R include grafici dei residui rispetto ai valori stimati, Q–Q, di scala-posizione e relativi alla leva statistica. Un grafico residui-valori stimati può rivelare non linearità ed eteroschedasticità. Gli scostamenti dal grafico Q–Q normale meritano attenzione per l’inferenza esatta nei piccoli campioni, ma non invalidano automaticamente una regressione robusta su un grande campione. Le osservazioni influenti richiedono un esame sostanziale, anziché un’eliminazione automatica.
Presentare i risultati numerici senza affermazioni eccessive
Una buona tabella empirica indica la variabile dipendente, il metodo di stima, gli errori standard, compreso il loro livello di raggruppamento, il numero di osservazioni, gli effetti fissi, i controlli importanti e il campione di stima. Accompagna ciascun coefficiente principale con un’interpretazione che specifichi correttamente le unità di misura e con una discussione dell’identificazione causale. Per i modelli con interazioni e logaritmi, converti i coefficienti in effetti marginali su scale significative. Specifica la popolazione e il periodo temporale e indica dove dati o metodi limitano la generalizzabilità.
| Fase | Azione essenziale | Domanda diagnostica |
|---|---|---|
| Dati | Esaminare, pulire, trasformare | Le unità di misura e i valori mancanti sono compresi? |
| Disegno | Definire il parametro di interesse e i controlli | La variazione è plausibilmente esogena? |
| Stima | Scegliere OLS, IV, FE o un altro metodo | Il metodo mira al parametro dichiarato? |
| Inferenza | Scegliere una covarianza robusta o per cluster | Le osservazioni sono statisticamente indipendenti? |
| Validazione | Verificare specificazione e sensibilità | Le ipotesi potrebbero essere violate? |
| Comunicazione | Presentare coefficiente, incertezza e ambito di validità | Che cosa può effettivamente dimostrare il risultato? |
Un campione di stima coerente e un processo di previsione riproducibile
Prima di confrontare specificazioni, si definisce la chiave identificativa delle osservazioni e se ne verifica l’univocità. Un panel impresa-anno dovrebbe avere un solo record previsto per ciascuna coppia impresa-anno; un’unione molti-a-molti può moltiplicare silenziosamente le osservazioni, distorcendo sia i coefficienti sia gli errori standard. Vanno documentati le unità, l’intervallo temporale, la definizione dell’esito, i valori mancanti per variabile e tutte le restrizioni del campione. Un coefficiente può cambiare dopo l’aggiunta di un controllo perché il modello usa ora un campione diverso: per isolare il ruolo dell’aggiustamento, si confrontano le specificazioni annidate sullo stesso campione.
Per la previsione, i dati si suddividono in campioni di addestramento, validazione e test coerenti con il contesto di impiego. Le regole di imputazione, il ridimensionamento, la selezione delle caratteristiche e le trasformazioni apprese si stimano soltanto sui dati di addestramento, applicando poi le regole stimate ai dati tenuti separati. Si preservano i livelli dei fattori, i contrasti, i nomi e l’ordine delle colonne definiti nell’addestramento. Le osservazioni ripetute della stessa unità devono restare insieme quando l’obiettivo è prevedere unità mai osservate, e le date future devono restare escluse dalle partizioni usate per previsioni anteriori. Si salvano il seme casuale, le versioni dei pacchetti, la formula del modello, gli oggetti di preparazione dei dati e la numerosità finale del campione. Queste informazioni rendono il risultato riproducibile; non sostituiscono un’argomentazione difendibile di identificazione.
| Controllo | Perché conta |
|---|---|
| Chiavi univoche delle osservazioni | Evita la moltiplicazione accidentale delle righe dopo le unioni |
| Campione di stima comune | Distingue le variazioni dei controlli dalle variazioni delle osservazioni |
| Preparazione stimata soltanto sui dati di addestramento | Evita che informazioni degli esiti o delle covariate tenuti separati entrino nella stima |
| Colonne corrispondenti della matrice del modello | Preserva il significato e l’ordine dei coefficienti stimati |
| Seme casuale e versioni dei pacchetti salvati | Rende tracciabili i passaggi stocastici e dipendenti dal software |
19. Strumenti matematici e problemi svolti
Derivazioni essenziali, esercizi numerici e soluzioni spiegate integralmente
Sommatorie e identità matriciali
In econometria, Σi indica la sommatoria sulle unità osservate. Un vettore è una raccolta ordinata di valori, una matrice è una disposizione rettangolare e la trasposta X′ scambia righe e colonne. L’inversa (X′X)-1 esiste soltanto quando X′X ha rango pieno. In OLS, i valori stimati sono proiezioni ortogonali, quindi Px=Px′ e Px2=Px; questa idempotenza spiega molte identità algebriche dei minimi quadrati.
Per normali variabili scalari con momenti finiti, la covarianza è Cov(X,Y)=E[XY]−E[X]E[Y]. Il coefficiente della regressione semplice di popolazione che minimizza E[(Y−a−bX)2] è Cov(X,Y)/Var(X) quando Var(X)>0. Il numeratore determina la direzione e il denominatore riscalibra la variabilità di X. L’aspettativa condizionata E[Y|X] minimizza E[(Y−g(X))2] rispetto a tutte le funzioni misurabili g con opportuni momenti secondi finiti; la regressione lineare limita g a una classe lineare.
Derivazione della formula OLS nella regressione semplice
Si parte da S(a,b)=Σ(Yi−a−bXi)2. La condizione del primo ordine rispetto ad a è −2Σ(Yi−a−bXi)=0. Dividendo per n si ottiene Ȳ−a−bX̄=0, quindi a=Ȳ−bX̄. La condizione del primo ordine rispetto a b è −2ΣXi(Yi−a−bXi)=0. Sostituendo ad a l’espressione precedente, sviluppando le variabili centrate e riordinando, si ottiene b=Σ(Xi−X̄)(Yi−Ȳ)/Σ(Xi−X̄)2. La derivata seconda rispetto al coefficiente angolare è positiva se i valori di X non sono tutti uguali, garantendo un minimo unico.
Derivazione della varianza di una combinazione lineare di due variabili
Per costanti a e b e variabili casuali X e Z,
Si sviluppa lo scarto dalla media al quadrato e si utilizza la linearità dell’aspettativa. Questa identità ricorre spesso in econometria: l’errore standard di una combinazione lineare di coefficienti di regressione, l’effetto previsto di un’interazione e la varianza di un portafoglio dipendono tutti dai termini di covarianza. Assumere che i coefficienti siano incorrelati senza controllare la matrice varianza-covarianza è un errore comune.
Derivazione della varianza asintotica di OLS
Partendo da β̂−β=[(1/n)ΣXiXi′]-1(1/n)ΣXiui, si moltiplica per √n. Sotto condizioni di regolarità, la matrice dei regressori converge a Q e la media degli score soddisfa un teorema centrale del limite multivariato, (1/√n)ΣXiui→ᵈN(0,Ω). Il teorema di Slutsky fornisce √n(β̂−β)→ᵈN(0,Q-1ΩQ-1). Il risultato chiarisce sia perché gli errori standard diminuiscono tipicamente al tasso 1/√n, sia perché l’eteroschedasticità influenza Ω. Chiarisce inoltre che una formula di varianza asintotica non implica non distorsione nei campioni finiti.
Esercizio svolto: una retta di regressione stimata
Problema. Si osservano X=(0,1,2,3) e Y=(1,2,2,5). Calcola β̂1 e β̂0, i residui e R2.
Soluzione. X̄=1.5 e Ȳ=2.5. La somma dei prodotti incrociati centrati è (−1.5)(−1.5)+(−0.5)(−0.5)+(0.5)(−0.5)+(1.5)(2.5)=6.0. La somma dei quadrati degli scarti di X è 5, quindi β̂1=1.2 e β̂0=0.7. I valori stimati sono (0.7,1.9,3.1,4.3) e i residui (0.3,0.1,−1.1,0.7). RSS=0.09+0.01+1.21+0.49=1.8. TSS=2.25+0.25+0.25+6.25=9, da cui R2=1−1.8/9=0.80. La somma dei residui è zero, come previsto per OLS con intercetta.
Esercizio svolto: un’ipotesi congiunta
Problema. Un modello non vincolato ha RSSu=120 con n=100 osservazioni e k=4 regressori diversi dalla costante. Un modello vincolato impone q=2 restrizioni e ha RSSr=144. Calcola la statistica F parziale convenzionale.
Soluzione. I gradi di libertà residui del modello non vincolato sono 100−4−1=95. Il peggioramento dell’adattamento per restrizione è (144−120)/2=12, mentre il quadrato medio residuo del modello non vincolato è 120/95=1.2632. Pertanto F=12/1.2632=9.50, da confrontare con il valore critico pertinente di F(2,95) sotto le ipotesi classiche. In presenza di eteroschedasticità, questa distribuzione di riferimento basata su RSS può essere inappropriata; è necessario un test di Wald robusto.
Esercizio svolto: interpretare una specificazione log-livello
Problema. Una regressione stimata fornisce ln(wage)=1.8+0.06education. Stima il rapporto esatto tra i salari previsti corrispondente a tre anni aggiuntivi di istruzione.
Soluzione. La variazione del logaritmo naturale del salario stimato è 3×0,06=0,18. Il rapporto tra i valori esponenziati dei logaritmi salariali stimati è exp(0,18)≈1,1972, ossia una differenza del 19,72%; l’approssimazione del primo ordine è il 18%. Quando la media condizionale del logaritmo è correttamente specificata, si tratta di un rapporto tra medie geometriche condizionali. Rappresenta anche il rapporto tra medie aritmetiche condizionali soltanto se il fattore di ritrasformazione E[exp(u)|education] rimane invariato nel confronto. L’interpretazione causale richiede inoltre esogeneità, che l’equazione stimata non dimostra.
Esercizio svolto: distorsione da variabile omessa
Problema. Il vero modello è Y=β0+2X+3Z+u e Cov(X,Z)/Var(X)=−0.4. Trova il coefficiente di popolazione di una regressione semplice che omette Z.
Soluzione. β̃1=2+3(−0.4)=0.8. Il coefficiente osservato sottostima l’effetto diretto di X, perché il fattore omesso aumenta Y e tende al contempo a essere più basso nelle osservazioni con X maggiore. L’analisi dei segni deve precedere i calcoli: un effetto omesso positivo moltiplicato per un’associazione negativa tra X e Z produce una distorsione negativa.
Esercizio svolto: selezione nel trattamento
Problema. Gli esiti medi dei trattati e dei non trattati sono 18 e 15. La popolazione trattata avrebbe avuto una media di 16 in assenza di trattamento. Calcola ATT e distorsione da selezione.
Soluzione. ATT=18−16=2. Distorsione da selezione=16−15=1. La differenza osservata di 3 è uguale a 2+1. Interpretare la differenza grezza come causale sovrastima ATT del 50% in questo esempio.
Esercizio svolto: un rapporto IV
Problema. L’offerta di un programma assegnata casualmente aumenta la partecipazione alla formazione di 0.20 e il reddito medio annuo di €360. Sotto le ipotesi di rilevanza, esclusione, monotonicità e assegnazione casuale, interpreta lo stimatore di Wald.
Soluzione. La stima IV è 360/0.20=€1,800. Sotto queste ipotesi e con una definizione appropriata del trattamento, identifica un effetto medio della formazione effettiva per i compliers, il cui stato di trattamento viene modificato dall’offerta. Non stima direttamente l’effetto per chi partecipa sempre, per chi non partecipa mai o per l’intera popolazione ammissibile, salvo che valgano ipotesi più forti di omogeneità.
Esercizio svolto: differenze prime nei panel
Problema. Tre imprese presentano (X1,Y1)=(1,5),(2,9),(4,12) e (X2,Y2)=(2,7),(4,12),(5,13). Calcola le variazioni osservate e spiega perché regredire ΔY su ΔX può essere utile.
Soluzione. ΔX=(1,2,1) e ΔY=(2,3,1). Se il modello contiene un effetto d’impresa additivo invariato nel tempo, tale effetto non osservato scompare quando si differenziano esiti e regressori. Una regressione sulle variazioni utilizza quindi informazioni interne alle imprese anziché confronti tra imprese, ma un’interpretazione causale richiede ancora che ΔX sia sufficientemente esogeno rispetto a Δu.
Esercizio svolto: il termine di covarianza omesso
Problema. Una stima con interazione presenta β̂1=2, β̂3=0.5, Var(β̂1)=0.16, Var(β̂3)=0.01 e Cov(β̂1,β̂3)=−0.02. Trova l’effetto stimato del trattamento e l’errore standard per X=3.
Soluzione. L’effetto è 2+3×0.5=3.5. La sua varianza è 0.16+9×0.01+2×3×(−0.02)=0.13, quindi SE≈0.3606. Ignorare la covarianza negativa produrrebbe invece √0.25=0.5 e sovrastimerebbe in misura rilevante l’incertezza di questo specifico confronto.
Ulteriori esercizi guidati
Esercizio A. Dimostra perché la media campionaria dei residui OLS è zero quando è inclusa un’intercetta. Risposta. La condizione del primo ordine per l’intercetta è Σûi=0; basta dividere per n. Esercizio B. Mostra che la multicollinearità non distorce di per sé OLS sotto l’ipotesi di media condizionata nulla. Risposta. L’aspettativa condizionata E[β̂−β|X]=(X′X)-1X′E[u|X]=0 ogni volta che la matrice è invertibile; la collinearità influenza quell’inversa e quindi la precisione.
Esercizio C. Spiega perché un effetto positivo del primo stadio e una forma ridotta negativa implicano un coefficiente IV negativo in un modello esattamente identificato. Risposta. Il loro rapporto è negativo; l’argomentazione sull’esclusione rimane necessaria per un’interpretazione causale. Esercizio D. Spiega perché la validazione incrociata predittiva non dimostra l’esclusione dello strumento IV. Risposta. Un modello può prevedere accuratamente D o Y mentre il suo strumento modifica Y attraverso un canale causale indipendente; la previsione verifica un’ipotesi diversa da quella rilevante.
Esercizio E. Una passeggiata aleatoria Yt=Yt₋1+εt parte da Y0=0 con innovazioni i.i.d. di varianza σ2. Risposta. Yt=Σs₌1ᵗ εs e Var(Yt)=tσ2, quindi la varianza aumenta con t e il processo è non stazionario. Esercizio F. Spiega perché gli effetti fissi delle unità non possono stimare separatamente il coefficiente di una variabile costante nel tempo all’interno di ciascuna unità. Risposta. Questa variabile scompare dopo la trasformazione within ed è collineare con le dummy delle unità.
Lista di controllo per valutare un’affermazione empirica
Enuncia la domanda sostanziale e il parametro numerico di interesse. Distingui l’esito, il trattamento o regressore principale, i controlli inclusi e le determinanti non osservate. Verifica unità di misura, costruzione del campione, valori mancanti e dipendenza. Scrivi esplicitamente l’ipotesi di identificazione e argomenta perché potrebbe essere valida. Controlla se lo stimatore scelto mira al parametro di interesse e se gli errori standard riflettono la struttura campionaria. Calcola e comunica l’incertezza, spiega le grandezze economicamente significative, considera la sensibilità e dichiara i limiti. Se l’argomentazione di identificazione non regge, presenta i risultati in modo descrittivo invece di attribuire loro un’interpretazione causale ingiustificata.
Formulario e notazione
| Simbolo | Significato | Interpretazione |
|---|---|---|
| Y, y | Variabile di esito | Risposta economica da spiegare |
| X, x | Regressore o matrice completa dei regressori | Variazione esplicativa osservata |
| β, β̂ | Parametro di popolazione, stima campionaria | Obiettivo rispetto a risultato calcolato |
| u, û | Disturbo strutturale, residuo stimato | Causa non osservabile rispetto a scarto stimato |
| n, T | Osservazioni, periodi temporali | Dimensioni del campione |
| E[·], Var(·) | Aspettativa, varianza | Operazioni probabilistiche sulla popolazione |
| RSS, TSS, ESS | Somme dei quadrati residua, totale e spiegata | Scomposizione della varianza nel campione |
| SE, HC3 | Errore standard, errore standard robusto corretto per la leva statistica | Incertezza campionaria |
| D, Z | Trattamento, strumento | Variabile endogena e variazione esterna |
| αi, λt | Effetti delle unità e del tempo | Componenti non osservate costanti e componenti temporali comuni |
| ρ, φ | Correlazione, coefficiente autoregressivo | Misure di dipendenza |
| λ | Parametro di penalizzazione | Intensità della regolarizzazione |
| ATE, ATT, LATE | Parametri di interesse degli effetti del trattamento | Medie della popolazione, dei trattati e dei compliers |
Letture e documentazione
- Binary-response models
- Binary-response likelihood and marginal effects
- Smearing retransformation
- Heteroskedastic log retransformation
- Weighted least squares
- Mean confidence versus prediction intervals
- HAC covariance
- HAC definitions and implementation
- Anderson–Rubin inference
- Weak-instrument inference
- ADF test specification
- Stationarity and differencing
- Staggered DiD
- Shared folds in glmnet